転移学習との違い
転移学習(transfer learning)は、ある問題で学習したモデルの知識を、別の似た問題に生かす方法の総称です。
Kerasの公式ガイドは、転移学習を、ゼロから大きなモデルを学習させるにはデータが少なすぎる仕事で使う方法と説明しています。
転移学習には、主に「特徴抽出」と「ファインチューニング」の2つのやり方があります。
転移学習の2つのやり方
比べる点 特徴抽出 ファインチューニング 学習済みの部分 固定して動かさない 一部か全部を学習し直す 学習させる部分 新しく足した出力の層だけ 足した層と、学習済みの層 向くとき 新しいデータが少ないとき データが多く、元のデータと似ているとき
TensorFlowのチュートリアルでは、140万枚の画像で学習済みの画像認識のモデル(MobileNet V2)を使い、犬と猫の写真を見分けるモデルを作ります。
学習済みの部分を固定して、新しく足した出力の層(パラメータ1,281個)だけを学習させると、検証用の画像で正解率は約96%になりました。
続けて、学習済みの層の上の方も学習し直すファインチューニングを行うと、正解率は約98%まで上がっています。
チュートリアルは、ファインチューニングでは学習率(1回の学習でパラメータを動かす幅)を小さくしないと、すぐに過学習(学習データにだけ合いすぎること)するおそれがあると注意しています。
画像認識のモデル(畳み込みニューラルネットワーク)の多くでは、入力に近い層ほど、どの画像にも共通する単純な特徴を学び、出力に近い層ほど、元の仕事に特有の特徴を学びます。
そのため、上の方の層だけを学習し直すやり方がよく使われます。
LLMのファインチューニングも、事前学習で身につけた言葉の知識を別の仕事に生かす点で、転移学習の一つです。
教師あり学習などの基本は、機械学習とは で説明しています。
プロンプトエンジニアリング・RAGとの違い
LLMを目的に合わせる方法には、ファインチューニングのほかに、プロンプトエンジニアリングとRAGがあります。
3つは、変えるものが違います。
LLMを目的に合わせる3つの方法
比べる点 プロンプト RAG ファインチューニング 変えるもの AIへの指示 AIに渡す資料 モデルのパラメータ 用意するもの 指示文と例 検索する文書 学習データ 直すとき 指示を書き直す 文書を差し替える 学習し直す 向く目的 まず試す 社内の資料で答える 形式と決まりをそろえる
プロンプトエンジニアリングは、AIへの指示(プロンプト)の書き方を工夫して、望む答えを引き出す方法です。
指示に答えの例をいくつか入れる方法は「few-shot(少数の例を見せる)」と呼ばれます。
RAG(検索拡張生成)は、質問のたびに社内の文書などを検索し、見つけた内容をAIに渡して答えさせる仕組みです。
Googleは、まずプロンプトで最もよい指示を探し、必要ならファインチューニングに進む順を勧めています。
OpenAIも、ファインチューニングの前に結果を評価する仕組みを用意するよう勧め、よくできた例50件で効果が見えなければ、データを足す前に仕事の決め方かプロンプトを見直すよう書いています。
後で紹介する作例では、決まりを書いた指示に例を20件足したプロンプト(約1,400トークン)よりも、100件で学習させたモデルに約50トークンの短い指示を渡したほうが、分類と緊急度の正解が多くなりました。
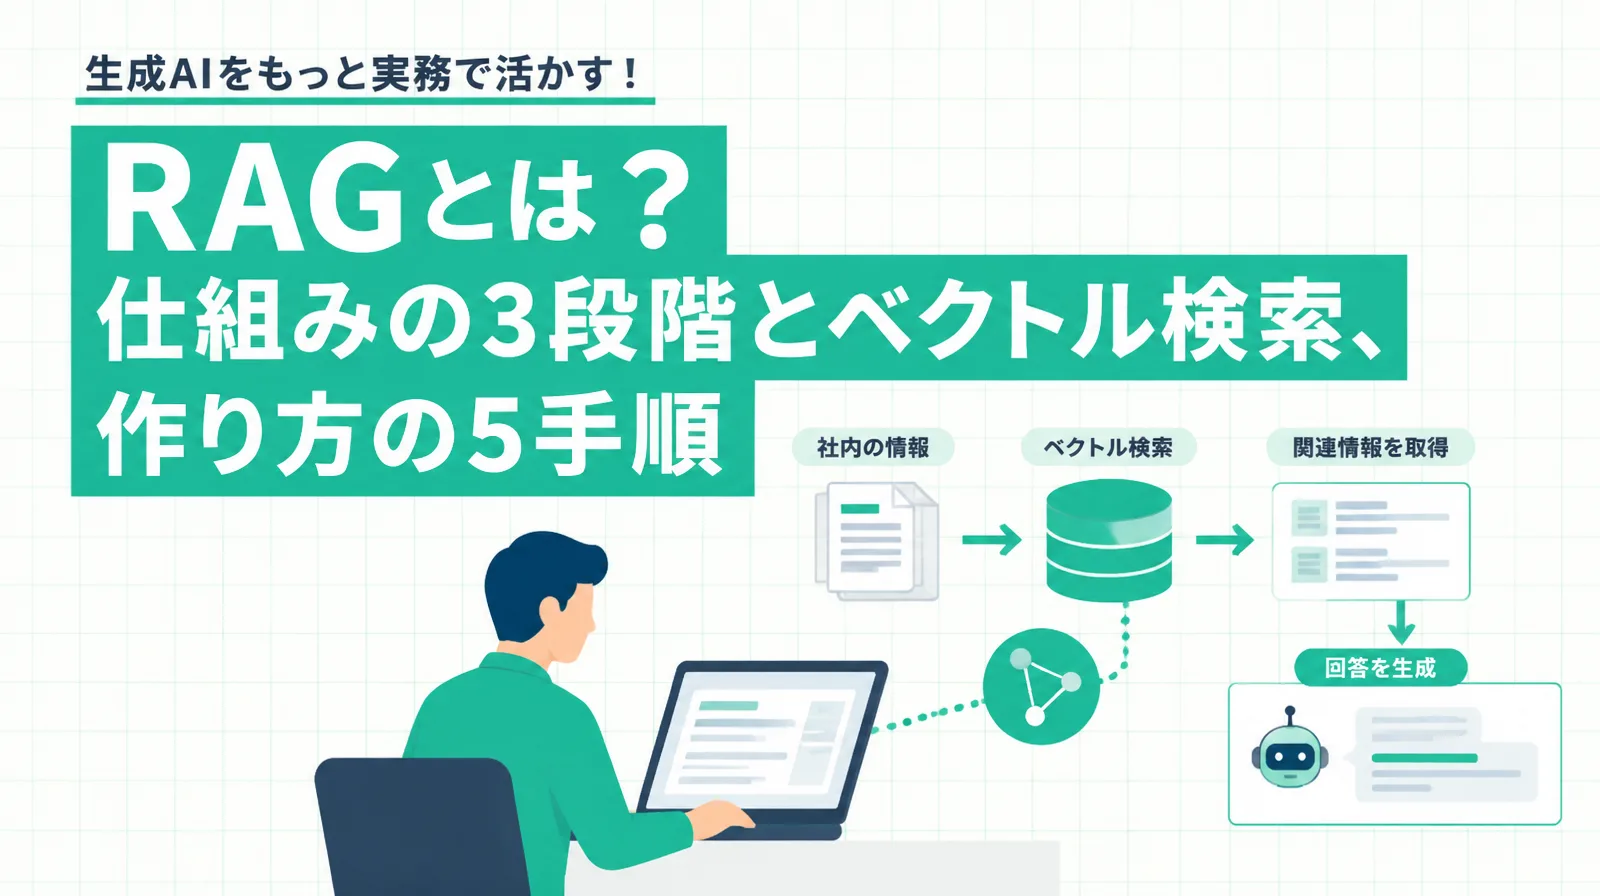
RAGの仕組みと作り方はRAGとは 、プロンプトの書き方はプロンプトとは で紹介しています。
ファインチューニングの種類と手法
ファインチューニングには、パラメータをどこまで動かすか、どんなデータで学習させるかで、いくつかの手法があります。
主な手法と用意するデータ
手法 用意するデータ 変わること SFT 入力と望ましい答えの組 答え方と形式 LoRA・QLoRA SFTなどと同じ 学習させるパラメータが減る RLHF 人が答えを比べた結果 人の好みに近い答え DPO よい答えと悪い答えの組 人の好みに近い答え 蒸留 大きなモデルの答え 小さなモデルが近い答えを返す
フルファインチューニングとLoRA・QLoRA
モデルのすべてのパラメータを学習し直す方法を、フルファインチューニングと呼びます。
Googleは、フルファインチューニングは学習のときも使うときも計算の資源を多く使い、費用が高くなると説明しています。
一部のパラメータだけを学習させる方法は、PEFT(Parameter-Efficient Fine-Tuning)とまとめて呼ばれます。
その代表がLoRA(Low-Rank Adaptation)です。
LoRAは、元のモデルのパラメータを固定したまま、各層に小さな行列を足し、その行列だけを学習させます。
2021年の論文では、1,750億パラメータのGPT-3をふつうに学習させる場合と比べて、学習させるパラメータの数を1万分の1に、GPUのメモリを3分の1にできたと報告しています。
使うときの処理の速さも、元のモデルと変わりません。
学習した行列は「アダプター」と呼ばれる小さなファイルに保存し、元のモデルと組み合わせて使います。
後の作例では、学習させたパラメータは全体の約1.4%、アダプターのファイルは約43MBでした(元のモデルのファイルは約1.7GB)。
QLoRAは、元のモデルを4ビットに縮めて(量子化して)メモリに載せ、LoRAで学習させる方法です。
2023年の論文では、650億パラメータのモデルを、メモリ48GBのGPU1枚で学習させられたと報告しています。
Googleの説明では、QLoRAはLoRAより、ピーク時のGPUメモリの使用量が約75%少なくなります。
その代わり、LoRAのほうが学習は約66%速く、費用は最大40%安くなります。
教師ありファインチューニング(SFT)と指示チューニング
SFT(Supervised Fine-Tuning、教師ありファインチューニング)は、入力と望ましい答えの組を見せて学習させる方法です。
OpenAI、Google Cloud、Microsoft Foundry、Amazon Bedrockのファインチューニングは、どれもSFTに対応しています。
指示と、それに従った答えの例でLLMを学習させ、指示に従って答えられるようにするSFTを、指示チューニング(インストラクションチューニング)と呼びます。
後の作例も、問い合わせと3行の答えの組で学習させたSFTです。
RLHFとは
RLHF(Reinforcement Learning from Human Feedback、人間のフィードバックによる強化学習)は、人が「どちらの答えがよいか」を判断した結果を使い、モデルの答えを人の好みに近づける方法です。
強化学習は、行動の結果に点(報酬)を与え、点が高くなる行動を学ばせる学習の方法です。
RLHFでは、その点を人の判断から作ります。
OpenAIが2022年に発表したInstructGPTの論文では、次の3つの段階でGPT-3を学習させました。
人が書いた望ましい答えの例で、GPT-3をSFTで学習させる
同じ指示へのいくつかの答えを人が比べたデータで、人が好む答えを予測する「報酬モデル」を学習させる
報酬モデルの点が高くなるように、PPOという強化学習の方法で、1のモデルを学習させる
学習データのラベルづけは、約40人の委託の作業者が行いました。
人による評価では、13億パラメータのInstructGPTの答えのほうが、100倍のパラメータを持つ1,750億パラメータのGPT-3の答えよりも好まれたと報告しています。
DPOとRLAIF
RLHFは、報酬モデルを学習させてから強化学習を行うので、手順が多く、学習が不安定になりやすい方法です。
2023年に発表されたDPO(Direct Preference Optimization)は、よい答えと悪い答えの組から、報酬モデルと強化学習を使わずに、ふつうの分類と同じような学習で人の好みを学ばせます。
OpenAIの「Direct preference optimization」、Googleの「preference tuning」、Microsoft FoundryのDPOのように、クラウドのサービスでも使えます。
人の代わりにAIに答えを比べさせる方法は、RLAIF(Reinforcement Learning from AI Feedback)と呼ばれます。
Anthropicが2022年に発表したConstitutional AIでは、人が与えたのは守るべき原則の一覧だけで、答えの比較はAIに行わせました。
蒸留(LLMの蒸留)
蒸留(distillation)は、大きなモデルの答えを使って、小さなモデルを学習させる方法です。
大きなモデルを「教師」、小さなモデルを「生徒」と呼びます。
2015年にHintonらが発表した論文では、いくつものモデルの知識を、使いやすい1つのモデルにまとめられることを示しました。
LLMでは、教師のモデルに質問への答えを作らせ、その質問と答えでSFTを行う形がよく使われます。
OpenAIのガイドも、大きなモデルの答えを集めて、小さなモデルのSFTの学習データにする方法を紹介しています。
Amazon Bedrockの蒸留は、用意した質問に教師のモデルが答えを作り、その答えで生徒のモデルを学習させる仕組みです。
DeepSeekは、推論のモデルDeepSeek-R1が作ったデータで、QwenとLlamaのモデルを学習させた「DeepSeek-R1-Distill」を公開しています。
大きさは15億から700億パラメータまでの6種類で、DeepSeekは、そのうち320億パラメータのモデルがいくつかのベンチマークでOpenAIのo1-miniを上回ったと報告しています。
ほかの会社のモデルの答えを学習データに使うときは、そのサービスの利用規約で、出力を使ってモデルを作ってよいかを確かめます。
LoRAで100件学習させた例
ファインチューニングで何が変わり、何が残るのかを確かめるため、小さなLLMをLoRAで学習させ、学習の前と後、プロンプトに例を見せた場合を比べました。
作例の条件
題材は、架空の会社の社内ITヘルプデスクです。
届いた問い合わせを読み、次の決まりで「分類」「緊急度」「一次回答」の3行で答えるモデルを作ります。
作例の振り分けの決まり
項目 決まり 分類 アカウント、ネットワーク、端末、ソフトウェア、申請の5つ 緊急度 高 業務が止まる、締め切りに間に合わない、複数人に影響、セキュリティの疑い 緊急度 中 トラブルはあるが、回避策で仕事を続けられる 緊急度 低 質問、相談、急がない依頼 社内の決まり アクセス権の相談は「アカウント」。入社と退社の手続き、物品やソフトの購入と貸し出しは「申請」 一次回答 問い合わせた人への1〜2文の返事
作例の条件
項目 内容 モデル Qwen3.5-0.8B(約8億パラメータ、Apache 2.0のライセンスで公開) 学習データ 100件(分類ごとに20件) 評価データ 30件(分類ごとに6件。学習に使っていない問い合わせ) 方法 LoRA(ランク16、すべての線形の層)、3エポック 学習した環境 GPUを使わず、デスクトップPC向けの16コアのCPUだけ 学習の時間 約3分50秒(228.7秒) 学習させたパラメータ 約1,082万個(全体の約1.4%)
学習データは、1件を1行のJSONで書くJSONLの形式で用意しました。
OpenAIやMicrosoft Foundryのファインチューニングと同じ、会話の形(system、user、assistant)です。
学習データの1行:
{"messages": [{"role": "system", "content": "社内ITヘルプデスクの問い合わせを、決まった形式で振り分けてください。"}, {"role": "user", "content": "展示会で使うタブレットを2台、来週の月曜から借りたいです。"}, {"role": "assistant", "content": "分類:申請\n緊急度:低\n一次回答:貸し出しの申請書をお送りします。在庫を確認してご連絡します。"}]} 結果:学習の前と後、例を見せたプロンプトを比べる
評価データの30件で、決まった3行の形式で答えた件数と、分類と緊急度が決まりどおりだった件数を数えました。
学習の前のモデルには、短い指示、決まりを書いた指示、決まりに例を5件か20件足した指示の4通りを渡し、学習の後のモデルには、学習のときと同じ短い指示だけを渡しています。
評価データ30件での結果(指示の長さはトークン数の平均)
条件 指示の長さ 形式どおり 分類 緊急度 両方 学習前・短い指示 51 0件 0件 0件 0件 学習前・決まりを書く 251 15件 19件 14件 11件 学習前・決まり+例5件 520 30件 21件 13件 10件 学習前・決まり+例20件 1,365 30件 25件 18件 18件 学習後・短い指示 51 30件 28件 26件 25件
学習の前のモデルは、短い指示だけでは、指示の文を繰り返したり、見出しのついた長い説明を書き始めたりして、3行の形式で答えた問い合わせはありませんでした。
決まりを書くと半分が形式どおりになり、例を見せると30件すべてが形式どおりになりました。
ただし、緊急度は、例を見せてもあまり当たりませんでした。
学習の前のモデルは、例を20件見せても30件中20件で「中」と答え、決まりにある「締め切り」や「複数人に影響」から「高」を選べなかった問い合わせが残りました。
学習の後のモデルは、約50トークンの短い指示だけで、形式は30件すべて、分類は28件、緊急度は26件が決まりどおりでした。
例を20件見せたプロンプトと比べると、毎回送る指示の長さは約27分の1です。
学習の前と後の答え
「来月の出張で、モバイルルーターを1台借りたいです。」という問い合わせへの答えです。
社内の決まりでは、物品の貸し出しは「申請」、急がない依頼なので緊急度は「低」が正解です。
学習の前(決まり+例5件):
分類:端末
緊急度:中
一次回答:借入期限を指定し、借入条件(例:持ち帰り、持ち帰る)を教えてください。
学習の前(決まり+例20件):
分類:申請
緊急度:中
一次回答:来月の出張日程と借入期限をお知らせください。
学習の後(短い指示):
分類:申請
緊急度:低
一次回答:借り手をお送りします。到着後にご確認ください。
学習の後は、分類と緊急度が社内の決まりどおりになりました。
一方で、一次回答の「借り手をお送りします」のように、意味の通らない言葉が混ざる答えも残っています。
8億パラメータの小さなモデルに100件を学ばせただけでは、形式と区分は身についても、返事の文の質までは上がりきりませんでした。
外れた5件から分かること
学習の後のモデルが外れた5件のうち4件は、緊急度を低く見積もったものでした。
正解が「中」の「認証アプリの通知が届くまで1分ほどかかります」を「低」と答えたほか、正解が「高」の3件も、「知らない場所からのサインインの警告メールが届きました」を「低」、「今日締め切りの集計が進みません」を「中」、「今日の午後の外出までに社用スマホを用意してほしい」を「低」と答えています。
学習データにはセキュリティの疑いの例が2件ありましたが、言い回しの違う警告メールの問い合わせは、正しく判定できませんでした。
残りの1件は、Teamsの画面共有の問い合わせを「ソフトウェア」でなく「アカウント」に分けた、分類の外れでした。
ファインチューニングしたモデルの答えは、学習データにある決まりと言い回しの範囲で安定します。
見落とすと困る区分は、評価データで外れ方を確かめ、同じ決まりの言い回しを変えた例を足して学習し直します。
仕事で使うときは、緊急度の「高」を人が確かめるなど、外れたときの手当てと組み合わせます。
この結果は、この架空のデータと小さなモデルで1回学習させたときのものです。
モデルの大きさ、データの件数、仕事の内容が変われば、差の出方も変わります。
ファインチューニングのやり方(5つの手順)
ファインチューニングは、次の5つの手順で進めます。
作例で使った設定を、それぞれの手順の例として添えます。
1. 目的と評価のしかたを決める
何をそろえたいのか(形式、区分、口調)と、うまくいったかをどう数えるのかを、学習の前に決めます。
作例では、3行の形式で答えた件数と、分類と緊急度の正解の件数を数えました。
同じ評価で、まずプロンプトの工夫だけを試し、足りないところをファインチューニングで補います。
2. データセットを作る
入力と望ましい答えの組を集めます。
形式と件数の目安、作るときの注意は、次の節で説明します。
3. ベースモデルと方法を選ぶ
クラウドのサービスで学習させるか、公開されているモデル(オープンなモデル)を自分で学習させるかを選びます。
すべてのパラメータを学習させるか、LoRAやQLoRAで一部だけを学習させるかも決めます。
作例では、オープンなモデルをLoRAで学習させました。
4. 学習させる
学習には、主に次の設定(ハイパーパラメータ)があります。
エポック数 :学習データを何周学ばせるか。作例は3周。学習率 :1回の学習でパラメータを動かす幅。作例は0.0002。LoRAのランク :LoRAで足す行列の大きさ。大きいほど学習させるパラメータが増える。作例は16。 学習が進むと、学習データに対する間違いの大きさ(損失)が下がります。
作例では、最初の3.57から、最後は0.60まで下がりました。
5. 評価して直す
学習に使っていない評価データで、学習の前と同じ評価をします。
学習データにはよく合うのに、新しい入力では外れる状態を過学習と呼びます。
外れた例を読み、決まりがあいまいならデータの答えをそろえ、足りない言い回しがあれば例を足して、もう一度学習させます。
データセットの作り方
ファインチューニングの結果は、学習データでほとんど決まります。
形式、件数、作るときの注意を順に説明します。
データの形式
多くのサービスとツールは、1件を1行のJSONで書くJSONLのファイルを使います。
主なサービスとツールの学習データの形式
使うもの 形式 OpenAI、Microsoft Foundry JSONL。1行に会話(system、user、assistant) Google(Vertex AI) JSONL。1行に会話(contents)。Cloud Storageに置く Hugging FaceのTRL 会話の形か、prompt と completion の組 DPO 入力と、よい答え・悪い答えの組
DPOのデータは、同じ入力に対するよい答えと悪い答えを1行に並べます。
次はHugging FaceのTRLの形で書いた例です。
{"prompt": "VPNが30分ごとに切れます。", "chosen": "分類:ネットワーク\n緊急度:中\n一次回答:VPNの設定を確認します。切れた時刻をいくつか控えて送ってください。", "rejected": "VPNが切れる原因はいくつか考えられます。まず、次の点を確認してください。"} 件数の目安
必要な件数は仕事によって違いますが、各社は次の目安を示しています。
公式の文書にある件数の目安
サービス 目安 OpenAI 最低10件。50〜100件で改善が見られることが多く、まず50件で試す Google(Vertex AI) まず100件から。必要なら数千件まで増やす Microsoft Foundry 試すときは50〜100件、本番で使うモデルは500件以上
Googleは、データの質は量よりもずっと大事だと書いています。
作例の100件も、分類ごとに同じ件数をそろえ、決まりに沿って答えを書きました。
作るときの注意
決まりを先に文書にする :区分の境目(作例ではアクセス権は「アカウント」、貸し出しは「申請」)を決めてから答えを書く。決まりがぶれると、モデルもぶれる。答えの書き方をそろえる :形式、言葉づかい、長さをそろえる。学習データの答えの書き方が、そのままモデルの答え方になる。本番に近い入力にする :実際に届く問い合わせと同じくらいの長さと言い回しにし、同じ決まりでも言い回しを変えた例を入れる。区分の件数を偏らせない :少ない区分は当たりにくくなる。評価データを分ける :学習に使わないデータを取っておき、学習の前と後を同じデータで比べる。Googleも検証用のデータを用意するよう強く勧めている。個人の情報と機密を外す :問い合わせの履歴などを使うときは、氏名や連絡先などを消してから学習データにする。ほかのモデルの答えを使うときは規約を確かめる :蒸留のように別のAIに答えを作らせるときは、そのサービスの利用規約を確かめる。
理想の1件は、本番と同じ指示、本番に近い入力、そのまま使える答えの3つがそろったものです。
サービス別のやり方
主なサービスとツールで、ファインチューニングができる範囲を紹介します。
ChatGPT(OpenAI)
OpenAIのファインチューニングは、ChatGPTの画面ではなく、開発者向けのAPIの機能です。
学習データのファイルをアップロードし、ベースモデルを指定して学習の処理(ジョブ)を作ります。
OpenAIは、セルフサービスのファインチューニングの提供を、段階的に終えています。
OpenAIのファインチューニングの提供の予定
日付 内容 2026年5月7日 ファインチューニングを使ったことのない組織は、学習を始められなくなった 2026年7月2日 過去60日に、学習したモデルを使っていない組織も、学習を始められなくなった 2027年1月6日 使っている組織も、新しい学習を始められなくなる
学習済みのモデルは、もとになったモデルの提供が終わるまで使えます。
いまの利用者が使える手法は、SFT、画像を入力に含めるSFT、DPOです。
ChatGPTのGPTsやプロジェクトにファイルを入れる機能について、OpenAIは、会話のときに参照する資料として使う仕組みだと説明しています。
モデルのパラメータを学習させるファインチューニングとは別の仕組みです。
OpenAIのAPIキーの取り方は、OpenAI・Gemini・Claude APIの使い方 で紹介しています。
Gemini(Google)
GoogleのGemini APIとGoogle AI Studioには、2025年5月にGemini 1.5 Flash-001の提供が終わってから、ファインチューニングに使えるモデルがありません。
Geminiのファインチューニングは、Google CloudのVertex AI(いまのGemini Enterprise Agent Platform)で行います。
教師ありのチューニングに使えるGeminiのモデルは、Gemini 3.8 Flash、Gemini 3.5 Flash、Gemini 3.5 Flash-Lite、Gemini 3.1 Flash-Lite、Gemini 2.5 Pro、Gemini 2.5 Flash、Gemini 2.5 Flash-Liteです。
学習データはJSONLのファイルにしてCloud Storageに置き、チューニングのジョブを作ります。
Gemini 2.5 Flash系では、よい答えと悪い答えの組で学習させるpreference tuningも使えます。
Vertex AIでは、GemmaやQwenなどのオープンなモデルも、LoRAや蒸留で学習させられます。
Microsoft FoundryとAmazon Bedrock
MicrosoftとAmazonのクラウドでも、ファインチューニングができます。
Microsoft FoundryとAmazon Bedrockのファインチューニング
比べる点 Microsoft Foundry Amazon Bedrock 手法 SFT、DPO、強化学習のファインチューニング SFT、強化学習のファインチューニング、蒸留 モデルの例 GPT-4.1、Llama、Phi、Mistral Amazon Nova、Claude 3 Haiku、Llama
Microsoftは、多くの場合はSFTから始めるよう勧めています。
また、Amazon Bedrockの学習の費用は、学習データのトークン数にエポック数を掛けた量と、モデルを保管する月ごとの料金で決まります。
対応するモデルは、それぞれのサービスの文書の一覧で確かめます。
3つのクラウドのAIのサービスの違いは、Azure OpenAI Serviceとは で比べています。
ローカルLLM
公開されているオープンなモデルは、自分のPCやサーバーで学習させられます。
Hugging Face :モデルを動かすTransformers、LoRAなどを使うPEFT、SFTやDPOを行うTRLのライブラリを組み合わせる。作例もTransformersとPEFTで学習させた。Unsloth :LoRAやQLoRAで学習させるためのツール。デスクトップのアプリ、Webの画面、コードから使え、NVIDIA、AMD、IntelのGPUとMacで学習できる。MLX-LM :Apple製のチップのMacで、LoRA、QLoRA、フルファインチューニングを行うツール。
大きなモデルを学習させるには、GPUのメモリ(VRAM)が要ります。
Unslothの文書にある、最低限のVRAMの目安は次のとおりです。
UnslothのVRAMの目安(最低限の値)
モデルの大きさ QLoRA(4ビット) LoRA(16ビット) 80億(8B) 6GB 22GB 140億(14B) 8.5GB 33GB 320億(32B) 26GB 76GB 700億(70B) 41GB 164GB
作例の8億パラメータのモデルはCPUだけでも約4分で学習できましたが、上の表のとおり、数十億パラメータ以上のモデルではGPUのメモリが要ります。
LM StudioやOllamaは、学習したモデルを手元で動かすときに使います。
LM Studioの公式ブログでは、Unslothで学習させたLoRAのアダプターを元のモデルにまとめ、GGUFという形式に変えてから、lms import のコマンドでLM Studioに取り込む手順を紹介しています。
Ollamaも、Safetensors形式の重みやGGUFのファイルを指定して、モデルを取り込めます。
ローカルLLMの動かし方と必要なPCの性能は、ローカルLLMとは で説明しています。
ファインチューニングのメリットとデメリット
メリット
短い指示で、形式と決まりがそろう :作例では、約50トークンの指示だけで、30件すべてが3行の形式になり、社内の決まりに沿った振り分けが増えた。毎回送る指示が短くなる :決まりや例を毎回プロンプトに書かなくてよくなり、送るトークン数が減る。作例では、例を20件見せたプロンプトの約27分の1だった。小さなモデルでも目的に合わせられる :InstructGPTの13億パラメータのモデルが1,750億パラメータのGPT-3より好まれたように、目的に合わせて学習させた小さなモデルが、大きなモデルに並ぶことがある。
デメリット
データを作り、評価する手間がかかる :決まりに沿って答えをそろえたデータと、評価データが要る。学習の費用がかかる :クラウドでは学習するトークン数に応じて費用がかかり、手元で学習させるならGPUが要る。新しい情報は学習し直さないと入らない :情報が変わるたびにデータを作り直すことになる。変わる情報はRAGで渡す。外れが残る :作例でも、学習の後に5件が外れ、意味の通らない一次回答も混ざった。大事な判断には、人が確かめる仕組みを組み合わせる。もとのモデルの提供に左右される :OpenAIのように、もとになったモデルの提供が終わると、学習させたモデルも使えなくなるサービスがある。オープンなモデルでも、モデルごとのライセンスを確かめる。
ファインチューニングを社内で共有する動画を作る
ファインチューニングやRAGを社内で使い始めるときは、言葉の意味と使い分けを、関わる人と共有しておくと話が早く進みます。
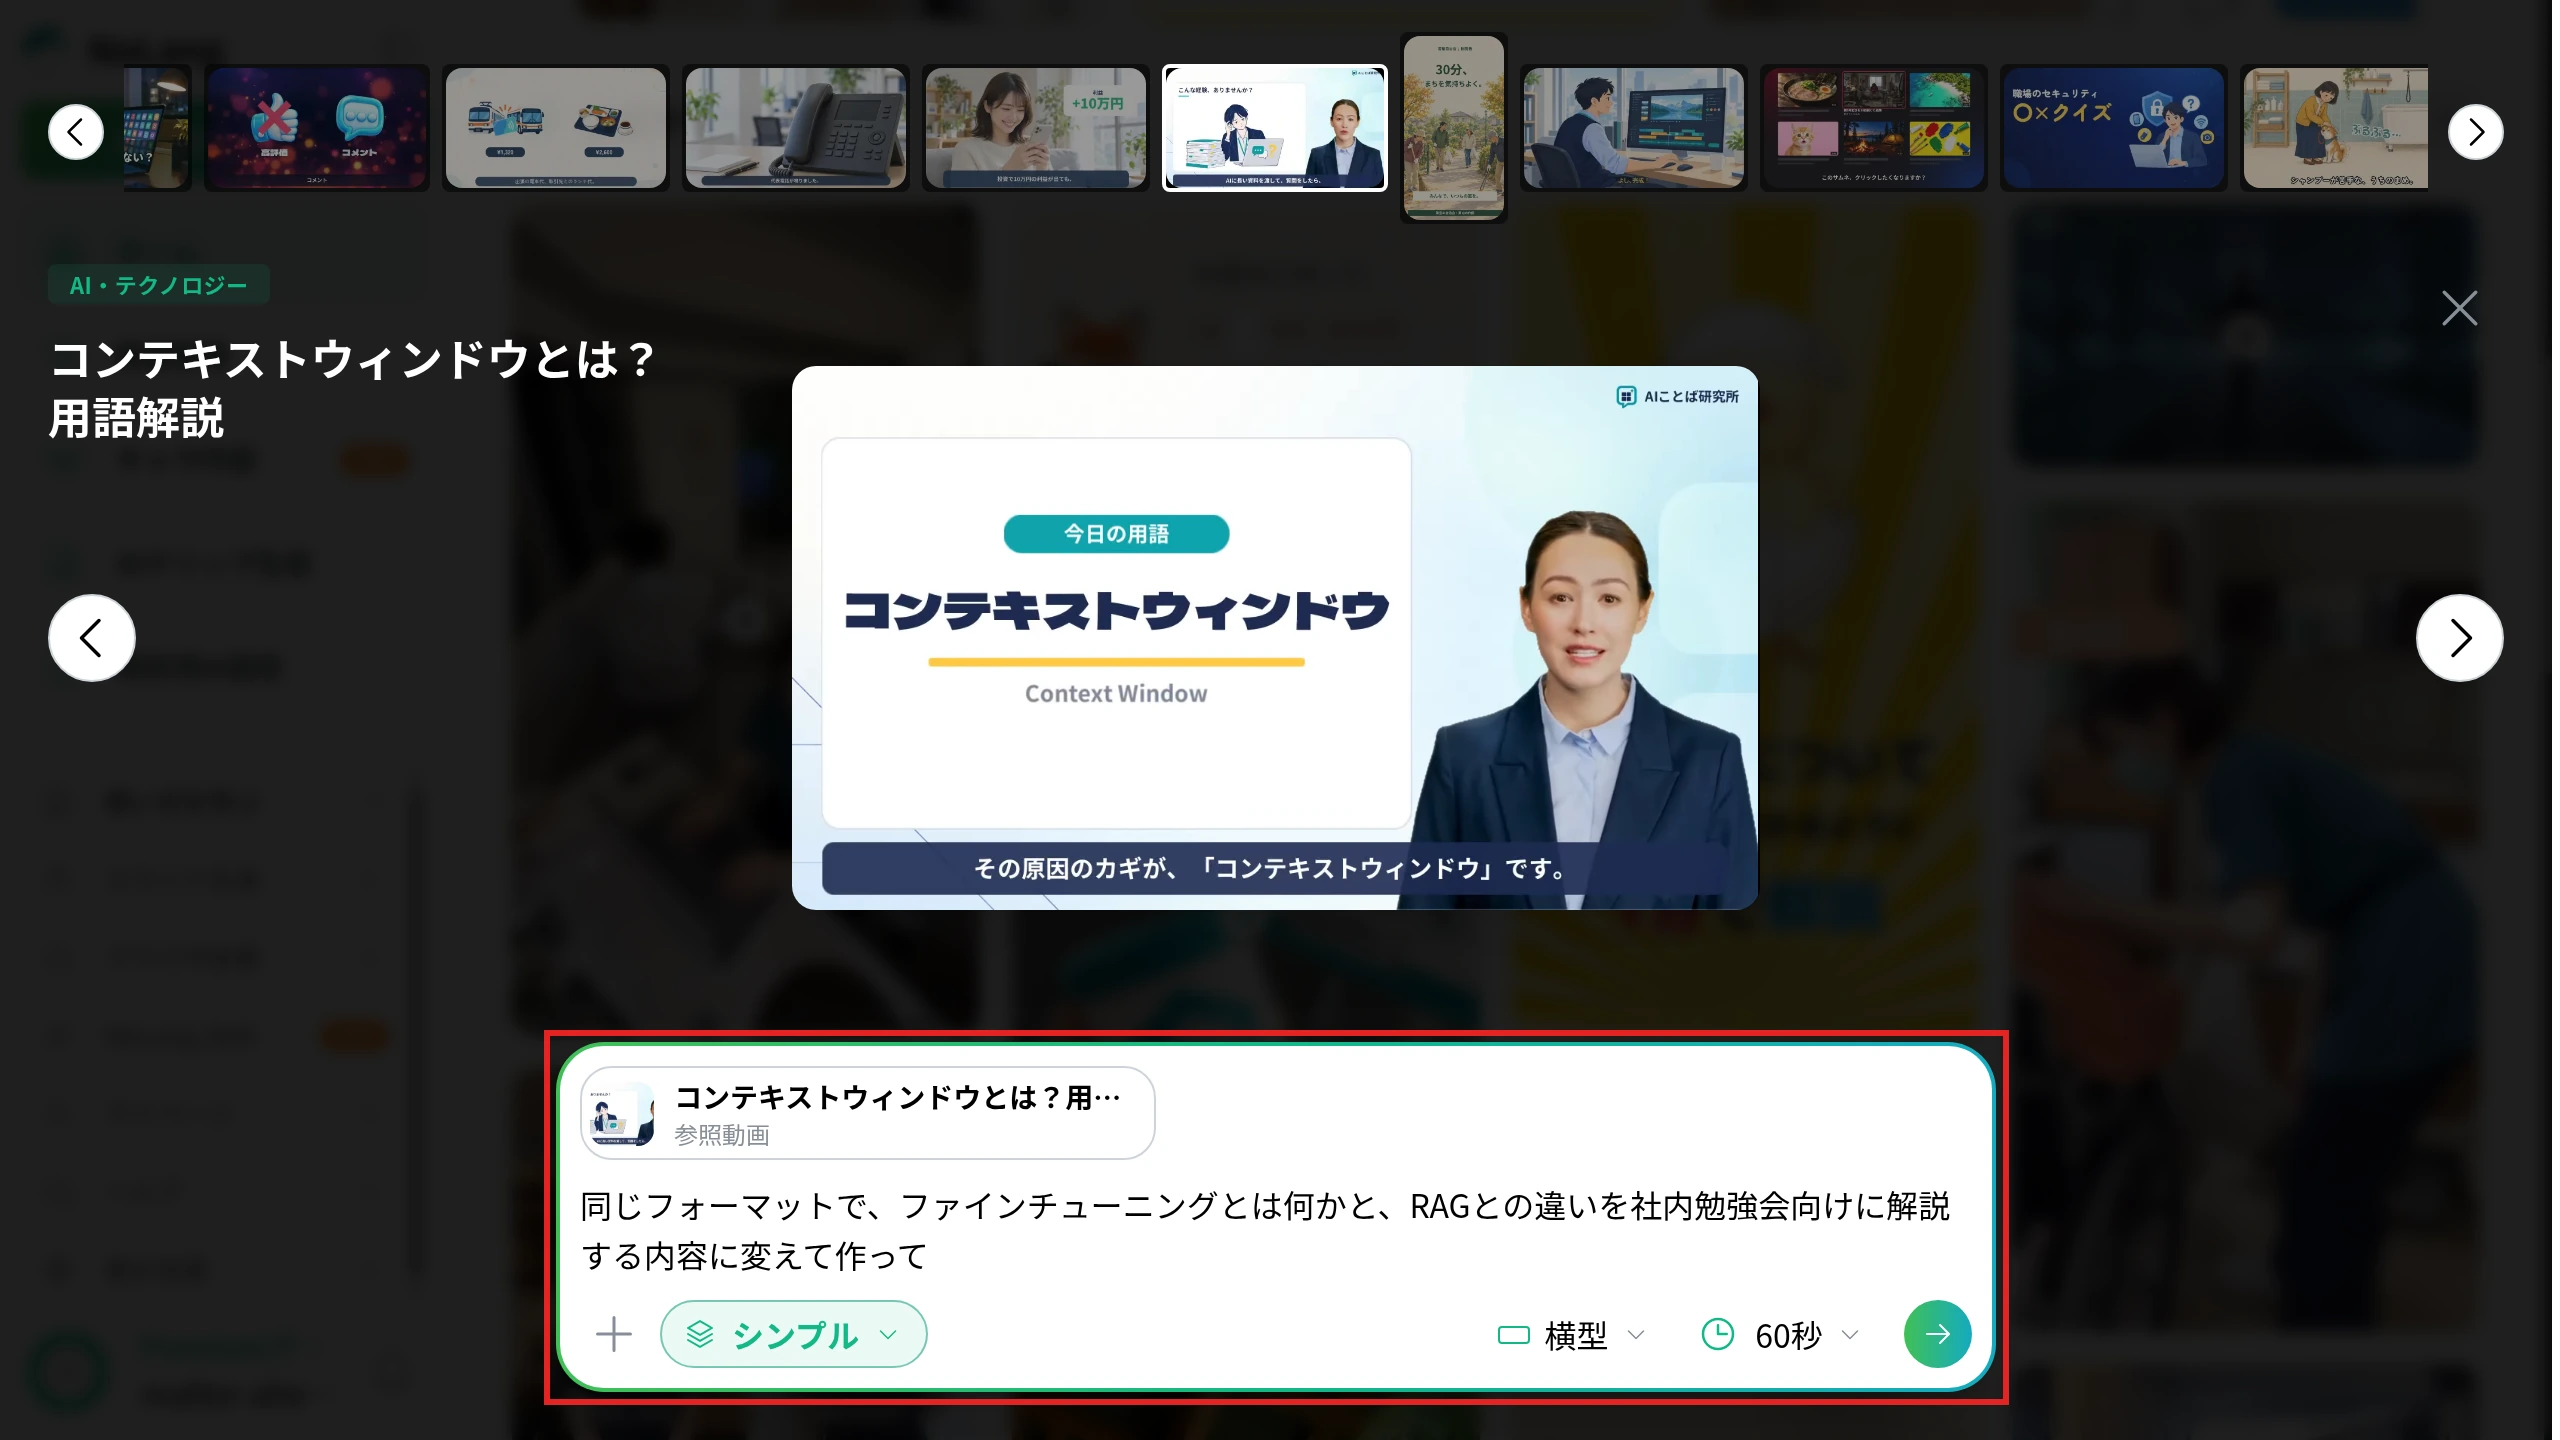
NoLangでは、ホームの公式サンプルにある用語解説の動画をお手本にして、同じ形で別の用語の解説動画を頼めます。
NoLangのホームの公式サンプルで「AI・テクノロジー」のカテゴリを選び、「コンテキストウィンドウとは?用語解説」を開くと、入力欄にその動画が「参照動画」として付きます。
お手本を選んだだけでは生成は始まらないので、入力欄に作りたい内容を書いて送ります。
送ると、お手本の動画の構成や作風をもとに動画が作られます。
入力例:
同じフォーマットで、ファインチューニングとは何かと、RAGとの違いを社内勉強会向けに解説する内容に変えて作って AIの用語の解説を、 社内で共有する動画に
NoLangで動画を作る 会社で使う
社内のAI研修や、新しい用語を説明する勉強会の資料をNoLangで動画にすれば、部署や拠点が違っても同じ説明を届けられます。
研修の動画を会社で作る例は研修動画の作成 で紹介しています。
NoLangを会社で使う方法は法人向けの資料にまとめており、下のボタンからダウンロードできます。
社内の研修や勉強会での使い方を相談したいときは、お問い合わせ のページを使ってください。
資料をダウンロード