Kimi K3は、中国のMoonshot AIが2026年7月に公開した、重みを誰でもダウンロードできる大規模言語モデル(LLM)です。
10月には改良版のKimi K3.1 Proが発表され、11月にその重みも公開されました。
同じように重みを公開するモデルには、AlibabaのQwen、MetaのLlama、GoogleのGemma、DeepSeekのモデルなどがあり、2026年8月にはQwen3.8、11月16日には次の世代のQwen4-Max(APIだけ)が発表されています。
この記事では、主なオープンなLLMの規模、読める長さ、ライセンスを表で比べ、Kimi、Qwen、Llama、Gemmaのそれぞれの違いと選び方を説明します。
内容は、2026年11月16日に各社の公式サイト、モデルカード、ライセンスの全文で確かめたものです。
AIモデルを比べた結果を、 説明動画にして共有しよう
この動画を作る 主なオープンLLMの比較表
主なオープンなLLMの最新のモデルを、規模、一度に読める長さ(コンテキスト)、ライセンスで比べます。
規模の「総/活性」は、モデル全体のパラメータの数と、1つのトークンを処理するときに実際に動くパラメータの数です。
主なオープンLLMの比較(2026年11月16日)
モデル 開発元 総/活性 読める長さ ライセンス Kimi K3.1 Pro Moonshot AI 2.8兆/1,040億 100万 Kimi K3.1-Pro License Qwen3.8-2.4T-A95B Alibaba 2.4兆/950億 約26万(100万まで) Qwen3.8-Max License Qwen3.8-27B Alibaba 270億 約26万(100万まで) Apache 2.0 Llama 4 Maverick Meta 4,000億/170億 100万 Llama 4 Community License Muse Spark Open Meta 8,160億/420億 100万 Muse Model License Gemma 4 31B Google 310億 256K Apache 2.0 DeepSeek-V4-Pro DeepSeek 1.6兆/490億 100万 MIT Mistral Large 4 Mistral AI 1兆/490億 100万 独自のライセンス gpt-oss-120b OpenAI 1,170億/51億 約13万 Apache 2.0
読める長さの単位はトークンです。
「約26万(100万まで)」は、標準で262,144トークンを読め、設定で100万トークンまで広げられることを表します。
活性の欄がないモデルは、すべてのパラメータが毎回動くモデル(Dense)です。
大きいモデルほど高い性能を出しやすい一方で、動かすのに多くのGPUとメモリが要ります。
Kimi K3.1 ProやQwen3.8-2.4T-A95Bはデータセンター向けの大きさで、ふつうはチャットやAPIで使います。
Gemma 4 31Bは、量子化しない重みがNVIDIAのH100(80GB)1基に収まるとGoogleが説明している大きさです。
オープンウェイトとオープンソースの違い
この記事の「オープンなLLM」は、モデルの重み(学習で決まったパラメータ)が公開され、ダウンロードして自分の環境で動かせるモデルを指します。
このようなモデルは「オープンウェイト」とも呼ばれます。
オープンソースの団体OSI(Open Source Initiative)が定めたオープンソースAIの定義では、重みに加えて、学習に使ったデータの詳しい情報と、学習と実行に使ったコードの全体を公開することが条件です。
各社は自分のモデルを「オープンソース」や「オープンモデル」と呼ぶことがありますが、使ってよい範囲はモデルごとのライセンスで決まります。
Kimi K3とは
Kimi K3は、Moonshot AI(月之暗面)が2026年7月16日に発表したモデルです。
Moonshot AIは2023年春に創業し、中国の北京市に本社を置いています。
重みは2026年7月27日からHugging Faceで公開され、Kimi K3 Licenseで使えます。
Kimi K3の主な仕様
項目 内容 パラメータ 総2.8兆、活性1,040億 構成 MoE(896の専門家から16を選ぶ) 読める長さ 1,048,576トークン(約100万) 入力 テキスト、画像 思考 いつも考えてから答える(深さは3段階)
MoE(Mixture of Experts)は、たくさんの「専門家」の小さなネットワークを持ち、入力ごとに一部だけを動かす仕組みです。
Kimi K3はKimi Delta Attention(KDA)とAttention Residualsという仕組みを土台にしていて、Moonshot AIはこれで効率よく規模を大きくできたとしています。
思考の深さは、APIのreasoning_effortでlow、high、maxから選べます。
Moonshot AIは、Kimi K3がコーディング、ツールの利用、推論の評価で最先端の水準の成績を出したとしています。
同時に、技術ブログでは、全体の性能はClaude Fable 5とGPT-5.6 Solという最も強い商用のモデルにまだ及ばないとも書いています。
Kimi K3.1 ProとK3の違い
Kimi K3.1 Proは、2026年10月24日に発表されたK3の改良版で、11月に重みが公開されました。
K3をもとに、数百の分野の課題で強化学習を追加して作られていて、パラメータの数と読める長さはK3と同じです。
Moonshot AIは、コーディング、3Dの作成、金融の調査、事実の正確さなどが良くなったとしています。
Kimi K3とK3.1 Proの違い
項目 Kimi K3 Kimi K3.1 Pro 発表 2026年7月16日 2026年10月24日 総/活性 2.8兆/1,040億 2.8兆/1,040億 注意の層の一部 Gated MLA Gated DSA APIの入力 3ドル 2ドル APIの出力 15ドル 10ドル
APIの料金は100万トークンあたりの金額で、税を含みません。
K3.1 Proには、2〜3倍の速さで答えるK3.1 Pro Highspeed(入力4ドル、出力20ドル)もあります。
いまのAPIのドキュメントは、K3を「前の世代の主力モデル」と呼んでいます。
Kimi K2・K2.5・K2.6との違い
Kimi K3の前のK2の系列は、どれも総1兆、活性320億のモデルです。
K3は総パラメータが2.8倍になり、読める長さはK2.6などの256Kの4倍になりました。
Kimiの主なモデル
モデル 公開 総/活性 読める長さ 入力 Kimi K2 2025年7月 1兆/320億 128K テキスト Kimi K2 Thinking 2025年11月 1兆/320億 256K テキスト Kimi K2.5 2026年1月 1兆/320億 256K 画像も Kimi K2.6 2026年4月 1兆/320億 256K 画像も Kimi K2.7 Code 2026年6月 1兆/320億 256K 画像も Kimi K3 2026年7月 2.8兆/1,040億 100万 画像も
K2 Thinkingは、考えながら200〜300回続けてツールを呼び出せるモデルです。
K2.5から画像を読めるようになり、K2.7 CodeはK2.6をもとにコーディング向けに作られています。
K2の系列のライセンスは、MITライセンスに表示の条件を足したModified MITです。
KimiのAPIでは、K2の系列は2026年10月31日から新しく登録した人には提供されず、2026年12月末までに提供を終える予定です。
検索で見かける「kimi3」「kimi2.5」は、それぞれKimi K3、Kimi K2.5のことです。
Kimi K3の使い方
Kimi K3は、Webのチャット、スマホのアプリ、デスクトップのアプリ、ターミナルのKimi Code、APIで使えます。
日本語の画面は、Kimiの国際版のサイト(kimi.ai/ja)で開けます。
ブラウザでkimi.ai/ja を開きます。
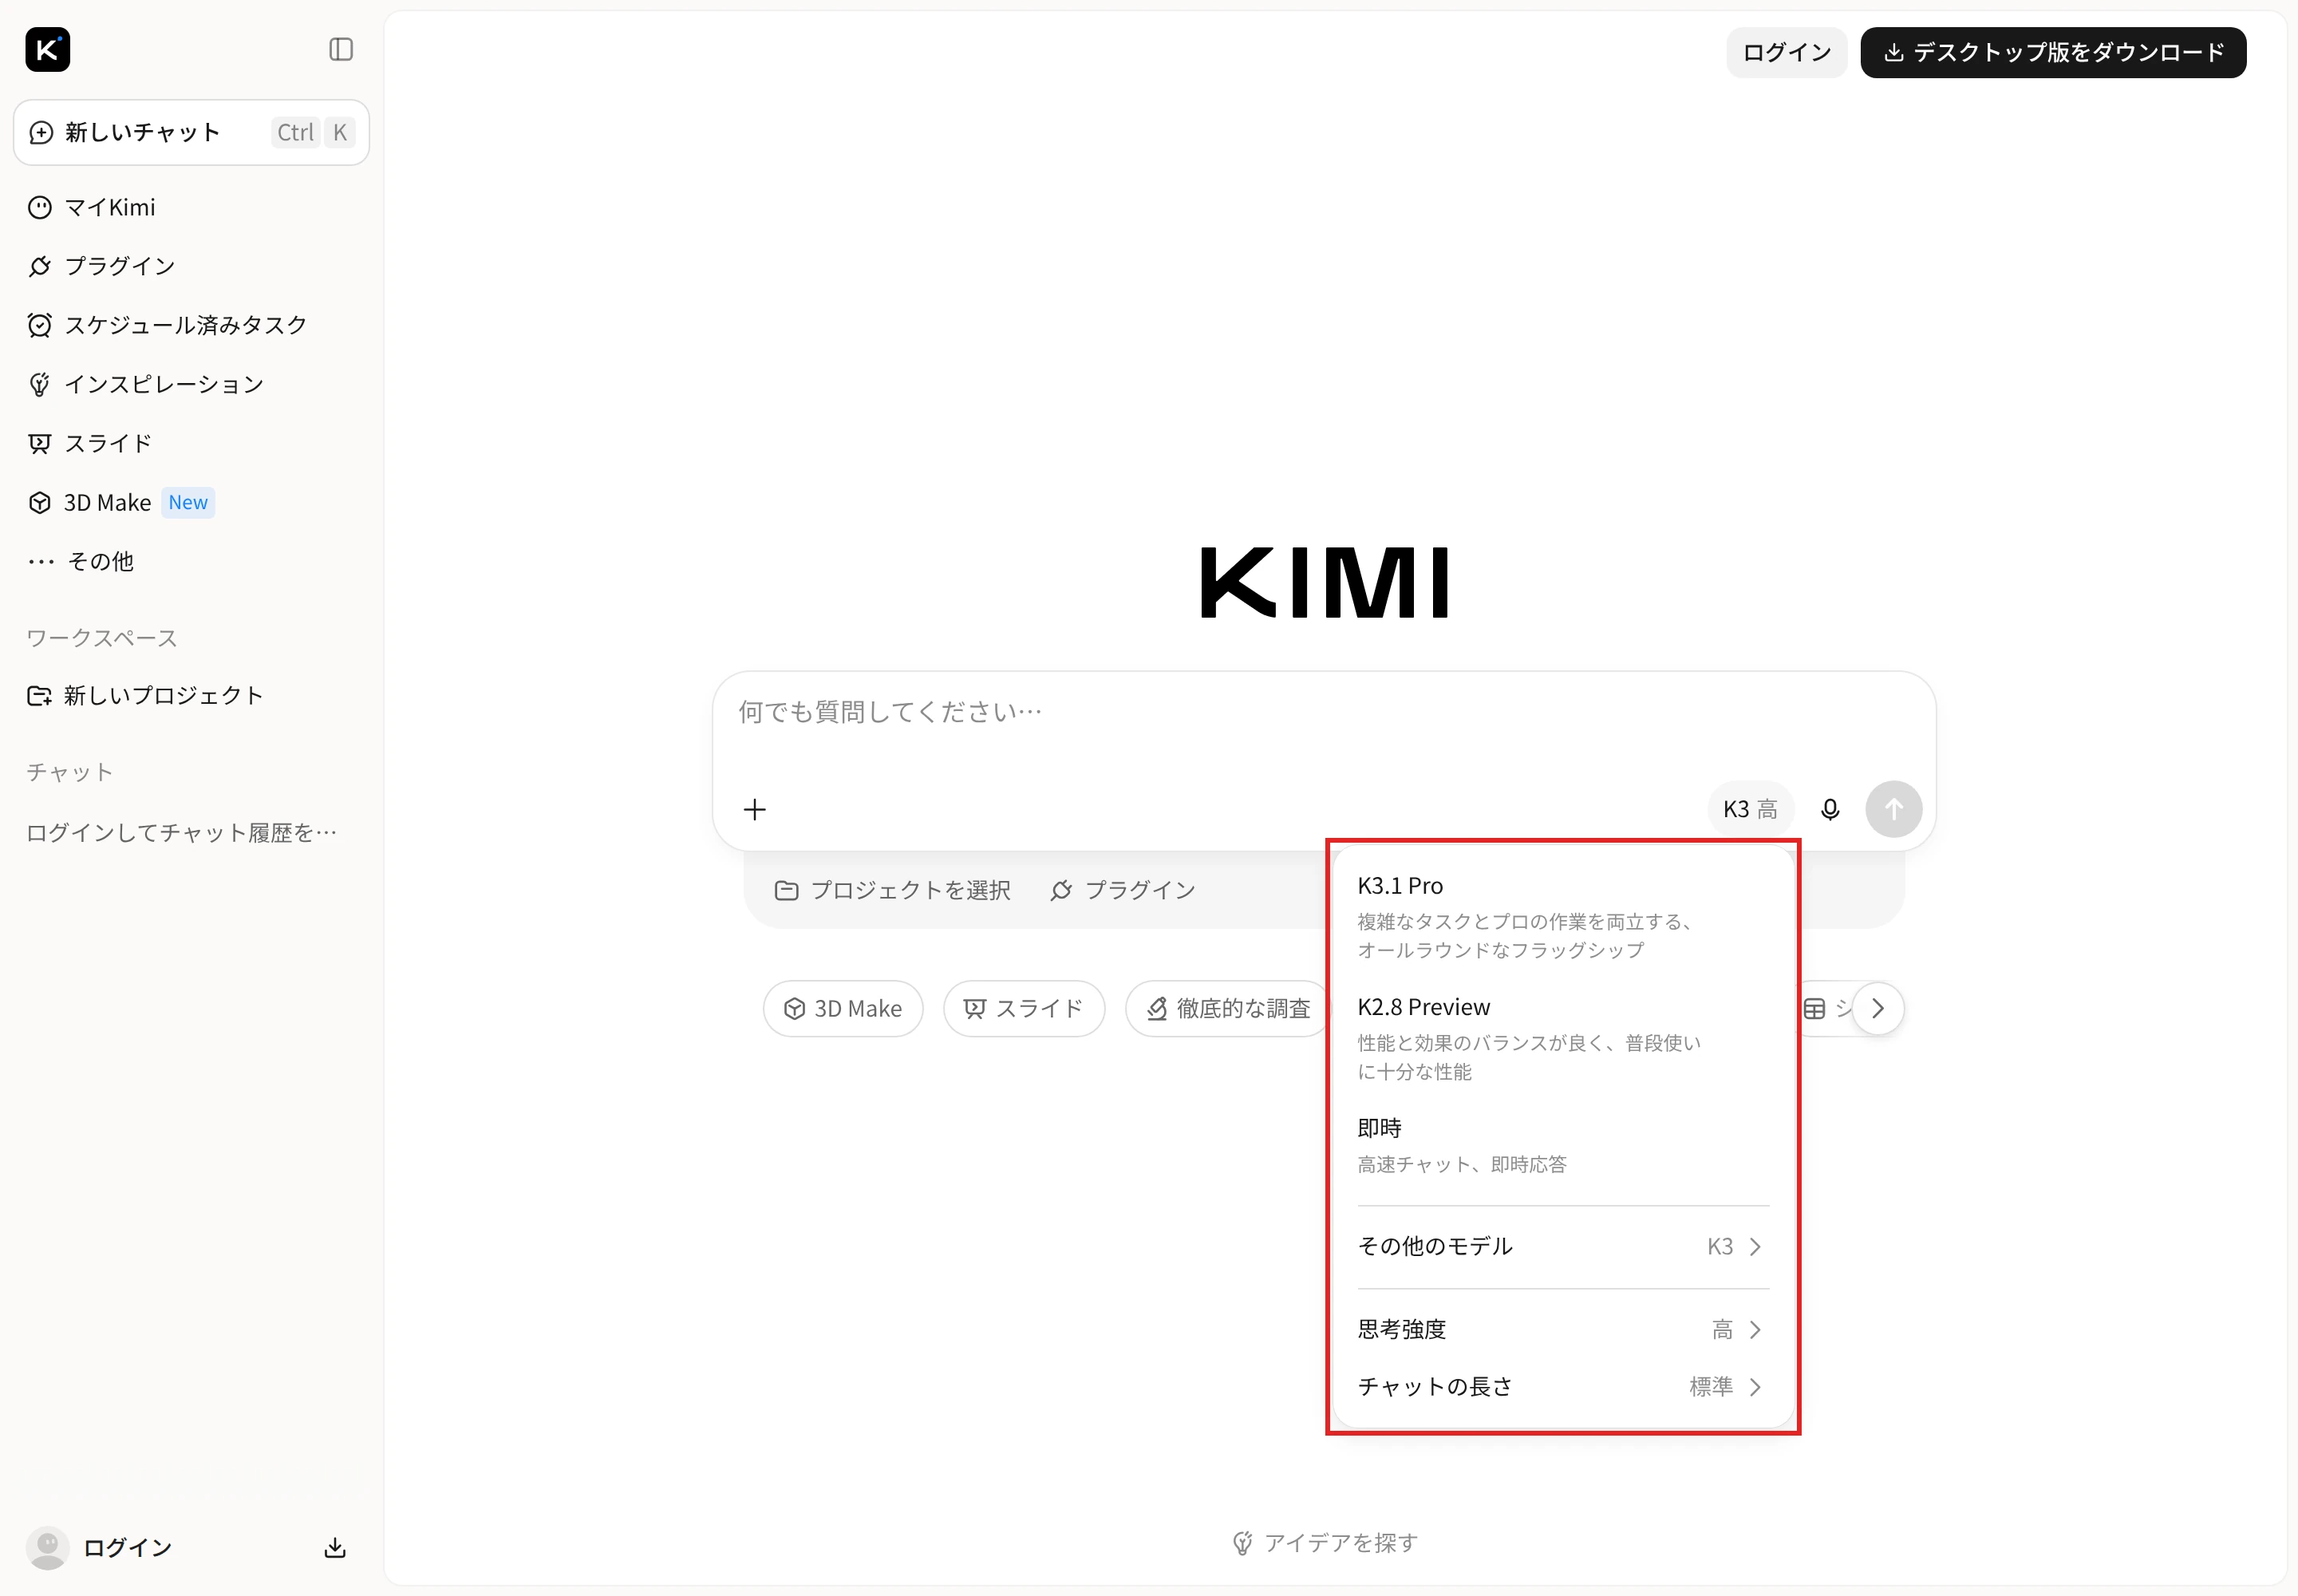
入力欄の右下にあるモデルの名前(「K3 高」など)を押し、モデルの一覧を開きます。
「K3.1 Pro」か、「その他のモデル」の「K3」を選びます。
一覧には、普段使いに向くとされる「K2.8 Preview」や、すぐに答える「即時」も並びます。
「思考強度」では、考える深さを選べます。
スマホのアプリはiOSとAndroid向けに、デスクトップのアプリ「Kimi Work」はWindowsとAppleシリコンのMac向けに提供されています。
チャットの履歴を同期するには、ログインします。
個人向けのプランには、無料のFreeと、有料のPlus、Pro、Max、Ultraがあります。
開発者向けのKimi Codeは、Plus以上のプランで使えます。
自分のアプリに組み込むときは、KimiのAPIで、使ったトークンの量に応じて払います。
Kimi K3をローカルで動かすには
Kimi K3の重みは、Hugging Faceのファイルの大きさで約1.56TBあります。
重みは4ビットの形式(MXFP4)で配られていて、公式のモデルカードは、推論のエンジンにvLLM、SGLang、TokenSpeedを勧めています。
vLLMの手順書は、NVIDIAのB300を8基使う構成を既定の例にしています。
重みだけで約1.56TBあるので、手元のPCで試すなら、後で説明するQwen3.5-9BやGemma 4のような小さいモデルが向いています。
Kimi K3のデータの扱い
日本から使う国際版のKimi(kimi.ai)は、プライバシーポリシーでNOVASCENT PRIVATE LIMITEDを提供者としています。
このポリシーには、入力した文章、画像、ファイルをサービスの提供と改善に使い、AIのモデルの学習にも使うことがあると書かれています。
情報が、国外のサーバーに送られて保存されることがあるとも書かれています。
会社の情報を扱うときは、社内のルールに照らして、チャットに入れてよい内容かを確かめます。
重みを自分のサーバーで動かせば、入力をKimiのサービスに送らずに使えます。
APIには、会社向けに、入力を保存しないZero Data Retentionの扱いも用意されています。
Qwenのモデルの違い
Qwenは、中国のAlibaba(阿里巴巴)のQwenのチームが作るモデルの系列です。
世代ごとに、重みを公開するモデルとAPIだけで使うモデルがあります。
Qwenの世代と、重みを公開したモデル
世代 発表 重みを公開したモデル ライセンス Qwen2.5 2024年9月 0.5B〜72B、Coder 多くはApache 2.0 Qwen3 2025年4月 0.6B〜235B-A22B Apache 2.0 Qwen3.5 2026年2〜3月 0.8B〜397B-A17B Apache 2.0 Qwen3.6 2026年4月 27B、35B-A3B Apache 2.0 Qwen3.7 2026年5月 なし(APIだけ) なし Qwen3.8 2026年8月 27B、2.4T-A95B、Flash-Next モデルごとに違う Qwen4 2026年11月 なし(APIだけ) なし
名前の「27B」は270億パラメータを表します。
「397B-A17B」は、総3,970億パラメータのうち170億が動くMoEのモデルという意味です。
Qwen3では対応言語に日本語が挙がっていて、Qwen3.5で対応する言語と方言は201に増えました。
Qwen3.5からは、モデル本体が画像と動画を読めます。
Qwen3.8とQwen3.8-27B
Qwen3.8は、2026年8月3日にAPIのQwen3.8-Maxとして発表されました。
Qwenとして初めて、Max級のモデルの重みも公開され、Qwen3.8-2.4T-A95Bという名前でHugging Faceに置かれています。
2.4T-A95Bは総2.4兆、活性950億のテキスト専用のモデルで、いつも考えてから答えます。
Qwen3.8-27Bは、同じ8月に重みが公開された270億パラメータのモデルです。
画像と動画を読め、考えるモードは初めから有効で、問い合わせごとに無効にできます。
ライセンスはApache 2.0で、商用にも使えます。
Ollamaのライブラリでは、27Bのファイルの大きさは18GBです。
Qwen3.8-Flash-Next
Qwen3.8-Flash-Nextは、2026年8月に重みが公開された試験的なモデルで、Qwen4で使う構造を先に公開したものです。
総1,250億パラメータのうち60億が動くMoEで、画像と動画を読めます。
ライセンスはApache 2.0ではなくQwen Community License 1.0で、AIのモデルを外部に提供する事業や、AIの業務アシスタントの事業で商用に使うときは、Qwenと別の契約が要ります。
APIでは、Flash-Nextをもとに機能を足したQwen3.8-Flashが提供されています。
料金は100万トークンあたり入力0.15ドル、出力0.47ドルです。
Qwen3.6-27BとQwen3.5-9B
Qwen3.6-27Bは、2026年4月22日に重みが公開された270億パラメータのモデルです。
Qwenは、コーディングの主な評価で、前の世代の最大のモデルQwen3.5-397B-A17Bを上回ったとしています。
Qwen3.5-9Bは、2026年3月に公開された90億パラメータのモデルで、画像と動画も読めます。
Ollamaのライブラリでのファイルの大きさは6.6〜7.6GBです。
Qwen3.5には、さらに小さい0.8B、2B、4Bもあります。
どちらもApache 2.0で、標準で262,144トークンを読めます。
Qwen4はいつ出るか
Qwen4は、2026年11月16日にQwen4-Maxとして発表されました。
総2.4兆パラメータのうち710億が動き、画像と動画を読め、100万トークンを読めます。
いまはAPIで使え、料金は100万トークンあたり入力1.5ドル、出力4.5ドルで、Qwen3.8-Maxより下がりました。
Qwen4の重みはまだ公開されていません。
Qwenは発表の中で、Qwen4の小さいモデルを今後オープンにすると書いていますが、時期と大きさは示していません。
Qwen3-VLとQwen Coder
Qwen3-VLは、2025年9月から10月にかけて順に公開された、画像と動画を読む専用のモデルです。
2Bから235B-A22Bまでの大きさがあり、Apache 2.0で使えます。
Qwen3.5からは本体のモデルが画像と動画を読めるようになり、QwenはQwen3.5がQwen3-VLを上回ったとしています。
Qwen Coderは、コーディング向けのモデルの系列です。
Qwen2.5-Coder(2024年)、Qwen3-Coder(2025年7月、総4,800億)、Qwen3-Coder-Next(2026年2月、総800億、活性30億)が公開されていて、どれもApache 2.0です。
ターミナルで使うツールのQwen Codeは、これとは別のものです。
Qwen Chatで試す
Qwenのモデルは、ブラウザのQwen Chat(chat.qwen.ai)で試せます。
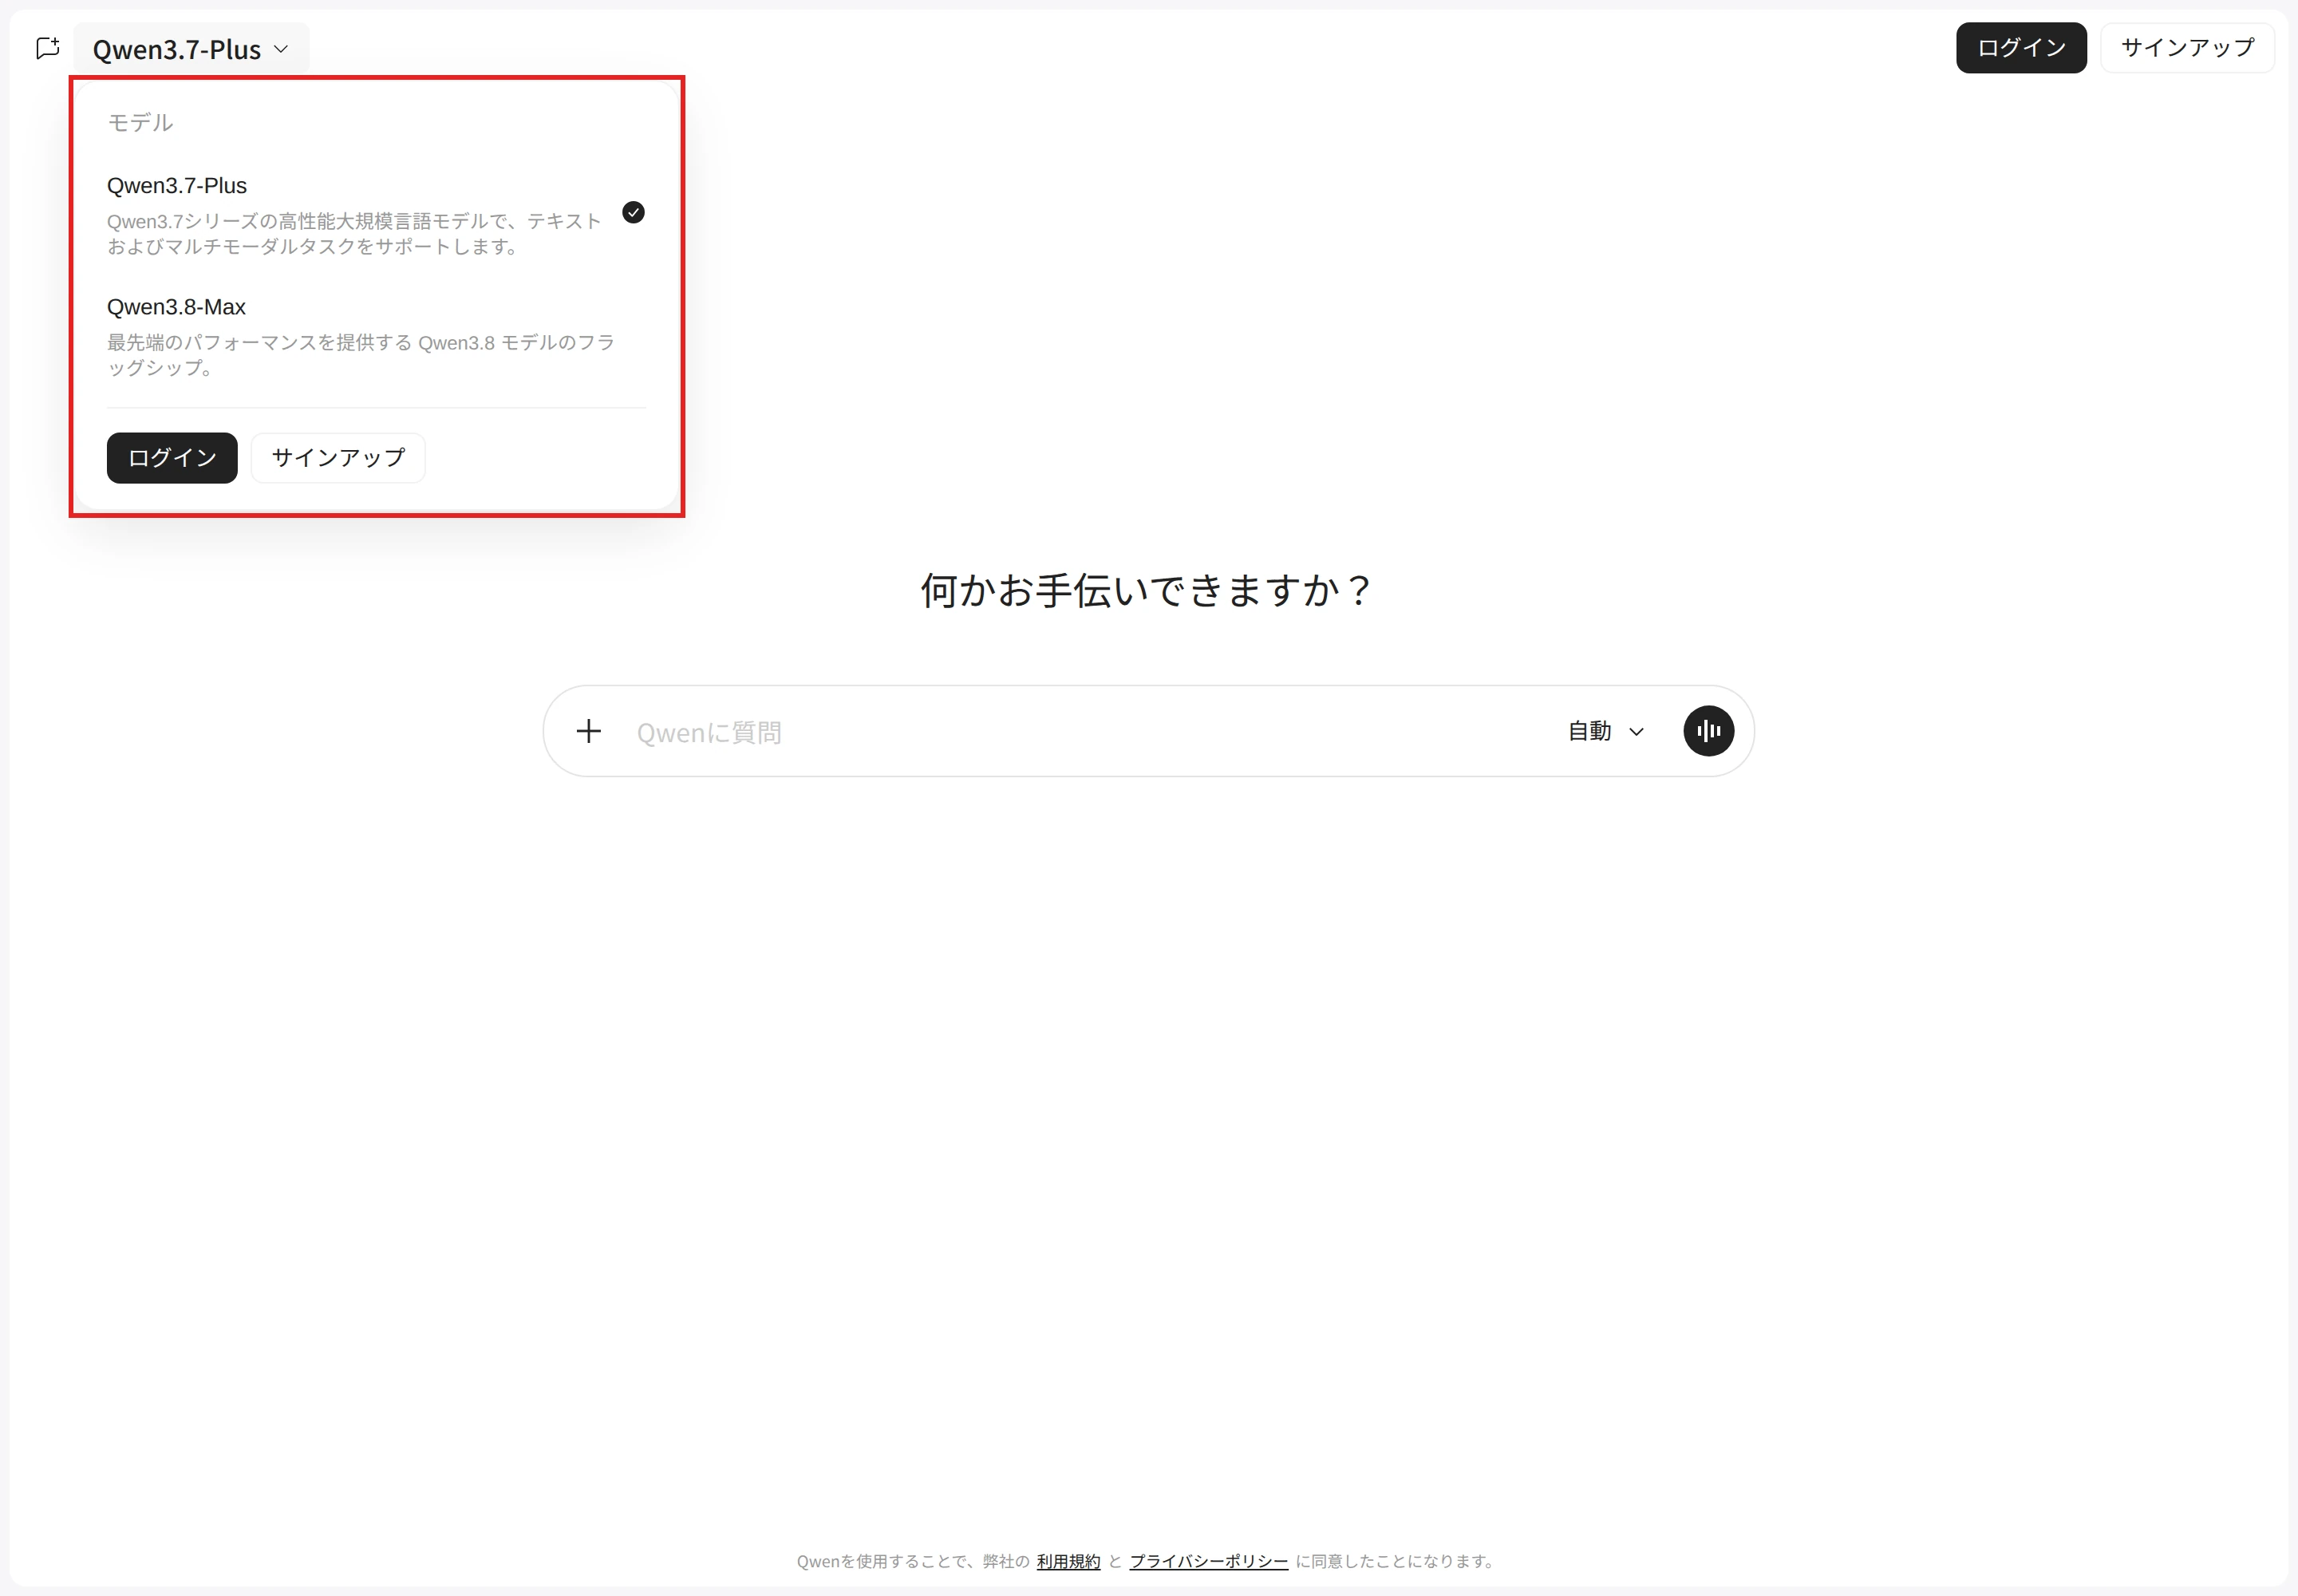
画面の左上のモデルの名前を押すと、モデルの一覧が開きます。
ログインしないで開いたときの一覧には、初めに選ばれているQwen3.7-Plusと、Qwen3.8-Maxが出ます。
画面は日本語で表示され、iPhoneとAndroidのアプリもあります。
Qwen Chatは、シンガポールの会社NTH POWER GLOBAL TECH SINGAPOREが運営しています。
プライバシーポリシーによると、入力はAlibaba Cloudのシンガポールの会社に送られてシンガポールで処理され、答えを作り終えると速やかに消され、別に保存されません。
Llama 4の特徴と、その後のMeta
Llama 4は、Metaが2025年4月5日に公開したモデルです。
重みを公開したのは、ScoutとMaverickの2つです。
Llama 4のモデル
モデル 総/活性 専門家 読める長さ Llama 4 Scout 1,090億/170億 16 1,000万 Llama 4 Maverick 4,000億/170億 128 100万
どちらもテキストと画像を読め、Scoutは1,000万トークンを読めます。
Llamaとして初めてMoEの仕組みを採り入れたモデルです。
200の言語で学習していますが、モデルカードが挙げる12の対応言語に日本語は入っていません。
ライセンスはLlama 4 Community Licenseで、商用にも使えます。
ただし、公開の時点で月に7億人を超える利用者がいるサービスを運営する会社は、Metaの許可が必要です。
Llama 4を組み込んだ製品やサービスを提供するときは、「Built with Llama」と目立つように表示します。
利用の方針では、EUに住む個人とEUに主な事業所を置く会社には、マルチモーダルのモデルを使う権利が与えられていません(そのモデルを組み込んだ製品の利用者は除きます)。
Llamaの公式サイトのモデルの一覧にある最新のLlamaは、いまもLlama 4です。
2026年のMetaの新しいモデルは「Muse」という名前で出ています。
Muse Spark (2026年4月):Meta AIのアプリとmeta.aiで使えるモデルMuse Glimmer (2026年8月):300億パラメータで、Apache 2.0で重みを公開Muse Spark Open (2026年10月15日):総8,160億、活性420億で100万トークンを読め、Muse Model Licenseで重みを公開
Muse Spark Openのライセンスでは、製品に「Built with Muse Spark Open」と表示し、AIのモデルを外部に提供する事業で12か月の売上が2,000万ドルを超えると、Metaとの別の契約が要ります。
GemmaとGeminiの違い
Gemmaは、Googleが重みを公開しているオープンなモデルです。
Geminiは、GoogleのGeminiのアプリ、Gemini API、Google AI Studioなどで使うモデルです。
Googleは、Gemma 4をGemini 3と同じ研究と技術から作ったとし、オープンなGemmaと独自のGeminiを組み合わせて使えると説明しています。
GemmaとGeminiの違い
項目 Gemma Gemini 提供の形 重みを公開 アプリ、API、AI Studio 動かす場所 自分のPC、サーバー、スマホ Googleのサービスの中 最新 Gemma 4(2026年4月) Gemini 4 Hydrogen(2026年11月) 料金 重みは無料(Apache 2.0) アプリのプランやAPIの料金
Gemma 4は、E2B、E4B、12B、26B A4B、31Bの5つの大きさがあります。
E2BとE4Bはスマホや小さな機器でもネットにつながずに動かせる大きさで、音声も入力できます。
12Bは2026年6月に加わり、Googleはノートパソコンで動かすことを想定したモデルとしています。
読める長さは、E2BとE4Bが128K、それより大きいモデルが256Kトークンです。
学習には140以上の言語が使われています。
Gemma 4からライセンスがApache 2.0になり、商用にも使いやすくなりました。
Gemma 3までのモデルには、Google独自のGemma Terms of Useが適用されます。
Geminiの無料版と有料のプランの違いは、Geminiの料金の記事 で詳しく比べています。
ほかのオープンなモデル
DeepSeek、Mistral AI、OpenAIも、重みを公開したモデルを出しています。
DeepSeek V4 :DeepSeekのモデルです。DeepSeek-V4-Proは総1.6兆、活性490億で、100万トークンを読めます。2026年9月には総5,520億のDeepSeek-V4.1-Flashも公開され、10月に更新されました。どちらもMITライセンスです。Mistral Large 4 :Mistral AIが2026年10月に重みを公開した、総1兆、活性490億のモデルで、テキストと画像を読めます。ライセンスはMITを変えた独自のもので、AIのモデルを外部に提供する事業で商用に使うときは、Mistralとの別の契約が要ります。gpt-oss :OpenAIが2025年8月に公開したモデルです。gpt-oss-120b(総1,170億、活性51億)とgpt-oss-20b(総210億、活性36億)があり、Apache 2.0で使えます。 商用で使うときに確かめるライセンスの条件
オープンなモデルを自社の製品やサービスに使うときは、モデルごとのライセンスの条件を確かめます。
主な条件を表にまとめます。
ライセンスごとの主な条件
ライセンス 主なモデル 確かめる条件 Apache 2.0 Qwen3.8-27B、Gemma 4、gpt-oss ライセンスの写しと表示を残す MIT DeepSeek V4 著作権の表示を残す Kimi K3 License Kimi K3 売上と利用者の数の条件、表示 Kimi K3.1-Pro License Kimi K3.1 Pro 売上と利用者の数の条件、表示 Llama 4 Community License Llama 4 月7億人の条件、表示、EU Qwen3.8-Max License Qwen3.8-2.4T-A95B 売上と利用者の数の条件、表示 Qwen Community License Qwen3.8-Flash-Next 提供の事業は別の契約
Kimi K3 LicenseとKimi K3.1-Pro Licenseは、表示するモデルの名前のほかは同じ条文です。
どちらも、AIのモデルをAPIなどで外部に提供する事業を営み、会社のグループの12か月の売上が2,000万ドルを超えると、商用に使う前にMoonshot AIとの別の契約が要ります。
月に1億人を超える利用者がいるか、月の売上が2,000万ドルを超える製品では、画面にモデルの名前を表示します(K3は「Kimi K3」、K3.1 Proは「Kimi K3.1-Pro」)。
社内だけで使うときと、Kimiの公式の製品を通して使うときは、これらの条件は適用されません。
Qwen3.8-Max Licenseは、AIのモデルを提供する事業やAIの業務アシスタントの事業で、12か月の売上が5,000万ドルを超えると、Qwenとの別の契約が要ります。
チャットやAPIでモデルを使うときは、ライセンスとは別に、各サービスの利用規約に従います。
目的別の選び方
何に使うかで、選ぶモデルが変わります。
まずブラウザで試す :KimiはKimiのサイト(kimi.ai/ja)、QwenはQwen Chat(chat.qwen.ai)で、最新の大きなモデルを試せます。手元のPCで動かす :Qwen3.5-9B、Gemma 4のE4Bや12Bのような小さいモデルから始めます。Qwen3.8-27BのOllamaのファイルは18GBです。自社のサービスに組み込む :条件の少ないApache 2.0やMITのモデル(Qwen3.8-27B、Gemma 4、gpt-oss、DeepSeek V4)が使いやすく、KimiやLlama 4を使う場合は売上と利用者の数の条件を確かめます。長い資料を読ませる :Llama 4 Scoutは1,000万トークン、Kimi K3.1 Pro、DeepSeek-V4-Pro、Mistral Large 4は100万トークンを読めます。日本語で使う :Qwenは対応言語に日本語を挙げています。Llama 4は、対応言語の一覧に日本語が入っていません。
ChatGPT、Gemini、Claudeのような重みを公開しないサービスも含めて用途ごとに選ぶときは、生成AIのおすすめの記事 で比べています。
比べた結果を動画で共有する
次の動画は、この記事で確かめた比較をまとめた資料をもとに、NoLangで作った作例です。
動画は約3分24秒で、「どれを選ぶ?」という問いから始まります。
6つのモデルを紹介した後、規模、一度に読める量、ライセンスの3つの物差しで順に比べます。
規模は横の棒の長さで、ライセンスは「条件が少ない」と「条件を確かめる」の2つに分けて見せ、最後に目的ごとの選び方をまとめています。
テンプレートから作るときは、比べたいモデルやサービスと、伝えたい違いをプロンプトに書きます。
比べた結果を、 社内に動画で伝えよう
NoLangで動画を作る 会社で使うとき
会社で使うAIのモデルを比べて決めたら、その結果や使うときのルールを、NoLangで説明動画にして社員に伝えられます。
NoLangは、社内の資料のPDFやPowerPoint、手順の文章から、ナレーションと字幕の入った動画を作ります。
会社での使い方の相談は、お問い合わせ で受け付けています。
詳しい資料は、下のボタンからダウンロードできます。
資料をダウンロード