Kaggleとは
Kaggleは、企業や研究機関などが出す課題に、世界の参加者がモデルを作って取り組み、結果を競うサイトです。
Kaggleのトップページには、5万3,000を超えるモデル、78万7,000のデータセット、190万の公開のノートブックがあると表示されています。
Kaggleでできること
Kaggleには、コンペのほかに、データ、モデル、コードを共有する機能と、学ぶためのコースがあります。
Kaggleの主な機能
機能 できること Competitions コンペに参加し、予測などを提出して順位を競う Datasets データセットを探して使い、自分のデータを公開する Models 機械学習と生成AIのモデルを探し、使い、共有する Code(Notebooks) ブラウザから使えるクラウドの環境で、コードを動かして公開する Discussions コンペやデータについて質問し、話し合う Learn 無料のコースで、Pythonや機械学習の基本を学ぶ
Kaggle Notebooksでは、PythonとRのスクリプト、Jupyter Notebook、RMarkdownを使えます。
コンペのページのDiscussionsには、データ、評価の指標、解き方についての書き込みが集まっています。
コンペの区分
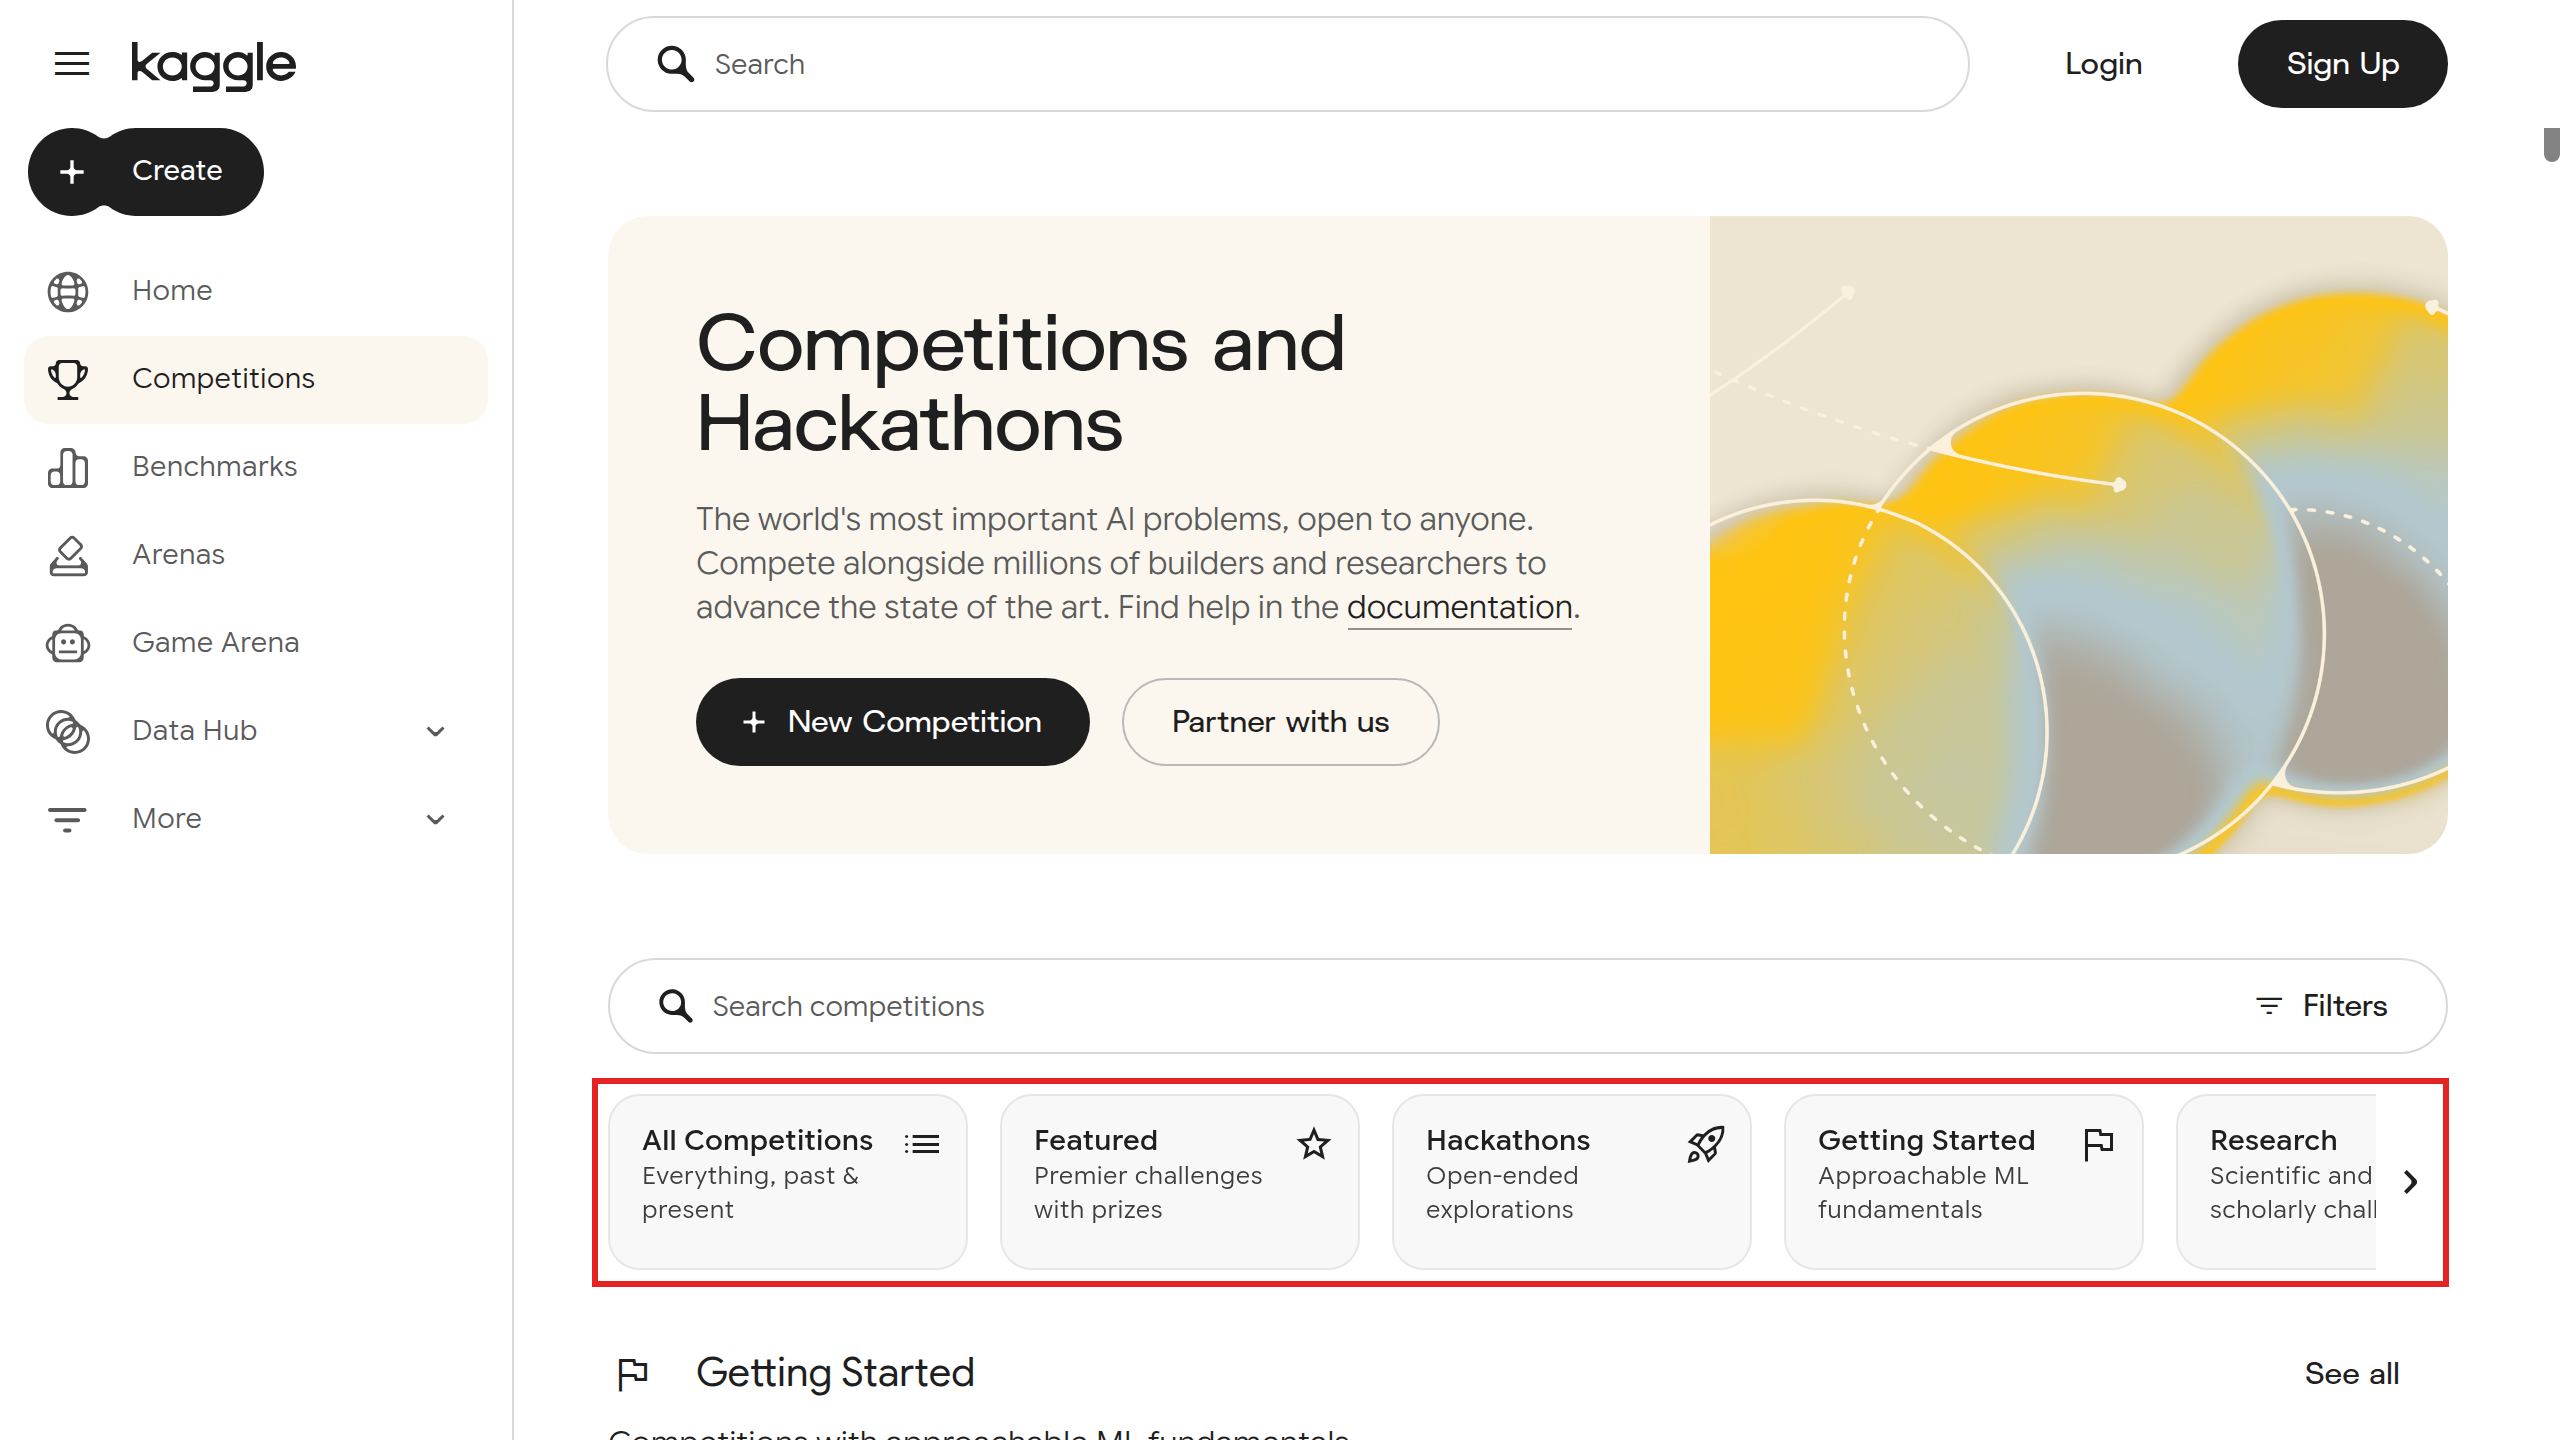
コンペの一覧では、コンペを区分で絞り込めます。
Kaggleのコンペの区分
区分 内容 Featured 賞金のある主なコンペ Research 科学や研究の課題 Getting Started 機械学習の基本を学ぶ入門のコンペ Playground 気軽に取り組める練習の課題 Community 参加者が作ったコンペ Hackathons アプリづくりなど、答えが1つでない課題 Simulations ゲームなどの環境で、自分のエージェントを戦わせる
Getting Startedのコンペには賞金も点数もなく、手引きが多く用意されています。
Playgroundのコンペで得られるのは、ふつうは賞金ではなく、ほかの参加者からの称賛や評価です。
Hackathonsでは、アプリを作る、新しい評価の指標を作る、LLMを創造的に使う、学ぶための動画を作る、といった課題が出ます。
予測のコンペで、提出から順位が決まるまで
予測のコンペでは、データをダウンロードし、手元のPCかKaggle Notebooksでモデルを作り、予測の結果のファイルを作って提出します。
コードのコンペと呼ばれる形式では、提出はすべてKaggle Notebooksの中から行います。
提出できる回数には1日の上限があり、ふつうは1日5回で、チームの全員の提出を合わせて数えます。
提出した予測は、テストのデータの一部で採点され、コンペの期間中はPublic Leaderboardに順位が出ます。
最終の順位は、残りのテストのデータで採点したPrivate Leaderboardで決まります。
Publicの点数が高くても、Privateの点数が高いとは限りません。
Publicの点数だけを見てモデルを合わせ込むと、残りのデータで点数が下がることがあるためです(過学習)。
上位のチームにはメダルが贈られ、その数は参加チームの数で決まります。
コンペのメダルを受け取れる順位
参加チーム Gold Silver Bronze 0〜99 上位10% 上位20% 上位40% 100〜249 上位10チーム 上位20% 上位40% 250〜999 上位10チーム+0.2% 上位50チーム 上位100チーム 1000以上 上位10チーム+0.2% 上位5% 上位10%
「上位10チーム+0.2%」は、参加チームが500増えるごとに、Goldが1つ増えることを表します(500チームなら上位11チーム)。
点数とメダルがもらえるかどうかは、コンペごとにOverviewのタブに書かれています。
Getting Started、Playground、Communityのコンペでは、ふつうはもらえません。
最初のコンペ「Titanic」
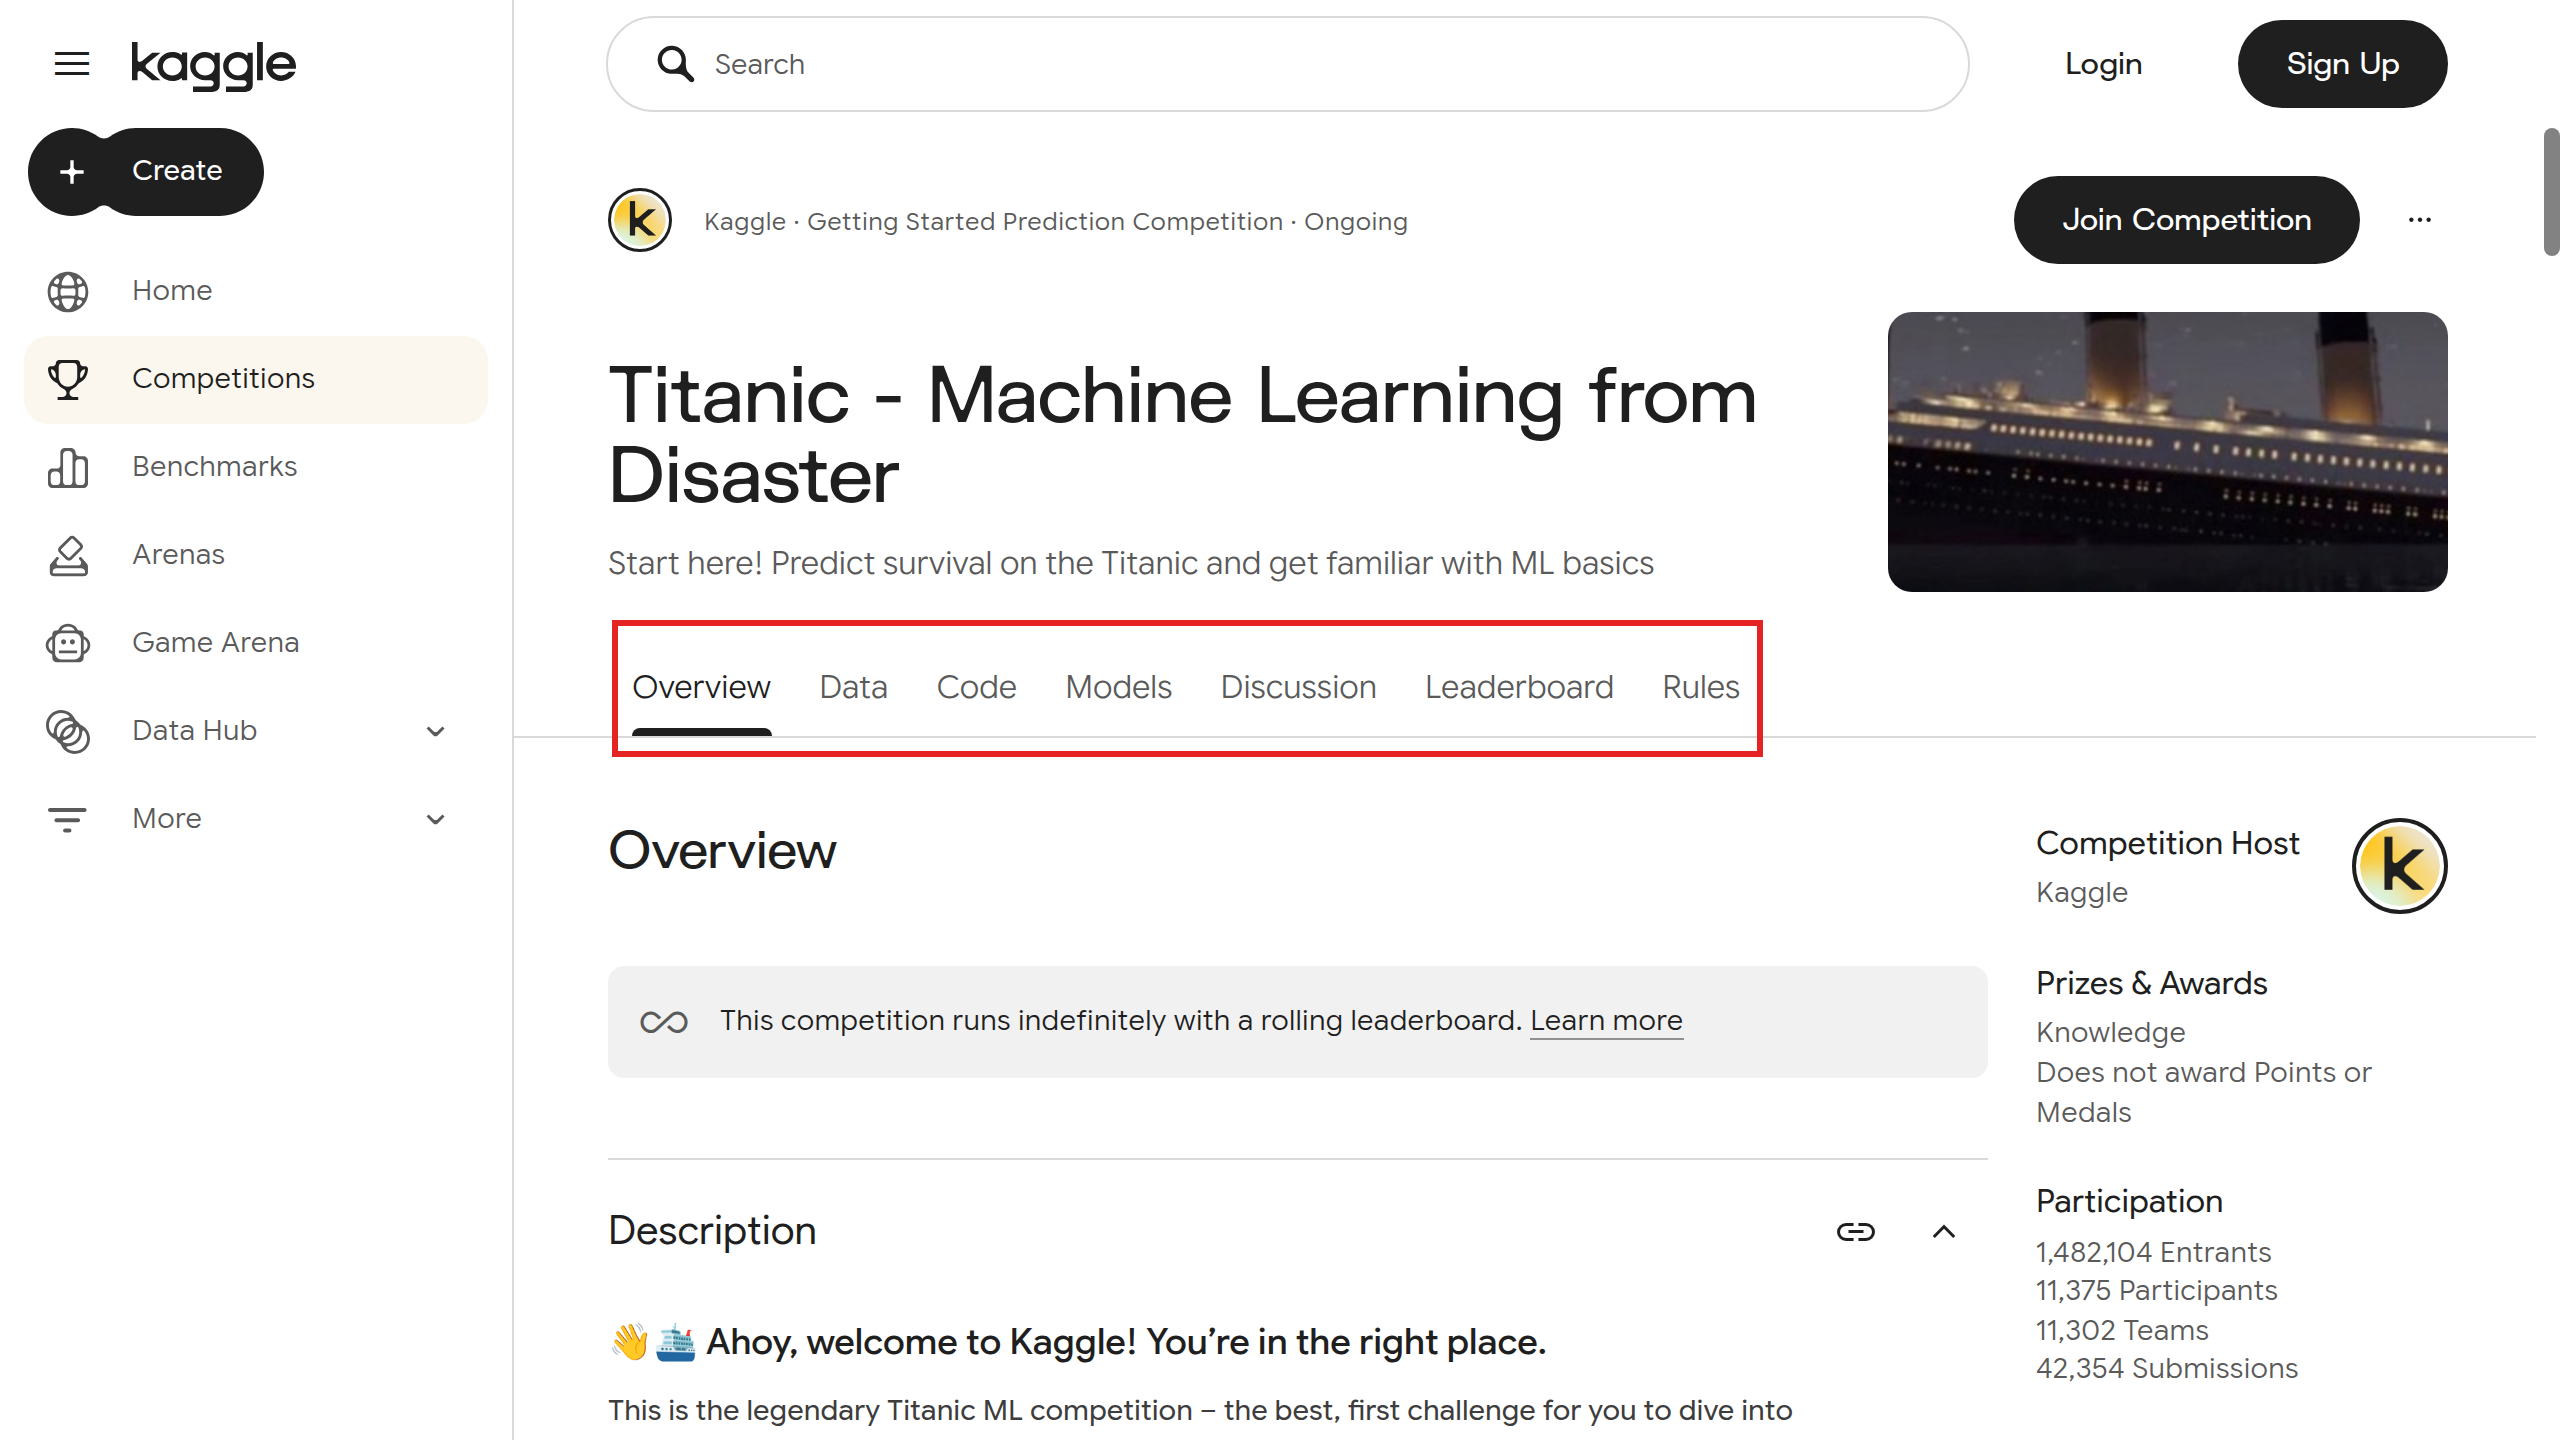
Kaggleで最初に取り組むコンペとして案内されているのが、Getting Startedの「Titanic - Machine Learning from Disaster」です。
タイタニック号の乗客のうち、だれが生き残ったかを予測するモデルを作ります。
コンペのページには、Overview、Data、Code、Models、Discussion、Leaderboard、Rulesのタブが並び、データの説明はData、順位はLeaderboardで見られます。
配られるデータは2つあります。
train.csvには、891人の乗客の情報と、生き残ったかどうかが入っています。
test.csvには、418人の乗客の情報だけが入っています。
test.csvの418人について生き残ったかを予測し、次の形のCSVを提出します。
PassengerId,Survived
892,0
893,1
894,0
Survivedの列には、生き残ったなら1、亡くなったなら0を入れ、見出しの行のあとに418人分の予測を1行ずつ並べます。
点数は、正しく予測できた乗客の割合(accuracy)です。
Titanicには賞金がなく、点数とメダルもありません。
提出は1日10回までできます。
提出から2か月を過ぎた結果はLeaderboardの集計に入らなくなり、2か月の間に提出のないチームはLeaderboardから外れます。
Titanicの参加者(Entrants)の数は、2026年11月20日の時点で148万人を超えています。
称号(Expert・Master・Grandmaster)の仕組み
Kaggleの称号は、Competitions、Datasets、Codeの3つのトラックごとに、メダルを集めて上がる仕組みです。
段階はExpert、Master、Grandmasterの3つで、上の段階ほど、多くの優れた結果が要ります。
トラックごとのメダルのもらい方
トラック メダルをもらえる成果 Competitions コンペで上位の順位をとる Code 公開したノートブックに票が集まる Datasets 公開したデータセットが評価される
Codeのメダルは、Expert以上の利用者から集めた票の数で決まり、Bronzeが5票、Silverが20票、Goldが50票です。
Competitionsのメダルは、数か月の取り組みの結果で、上位の参加者にしか贈られないので、ほかのトラックのメダルより取るのが難しいとされています。
そのため、Competitionsのトラックで段階を上げるのに要るメダルの数は、ほかのトラックより少なくなっています。
1つのトラックでGrandmasterになると「1x Grandmaster」と呼ばれ、ほかのトラックでもGrandmasterになると2x、3xと数えます。
プロフィールの写真のまわりの色は、3つのトラックのうち最も高い段階を表します。
古い解説では、NoviceやContributorの段階や、Discussionの称号が紹介されていることがあります。
いまの公式の説明では、称号は3つのトラックと、Expert、Master、Grandmasterの3段階です。
賞金と、無料で使えるGPU
Featuredのコンペには賞金があります。
たとえば、2026年11月20日に開催中だった「Google Quantum AI - Verifiable Quantum Circuit Compilation」の順位の賞金は、1位が5万ドル、2位が2万5,000ドル、3位が1万ドルです。
賞金を受け取るには、最終のモデルのコードを主催者に渡す、受け取りの書類に署名する、アメリカの税の書式(W-9かW-8BENなど)を出す、といった条件が、コンペのルールに定められています。
賞金にかかる税は、受け取る人が負担します。
Kaggle Notebooksの計算の環境と、Learnのコースは無料で使えます。
NotebooksではGPU(NVIDIA Tesla P100か、T4を2つ)を使え、使える時間は週30時間で、需要と資源によってはそれより多くなります。
TPU(TPU v3-8)は週20時間まで使えます。
1回の実行は、CPUとGPUが12時間まで、TPUが9時間までです。
混んでいるときは、GPUを使うまでに順番を待つことがあります。
「Kaggleは意味ない」?コンペで練習できることと、できないこと
予測のコンペでは、課題、データ、評価の指標が、最初から主催者によって決められています。
仕事では、何を予測するかを決める、データを集めて整える、結果をどう使うかを決める、といった工程から始まりますが、こうした工程は、Kaggleのコンペだけでは練習しにくい部分です。
Kaggleのコンペで練習できる範囲と、仕事で要る範囲には、この違いがあります。
一方で、Kaggleには、ほかの場では得にくい練習の機会があります。
同じデータと評価の指標で、世界の参加者と結果を比べられる。
PublicとPrivateのLeaderboardの差から、過学習を自分の目で確かめられる。
上位の参加者が公開したノートブックとDiscussionsの書き込みから、解き方を読める。
NotebooksのGPUで、手元にGPUがなくてもモデルを試せる。
Kaggleのコンペで主に練習できるのは、渡されたデータから特徴を作り、モデルを選び、検証するところです。
データサイエンティストの仕事に要るほかのスキルは、データサイエンティストの記事 で紹介しています。
初心者が始める順番
はじめての人は、次の順に進めると、Kaggleの機能を一通り使えます。
Learnのコース(Intro to Programming、Python、Intro to Machine Learning、Pandasなど)で、Pythonと機械学習の基本を学ぶ。
Titanicのデータをノートブックで読み込み、予測のCSVを提出して、Leaderboardで点数を見る。
Titanicの公開のノートブックを読み、点数の高い解き方を自分のノートブックで試す。
Playgroundのコンペで、ほかの課題に取り組む。
点数とメダルのあるコンペに、チームか1人で参加する。
Hugging Faceとは
Hugging Faceは、機械学習のモデル、データセット、アプリを公開して共有するWebサイト(Hugging Face Hub)と、そのモデルを使うためのライブラリを提供している会社です。
トップページには、200万を超えるモデル、50万を超えるデータセット、100万を超えるアプリが公開されていると表示されています。
QwenやGemmaのような、オープンなLLMの重みのファイルも、Hubで公開されています。
主なオープンなLLMの違いは、オープンLLMの比較 で紹介しています。
Hubのモデル一覧と、モデルの選び方
Hubには、モデル(Models)、データセット(Datasets)、アプリ(Spaces)の3つがあり、どれもGitのリポジトリとして置かれています。
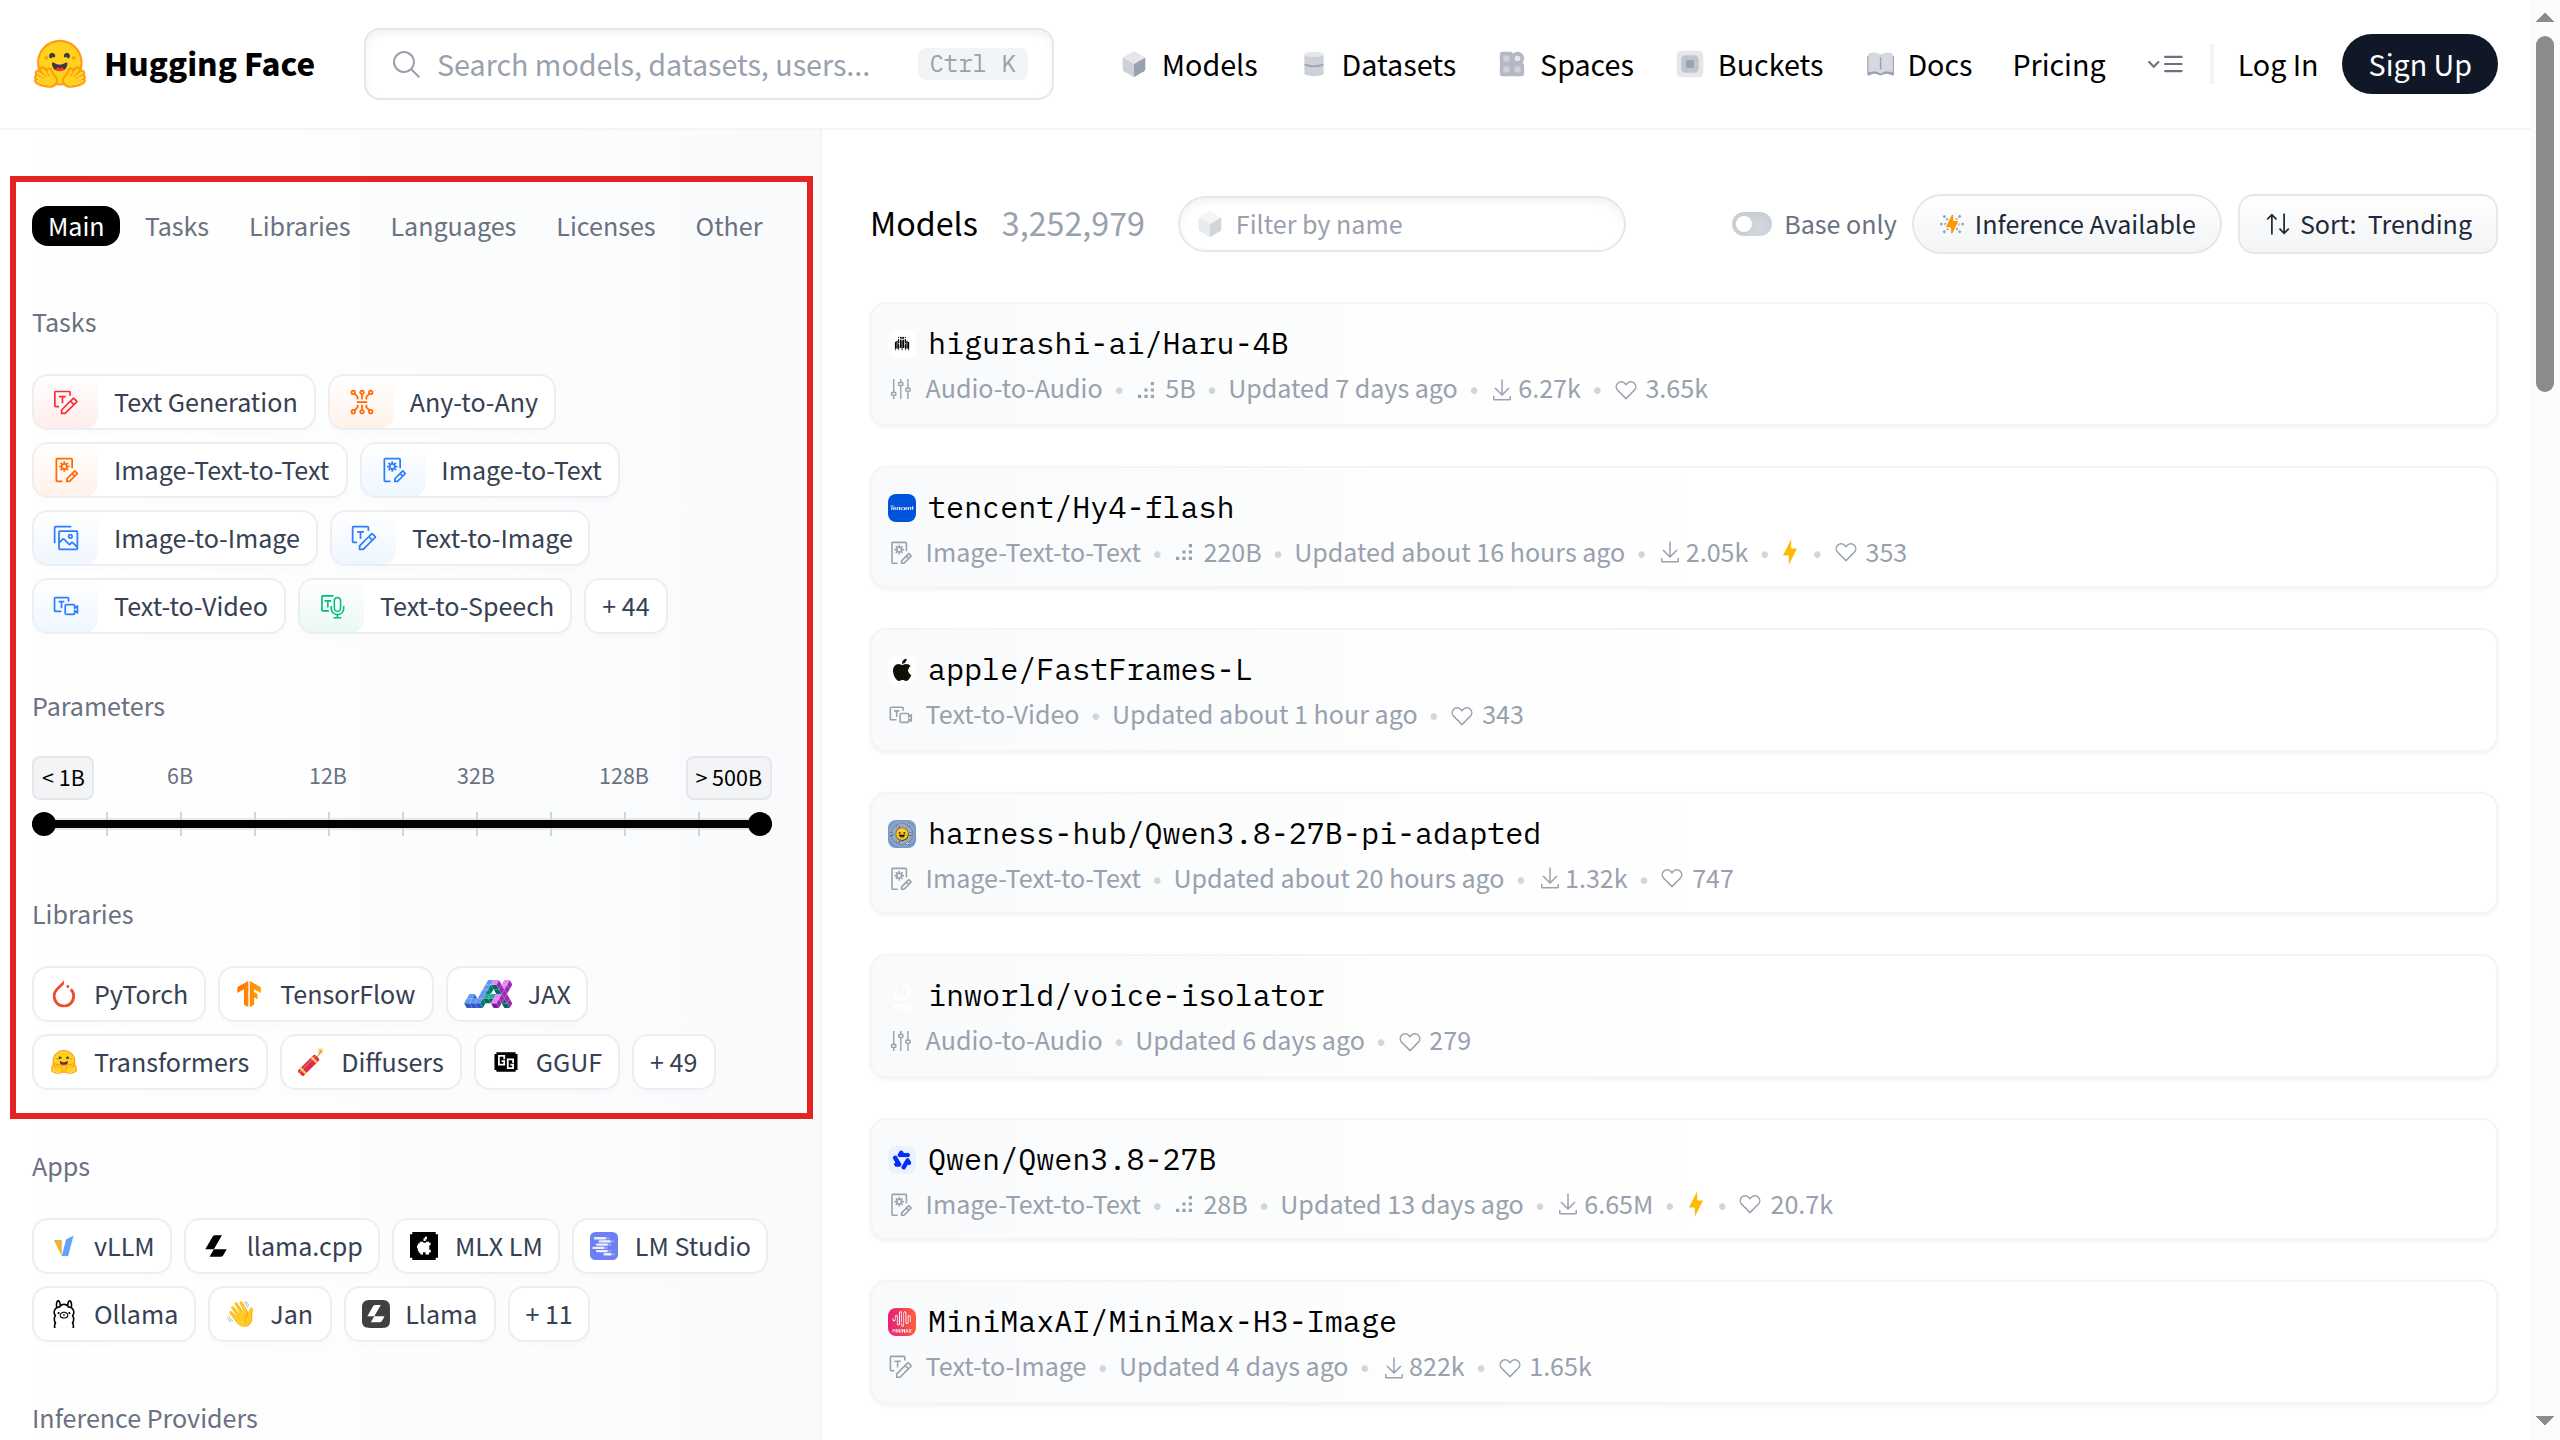
モデルの一覧では、左の欄の上のタブ(Main、Tasks、Libraries、Languages、Licenses、Other)を切り替えて、タスク、ライブラリ、言語、ライセンスなどで絞り込めます。
Mainのタブには、タスク、パラメーターの数(Parameters)、ライブラリなどの欄が並びます。
モデルのページには、モデルカード(リポジトリのREADME.md)があります。
モデルカードには、モデルの説明、用途と制限、学習の設定、使ったデータセット、評価の結果などが書かれ、ライセンスもカードのメタデータで示されます。
使うモデルを決める前に、モデルカードで用途と制限、ライセンスを確かめます。
Hubのモデルを手元のPCで動かす方法は、ローカルLLMの記事 で説明しています。
Transformersは、Hugging Faceが開発しているライブラリで、文章、画像、音声、動画、マルチモーダルのモデルを、推論と学習の両方で使えるようにします。
いまの版はv5の系統で、PyTorchの上で動き、Python 3.11以上とPyTorch 2.6以上で確かめられています。
いちばん簡単な使い方は、タスクとモデルの名前を指定するpipelineです。
公式の文書の例では、次の3行で、Hubのモデルに文章の続きを書かせます。
from transformers import pipeline pipeline = pipeline( task = "text-generation" , model = "google/gemma-2-2b" ) pipeline( "the secret to baking a really good cake is " ) taskを替えると、同じ書き方で、音声の文字起こし(automatic-speech-recognition)や画像の分類(image-classification)にも使えます。
学習させるときはTrainer、文章を速く生成するときはgenerateという機能を使います。
Spacesでできること
Spacesは、機械学習のモデルを使ったデモのアプリを作り、ブラウザから使えるように公開する機能です。
アプリは、Gradio、Docker、静的なHTMLの3つの方法で作れます。
静的なHTMLのSpaceは、だれでも無料で作れます。
GradioとDockerのSpaceを作るには、個人ならPRO、組織ならTeamかEnterpriseの有料のプランが要ります。
無料の個人のアカウントでも、メールアドレスを確かめて30日を過ぎていれば、GPUを共有して使うZeroGPUのGradioのSpaceを2つまで置けます。
ほかの人が公開したSpaceは、ブラウザから開いて試せます。
安全に使うために確かめること
Hubは、リポジトリの2GB未満のファイルをコミットのたびにマルウェアの検査にかけ、書き込まれたパスワードや鍵などの秘密の情報も、TruffleHogというツールで検査しています。
それでも、モデルを読み込む側で確かめることがあります。
pickleの形のファイルに注意する:pickleはPyTorchの重みの既定の形ですが、読み込むと任意のコードが動く攻撃に使われることがあります。信頼できる人や組織が公開したモデルを使い、Hubが表示する検査の結果を確かめます。
safetensorsの形を選ぶ:safetensorsは、pickleと違って、重みを安全に保存するための形です。同じモデルにsafetensorsのファイルがあれば、そちらを使います。
trust_remote_codeを付ける前にコードを読む:独自のコードを使うモデルは、読み込むときにtrust_remote_code=Trueを付けないと使えません。付ける前に、そのリポジトリのコードと公開者を確かめます。
アクセストークンの権限を絞る:トークンには、fine-grained(指定したリソースだけ)、read(読み取りだけ)、write(書き込みもできる)の種類があり、本番で使うときはfine-grainedが勧められています。
PyTorchとは
PyTorchは、Pythonで使うオープンソースの深層学習のフレームワークです。
GPUで速く計算できるテンソル(多次元の配列)と、動的に組み立てるニューラルネットワークを扱え、研究の試作から本番の運用まで使えるように作られています。
Metaのもとで開発されてきたPyTorchは、2022年9月12日に、Linux Foundationの下にできたPyTorch Foundationへ移りました。
ライセンスはBSDスタイルです。
いまの最新の安定版は、2026年10月28日に公開された2.15.0で、Python 3.11以上が要ります。
PyTorchで何ができるか
PyTorchは、自然言語処理、画像の認識、強化学習、生成AIなど、幅広いモデルの開発に使われています。
CPU、GPU、専用のアクセラレーターで動き、分散学習や、クラウドとモバイルの端末への組み込みにも対応しています。
torch.compileを使うと、モデルや関数を最適化して動かせます。
画像にはtorchvision、音声にはtorchaudioという、分野ごとのライブラリがあります。
はじめて学ぶなら、公式のチュートリアルの「Learn the Basics」から始められます。
E資格のように、試験でPyTorchを選べる資格もあります(AI資格の記事 )。
PyTorchとTensorFlowの違い
TensorFlowは、公式のサイトで「機械学習のためのエンドツーエンドのプラットフォーム」と紹介されているフレームワークです。
どちらを使うかは、使いたいライブラリと教材がどちらに対応しているかで選びます。
Hugging FaceのTransformersは、いまの版ではPyTorchで動きます。
Keras 3は、JAX、TensorFlow、PyTorchのどれの上でも動くので、PyTorchでもTensorFlowでも同じコードを使えます。
E資格の試験では、PyTorchかTensorFlowを、試験の開始時に選びます。
GitHubとバージョンの確かめ方
PyTorchのソースコードは、GitHubのpytorch/pytorchのリポジトリで公開され、版ごとの変更はReleasesのページに載っています。
入っているPyTorchの版は、Pythonで次のように確かめます。
import torch print (torch. __version__ ) print (torch.version.cuda) CPU版の2.15.0で動かすと、1行目に2.15.0+cpu、2行目にNoneと出ます。
torch.version.cudaとtorch.version.hipを見ると、CUDAの版か、ROCm(HIP)の版かを見分けられます。
CUDAとROCmの版の選び方
PyTorchのGPUの版は、NVIDIAのGPUにはCUDAの版、AMDのGPUにはROCmの版を使います。
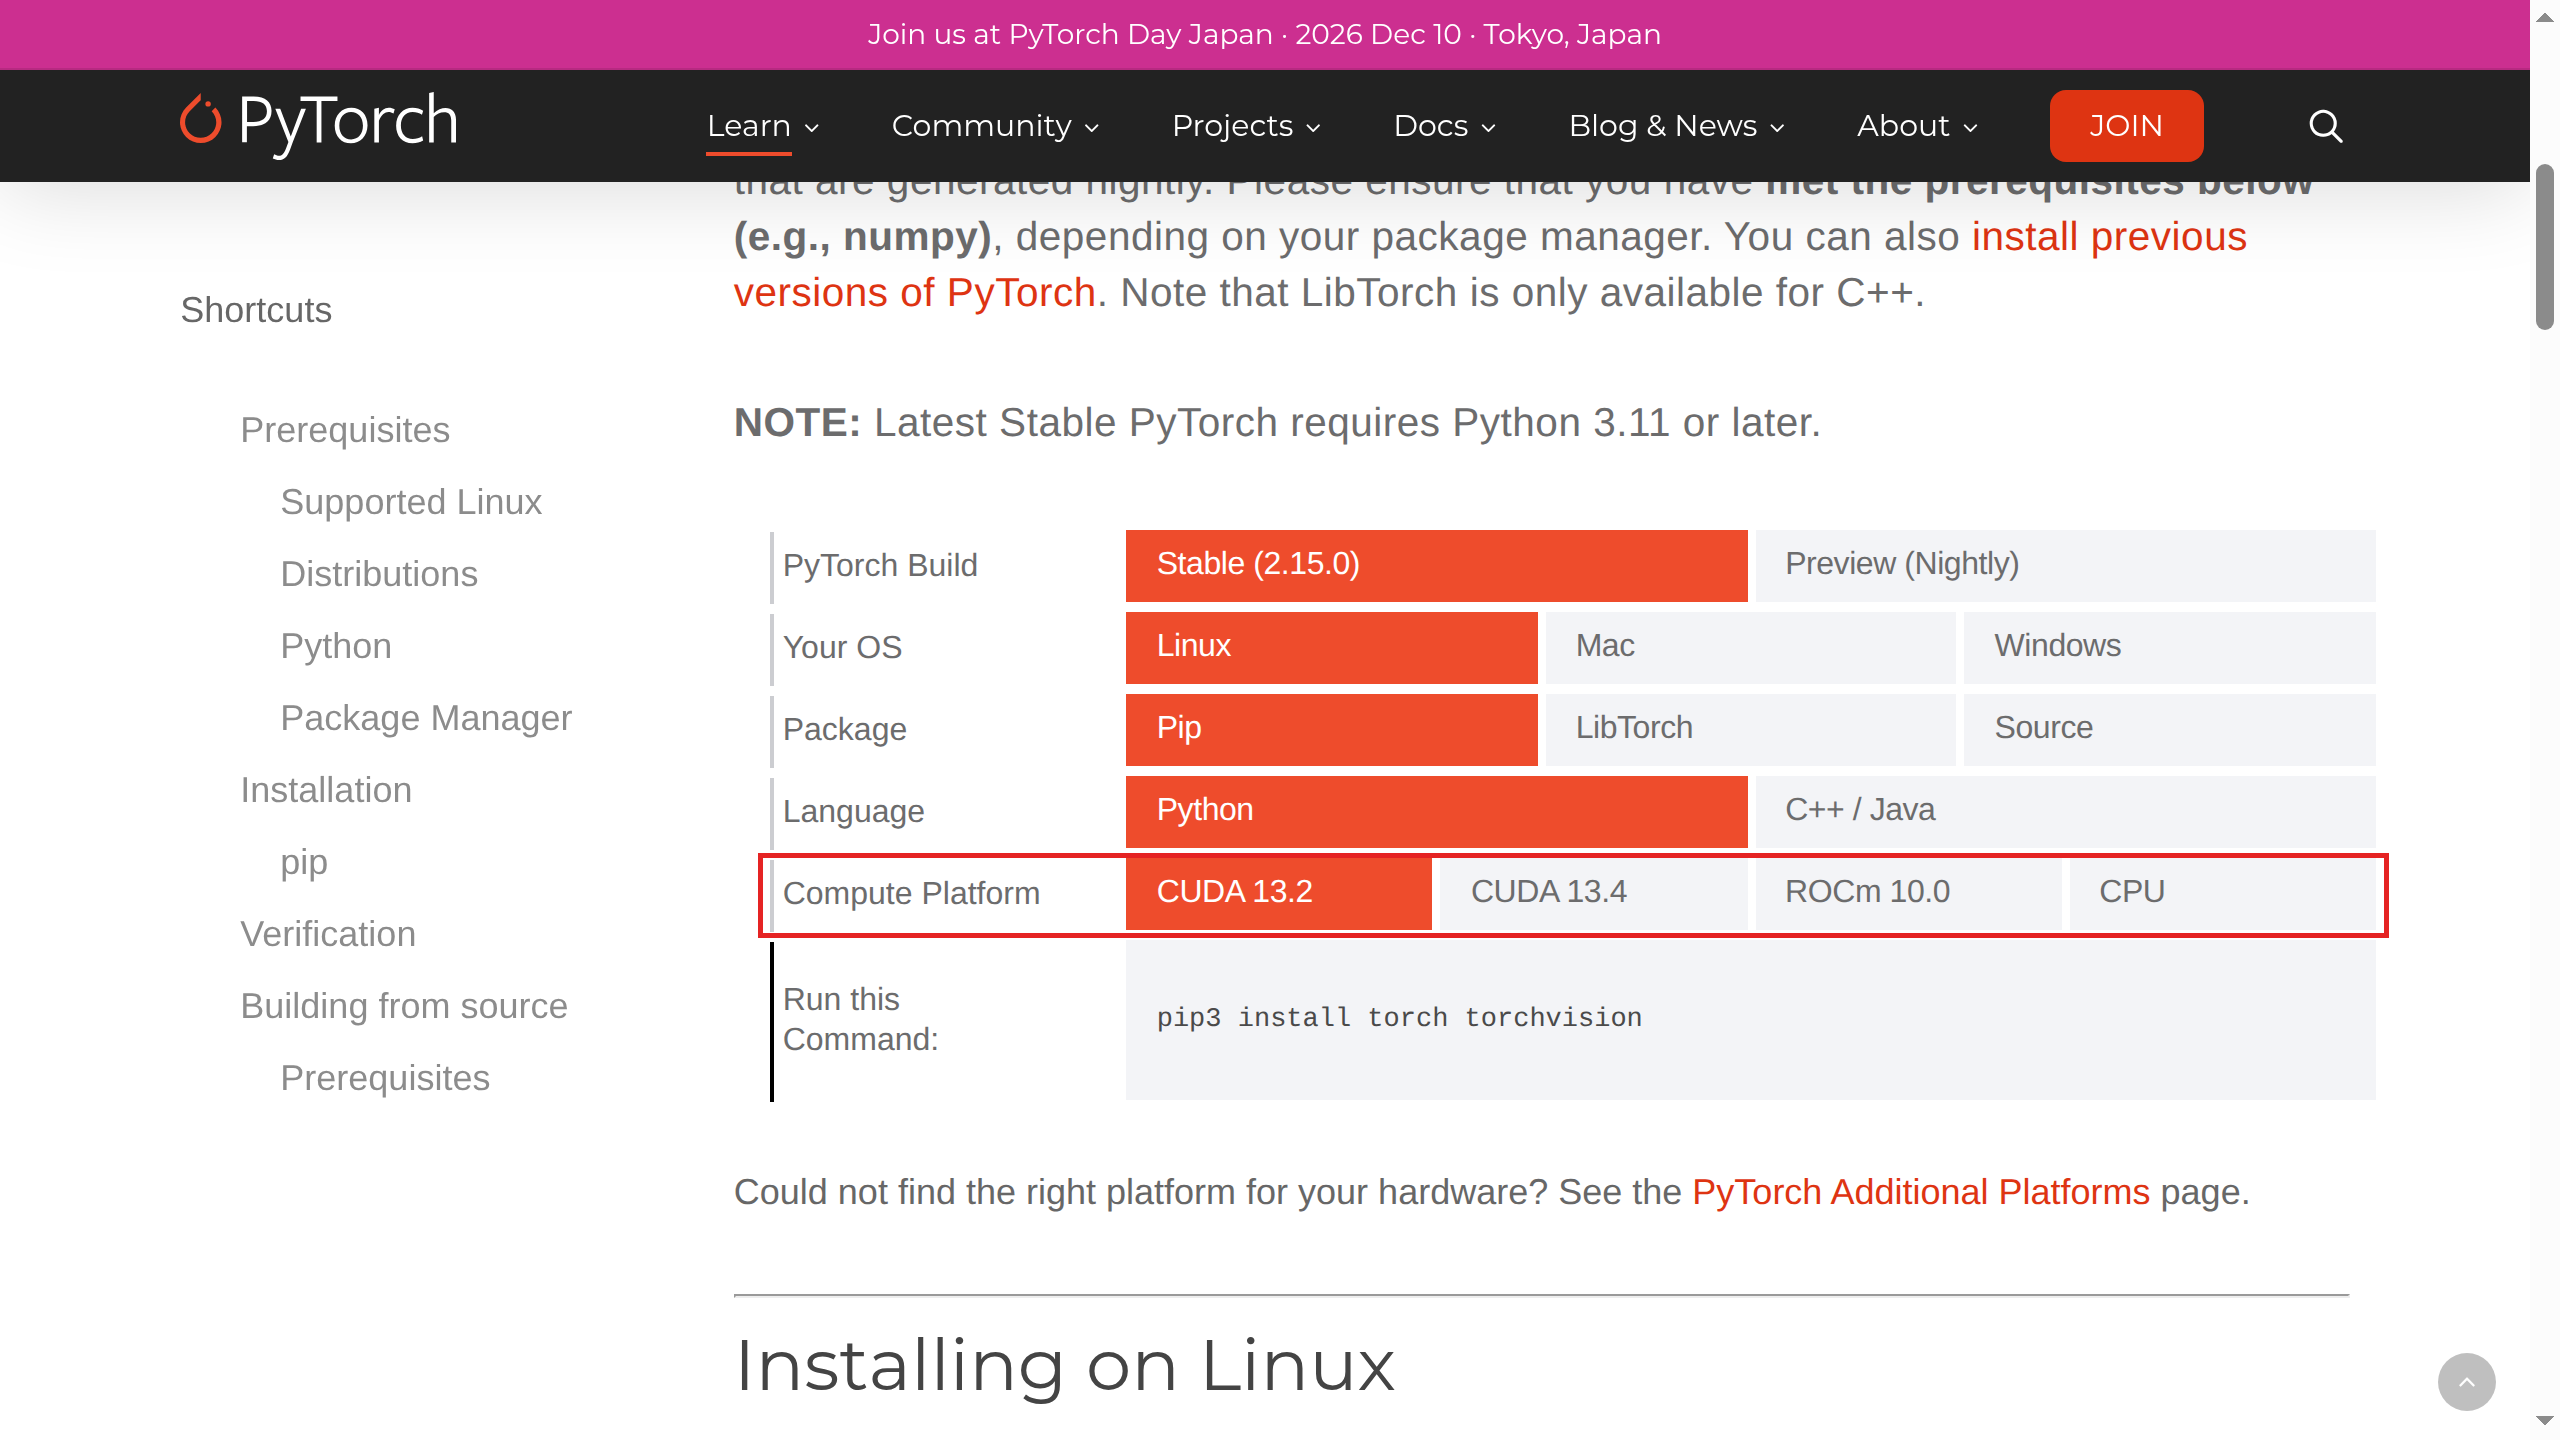
公式のGet Startedのページでは、OS、パッケージ、言語と、Compute Platformを選ぶと、インストールするためのコマンドが表示されます。
Compute Platformでは、CUDAのいくつかの版(13.2、13.4など)、ROCm 10.0、CPUから選びます。
CUDAの版は使うPCに合うものを選び、多くの場合は新しい版がよいとされています。
GPUを使わないなら、CPUを選びます。
PyTorch Lightning・PyTorch Geometric・ONNXへの書き出し
PyTorchのまわりには、PyTorchのコードを整理したり、別の形で使えるようにしたりするライブラリがあります。
PyTorch Lightning:PyTorchのコードを整理し、学習のループなどの定型の処理を自動化するフレームワークです。モデルと学習の処理をLightningModuleにまとめると、残りはTrainerが受け持ちます。ライセンスはApache-2.0です。
PyTorch Geometric(PyG):PyTorchの上で、グラフ構造のデータを扱うグラフニューラルネットワーク(GNN)を書いて学習させるライブラリです。
ONNXへの書き出し:PyTorchのモデルを、ほかの環境でも動かせるONNXの形にします。
ONNXへの書き出しは、torch.onnx.exportで行います。
dynamo=Trueが勧められている方法で、PyTorch 2.9から既定になりました。
使うにはonnxとonnxscriptのパッケージが要ります。
次の例は、小さなモデルをtiny_model.onnxに書き出すもので、PyTorch 2.15.0で動きます。
import torch class TinyModel ( torch . nn . Module ): def __init__ (self): super (). __init__ () self .linear = torch.nn.Linear( 4 , 2 ) def forward (self, x): return self .linear(x) model = TinyModel() onnx_program = torch.onnx.export(model, (torch.randn( 1 , 4 ),), dynamo = True ) onnx_program.save( "tiny_model.onnx" ) 書き出したONNXのモデルは、ONNX Runtimeを使って、さまざまなプロセッサーで動かせます。
LangChainとは
LangChainは、エージェントとLLMを使うアプリを作るためのオープンソースのフレームワークです。
部品や外部のサービスとの連携(インテグレーション)を組み合わせてアプリを作る仕組みを持ち、エージェントを作るcreate_agentは、OpenAI、Anthropic、Googleなどのモデルに対応しています。
Python版のほかに、JavaScriptとTypeScriptのLangChain.jsがあり、ライセンスはMITです。
2025年10月22日に1.0が公開され、2.0までは互換性を壊す変更をしないと約束されています。
いまの最新は2026年11月18日に公開された1.5.2で、Python 3.11以上が要ります。
社内の文書を検索して答えるRAGをLangChainで組む流れは、RAGの記事 で紹介しています。
LangGraph・LangSmithとの関係
LangChainの会社は、LangChainのほかに、LangGraphとLangSmithを提供しています。
LangChain・LangGraph・LangSmithの役割
名前 役割 LangChain モデル、ツール、エージェントの処理をまとめたフレームワーク LangGraph 長く動き、状態を持つエージェントを動かす土台 LangSmith 処理の記録、評価、プロンプトの管理、公開のためのプラットフォーム
LangGraphでは、処理の流れを、共有する状態、ノード、エッジのグラフとして書きます。
LangChainのエージェントはLangGraphの上に作られていますが、LangGraphはLangChainなしでも使えます。
決まった流れで動くエージェントを細かく作り込みたいときはLangGraph、まず手早くエージェントを作りたいときはLangChainのcreate_agentから始めます。
AIエージェントの仕組みは、AIエージェントの記事 で説明しています。
few-shotプロンプトの書き方
few-shotプロンプトは、プロンプトの中に入力と答えの例をいくつか入れて、LLMに答え方を示す書き方です。
LangChainでは、langchain-coreのFewShotChatMessagePromptTemplateで、例をメッセージの並びにして組み込めます。
from langchain_core.prompts import ChatPromptTemplate, FewShotChatMessagePromptTemplate examples = [ { "input" : "2+2" , "output" : "4" }, { "input" : "2+3" , "output" : "5" }, ] example_prompt = ChatPromptTemplate.from_messages( [( "human" , " {input} " ), ( "ai" , " {output} " )] ) few_shot_prompt = FewShotChatMessagePromptTemplate( examples = examples, example_prompt = example_prompt, ) final_prompt = ChatPromptTemplate.from_messages( [ ( "system" , "あなたは計算の答えだけを返すアシスタントです。" ), few_shot_prompt, ( "human" , " {input} " ), ] ) final_promptに{"input": "4+4"}を渡すと、指示(System)、例の質問と答え(HumanとAI)が2組、最後の質問「4+4」の順に並んだメッセージになります。
このメッセージをモデルに渡して、例と同じ形で答えさせます。
文章の形のプロンプトに例を入れるときは、FewShotPromptTemplateを使います。
GitHubとLangChain4j
LangChainのソースコードは、GitHubのlangchain-ai/langchainのリポジトリで公開されています。
LangChain4jは、Javaで動くLLMのアプリを作るためのオープンソースのライブラリです。
主なLLMのサービスとベクトルストアを同じAPIで使え、ツールの呼び出し(MCPを含む)、エージェント、RAGを作れて、QuarkusやSpring Bootと組み合わせられます。
名前は似ていますが、Python版のLangChainをJavaに移したものではなく、API、内部の作り、公開の時期はPython版から独立しています。
GitHubのリポジトリもlangchain4jという別の組織にあり、ライセンスはApache-2.0です。
「LangChainはオワコン?」と、代わりの選択肢
「LangChain オワコン」と検索されることがありますが、開発は続いています。
1.0では、エージェントを作るcreate_agentを中心に作り直し、処理に手を加えるミドルウェアの仕組みを足し、古い機能はlangchain-classicという別のパッケージに移しました。
1.0の後も版を重ね、2026年11月18日に1.5.2が公開されています。
LLMのアプリを作るフレームワークは、LangChainのほかにもあります。
LangChainの代わりに検討されるもの
名前 公式の紹介 LlamaIndex AIのための文書処理のプラットフォーム。エージェントのアプリを作るオープンソースのフレームワークもある Haystack Pythonで本番向けのLLMのアプリを作る、オープンソースのフレームワーク Semantic Kernel C#、Python、JavaでAIエージェントを作る開発キット。後継はMicrosoft Agent Framework
目的別:どれから始めるか
4つのどれから始めるかは、やりたいことで決めます。
やりたいことと、始める道具
やりたいこと 道具 最初にすること 機械学習を練習する Kaggle Learnのコースと、Titanicへの提出 公開のモデルを試す Hugging Face モデルの一覧で絞り込み、Spacesで試す モデルを作って学習させる PyTorch 公式のLearn the Basics LLMでアプリを作る LangChain create_agentでエージェントを作る
4つともPythonから使えるので、Pythonの基本を先に学んでおくと進めやすくなります。
Kaggleで練習してPyTorchでモデルの作り方を学び、Hugging Faceの公開のモデルを使い、LangChainでLLMのアプリを作る、という順に広げることもできます。
学んだ道具の使い方を、 勉強会の説明動画に
NoLangで動画を作る 会社でAI開発の勉強会を開くとき
会社では、AIの開発を始めるチームが、Kaggle、Hugging Face、PyTorch、LangChainの役割や使い分けを、社内勉強会で説明する場面があります。
NoLangを使うと、勉強会の資料(PDF、PowerPoint)からナレーションの入った説明の動画を作れるので、メンバーにいつでも同じ内容を見てもらえます。
社内の研修で動画を使う例は、法人向けの研修動画のページ にまとめています。
導入について相談したいときはお問い合わせ から連絡でき、サービスの資料は下のボタンから請求できます。
資料をダウンロード