ディープラーニング(深層学習)とは、人の脳の神経細胞のつながりを手本にしたニューラルネットワークを何層にも重ねて、データから学ばせる機械学習の手法です。
画像のどこに注目すれば見分けられるかといった手がかり(特徴)も、人が教えずにデータから学ぶ点が、ほかの機械学習との大きな違いです。
音声認識、翻訳、画像認識、そしてChatGPTのような生成AIも、ディープラーニングで作られています。
この記事では、ディープラーニングの意味とAI・機械学習との関係、ニューラルネットワークが学ぶ仕組みを、1つのニューロンの計算を数字で追いながら説明します。
ブラウザで動くニューラルネットワークの画面と、PythonのPyTorchで実際に学習させたコードと結果も載せています。
後半では、CNNやTransformerなど7つの種類、歴史、できることと課題、本と資格を使った学び方をまとめます。
ディープラーニングとは
多層のニューラルネットワークで学ぶ機械学習
ディープラーニングは英語のdeep learningをカタカナにした言葉で、日本語では深層学習とも呼ばれ、どちらも同じ技術を指します。
ニューラルネットワークは、人の脳の神経細胞(ニューロン)が信号を受け渡す働きを手本にした計算の仕組みです。
小さな計算をするニューロンを横に並べて層にし、層を順につないで、入力から答えを出します。
「ディープ(深い)」は、この層を何層にも重ねることを指します。
入力と出力の間の層(隠れ層)が多いほど、ネットワークは深くなります。
ディープラーニングでは、たくさんの例となるデータを見せて、正しい答えを出せるようにネットワークの中の数値(重み)を少しずつ直していきます。
この「重みを直していく」ことが、ディープラーニングでいう学習です。
AI・機械学習・生成AIとの関係
ディープラーニングは、AI(人工知能)を実現する技術である機械学習に含まれる手法の1つです。
AIの中に機械学習があり、機械学習の中にディープラーニングがある、という入れ子の関係になります。
AIの意味と種類は、AIとは で詳しく説明しています。
AI、機械学習、ディープラーニング、生成AI、LLMの関係
言葉 意味 位置づけ AI(人工知能) 見分ける、判断する、言葉を使うといった人の知的な働きを、コンピューターで実現する技術 いちばん広い言葉 機械学習 データから規則性を学んで、予測や判断をする技術 AIを実現する方法の1つ ディープラーニング 多層のニューラルネットワークで学ぶ機械学習 機械学習の手法の1つ 生成AI 文章、画像、音声、動画などを新しく作るAI 多くがディープラーニングで作られる LLM(大規模言語モデル) 大量の文章で学んだ、言葉を扱う大きなモデル 生成AIのうち言葉を扱うもの
機械学習には、ディープラーニングのほかに、決定木やサポートベクターマシンなどの手法もあります。
学び方で分けた教師あり学習、教師なし学習、強化学習の違いは、機械学習とは で説明しています。
ディープラーニングと生成AIの違いは、「作り方」と「できること」の違いです。
ディープラーニングは学ばせ方の名前で、画像を見分ける、音声を文字にするといった、何かを作らない用途にも使われます。
生成AIは、新しい文章や画像を作れるという機能に着目した呼び方で、いまの生成AIの多くはディープラーニングで作られています。
生成AIの仕組みと種類は、生成AIとは にまとめています。
ディープラーニングとLLMの関係も同じで、LLMはディープラーニングで作られたモデルの1つです。
ChatGPTやGemini、Claudeの中で文章を作っているのがLLMで、後で説明するTransformerという種類のネットワークを、大量の文章で学ばせて作ります。
詳しくはLLMとは で説明しています。
機械学習との違い
ディープラーニングとほかの機械学習の手法の大きな違いは、見分けるための手がかり(特徴量)を誰が決めるかにあります。
たとえば、写真に写っている動物が猫か犬かを見分けるとします。
ディープラーニング以外の機械学習では、耳の形、顔の輪郭、毛の色のように、どこに注目すればよいかを人が考えて数値にし、それをモデルに渡すことが多くあります。
ディープラーニングは、写真の画素の値をそのまま受け取り、浅い層で線や色の境目、深い層で目や耳のような形の組み合わせ、というように、手がかりを層ごとに組み立てながら自分で学びます。
ディープラーニングとほかの機械学習の違い
項目 ほかの機械学習の手法 ディープラーニング 特徴量 人が考えて作ることが多い データから自動で学ぶ 必要なデータ量 少なめでも動く 多いほど力を発揮する 計算量 少なめ 多い(GPUを使うことが多い) 答えの理由の説明 しやすい手法が多い しにくい 得意なデータ 表の形に整ったデータ 画像、音声、文章
表の形に整った少ないデータなら、ディープラーニング以外の手法のほうが計算が速く、答えの理由も説明しやすいことがよくあります。
画像、音声、文章のように、人が手がかりを書き出しにくいデータで、ディープラーニングは特に強みを発揮します。
ニューラルネットワークの仕組み
ニューロンの計算を数字で追う
ニューラルネットワークの1つのニューロンがする計算は、掛け算と足し算と、最後の1つの変換だけです。
入力のそれぞれに「重み」を掛けて足す。
「バイアス」という数を足す。
足した結果を「活性化関数」に通して、次の層へ渡す値にする。
入力が2つのニューロンで、実際に計算してみます。
重みは0.8と-0.4、バイアスは0.1とし、活性化関数には、0より小さい値を0にして、0以上の値はそのまま通すReLUを使います。
1つのニューロンの計算(重み0.8と-0.4、バイアス0.1、ReLU)
計算 入力が1.0と0.5のとき 入力が0.2と1.0のとき 入力×重み 1.0×0.8=0.8、0.5×(-0.4)=-0.2 0.2×0.8=0.16、1.0×(-0.4)=-0.4 合計にバイアスを足す 0.8-0.2+0.1=0.7 0.16-0.4+0.1=-0.14 ReLUに通した出力 0.7 0
1つ目の入力は重みが正なので値が大きいほど出力を押し上げ、2つ目の入力は重みが負なので値が大きいほど出力を押し下げます。
重みは、そのニューロンがどの入力をどれだけ重く見るかを表す数です。
ニューロン1つでは、この程度の単純な計算しかできません。
ディープラーニングは、このニューロンを何十、何百と並べて層にし、層を何層も重ねることで、画像や言葉のような複雑なデータを扱えるようにします。
重みとバイアスの値は、人が決めるのではなく、学習によってデータから決まります。
入力層・隠れ層・出力層
ニューラルネットワークは、データを受け取る入力層、計算を重ねる隠れ層(中間層)、答えを出す出力層でできています。
ニューラルネットワークの層(手書きの数字を見分ける例)
層 すること 手書きの数字の例 入力層 データを数値として受け取る 8×8=64個の画素の明るさ 隠れ層 ニューロンの計算を重ねて、手がかりを組み立てる 画素の明るさの組み合わせから、数字を見分ける手がかりを作る 出力層 答えを出す 0〜9のそれぞれである確からしさ(10個の値)
隠れ層のニューロンは、前の層のすべてのニューロンの出力を入力として受け取ります。
そのため、層の大きさに応じて重みの数が増えます。
この記事の後半でPythonで動かす、入力64、隠れ層64と64、出力10のネットワークには、重みとバイアスが合わせて8,970個あります。
活性化関数
活性化関数は、ニューロンが足し合わせた値を、次の層へ渡す値に変える関数です。
掛け算と足し算だけを何層重ねても、全体としては1回の掛け算と足し算と同じ、まっすぐな線の計算にしかなりません。
活性化関数で曲がった(非線形の)変換を挟むことで、層を重ねる意味が生まれ、まっすぐな線では分けられないデータも分けられるようになります。
このことは、後の「隠れ層がないと解けない問題」で、実際に確かめます。
主な活性化関数
名前 出力 よく使われる場所 ReLU 0より小さい値は0、0以上はそのまま 隠れ層 シグモイド 0〜1の間 「はい」か「いいえ」の確率を出す出力層 tanh(ハイパボリックタンジェント) -1〜1の間 隠れ層 ソフトマックス 合計が1になる複数の値 複数の候補から選ぶ出力層
学習の流れ:損失・誤差逆伝播・勾配降下法
学習は、重みを「予測と答えのずれが小さくなる方向」に少しずつ直す作業のくり返しです。
1. 順伝播 :入力をネットワークに通して、いまの重みで予測を出します。2. 損失の計算 :予測と正しい答えのずれを、損失(誤差)という1つの数にします。3. 誤差逆伝播 :損失を出力層から入力層へ向けて逆にたどり、重みのそれぞれを少し変えたら損失がどれだけ変わるか(勾配)を求めます。4. 重みの更新(勾配降下法) :損失が小さくなる向きに、重みを少しだけ動かします。どれだけ動かすかの大きさを学習率と呼びます。5. くり返し :たくさんのデータで1〜4をくり返します。訓練データを一通り使い切ることを1エポック(この記事のコードの出力では「1周」)と数えます。 重みの更新を数字で書くと、次のようになります。
いまの重みが0.8で、その重みを少し増やすと損失が増える(勾配が0.5)とき、学習率を0.1にすると、新しい重みは0.8-0.1×0.5=0.75です。
損失を増やす向きと逆に動かすので、重みは小さくなります。
誤差逆伝播は、何千、何万とある重みの勾配を、出力側から順にまとめて効率よく求める方法です。
学習に使ったデータで正解率が高くても、新しいデータで当たるとは限りません。
例を丸暗記して新しいデータで外れる状態を過学習と呼び、これを見分けるために、学習に使わないテストデータで正解率を測ります。
ブラウザで学習を見る
ニューラルネットワークが学ぶ様子は、TensorFlow Playground(A Neural Network Playground)というWebページで、ブラウザだけで見られます。
Daniel SmilkovさんとShan Carterさんが作った教育用のページで、プログラムを書かずに、層やニューロンの数を変えて学習させられます。
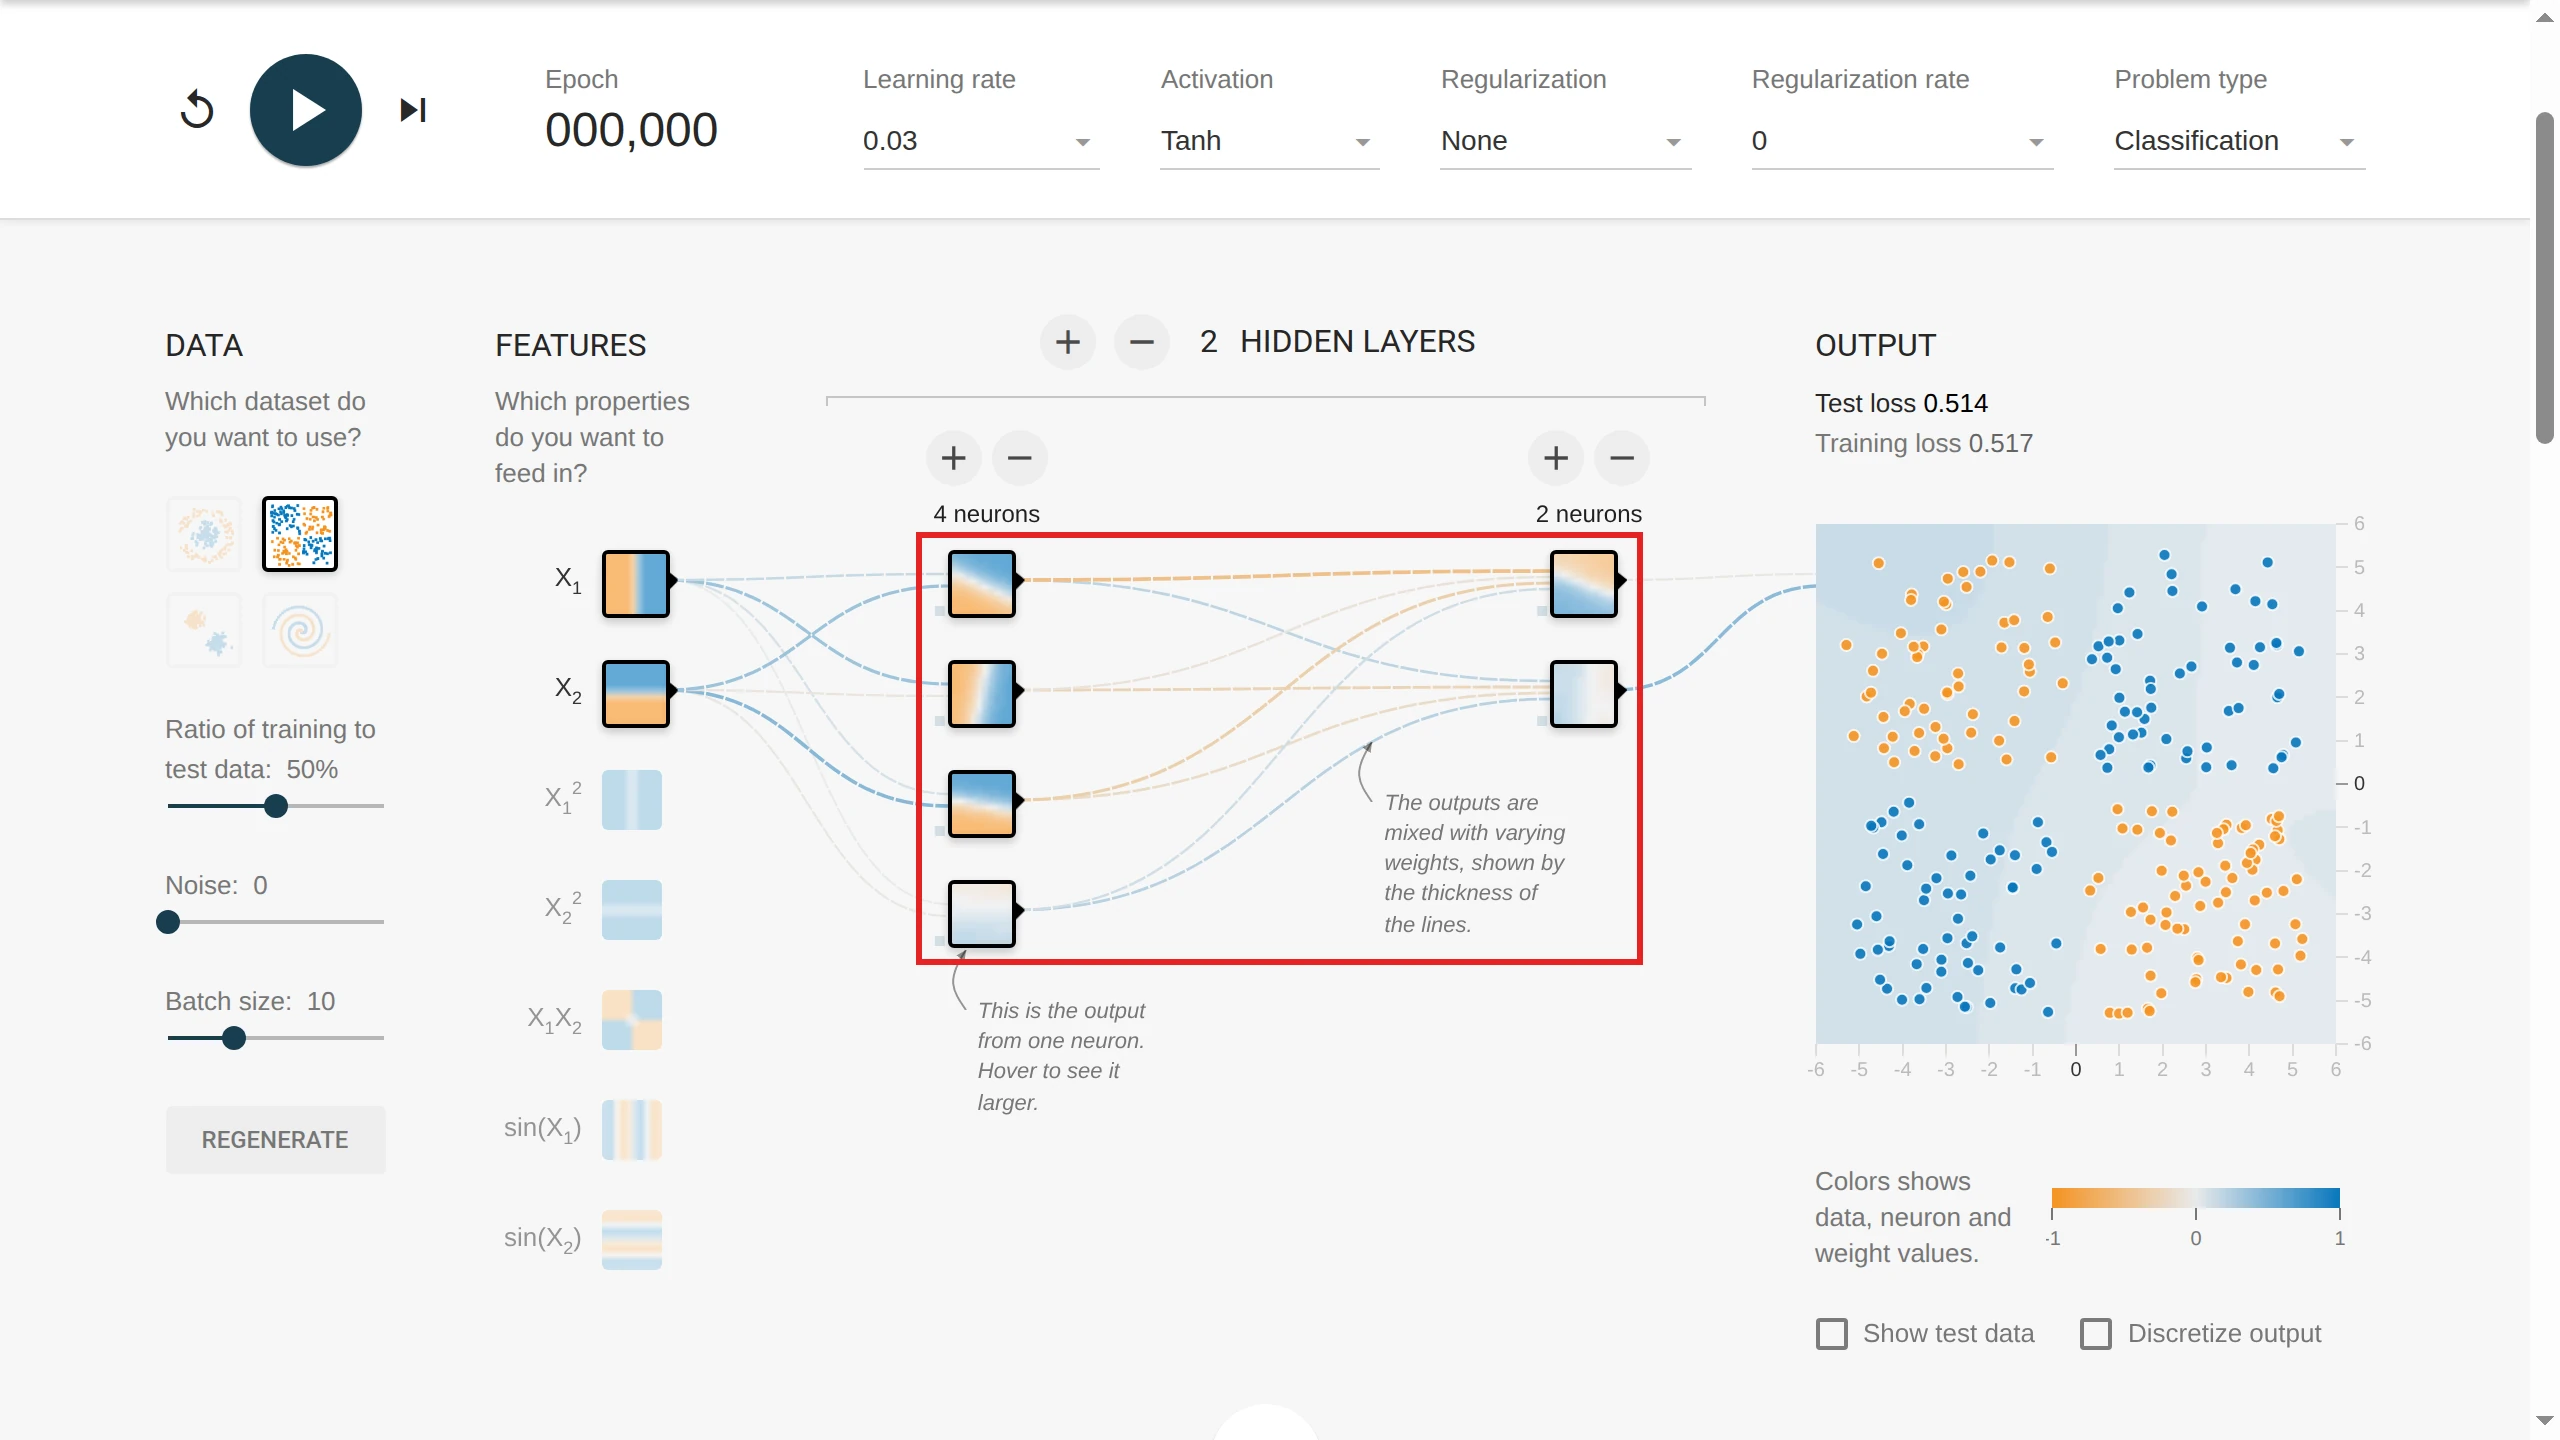
次の画面は、左のDATAで「Exclusive or」(XOR)のデータを選んだ設定です。
左上と右下がオレンジ、右上と左下が青の点で、まっすぐな線1本では2色に分けられないデータです。
入力は点の横の位置(X1)と縦の位置(X2)の2つで、隠れ層を2つ(ニューロン4個と2個)、活性化関数をtanhにしています。
学習の前(Epoch 0)の画面です。
赤枠の中の四角1つ1つがニューロンで、四角の中の模様は、入力の位置ごとにそのニューロンがどんな値を出すかを色で表しています。
ニューロンをつなぐ線が重みで、線の色が重みの正負(青が正、オレンジが負)、太さが重みの大きさです。
重みは乱数で初期化したばかりなので、どの線も細く、右の出力の背景の色も点の色と合っていません。
出力の上のTest loss(テストデータでの損失)は0.514です。
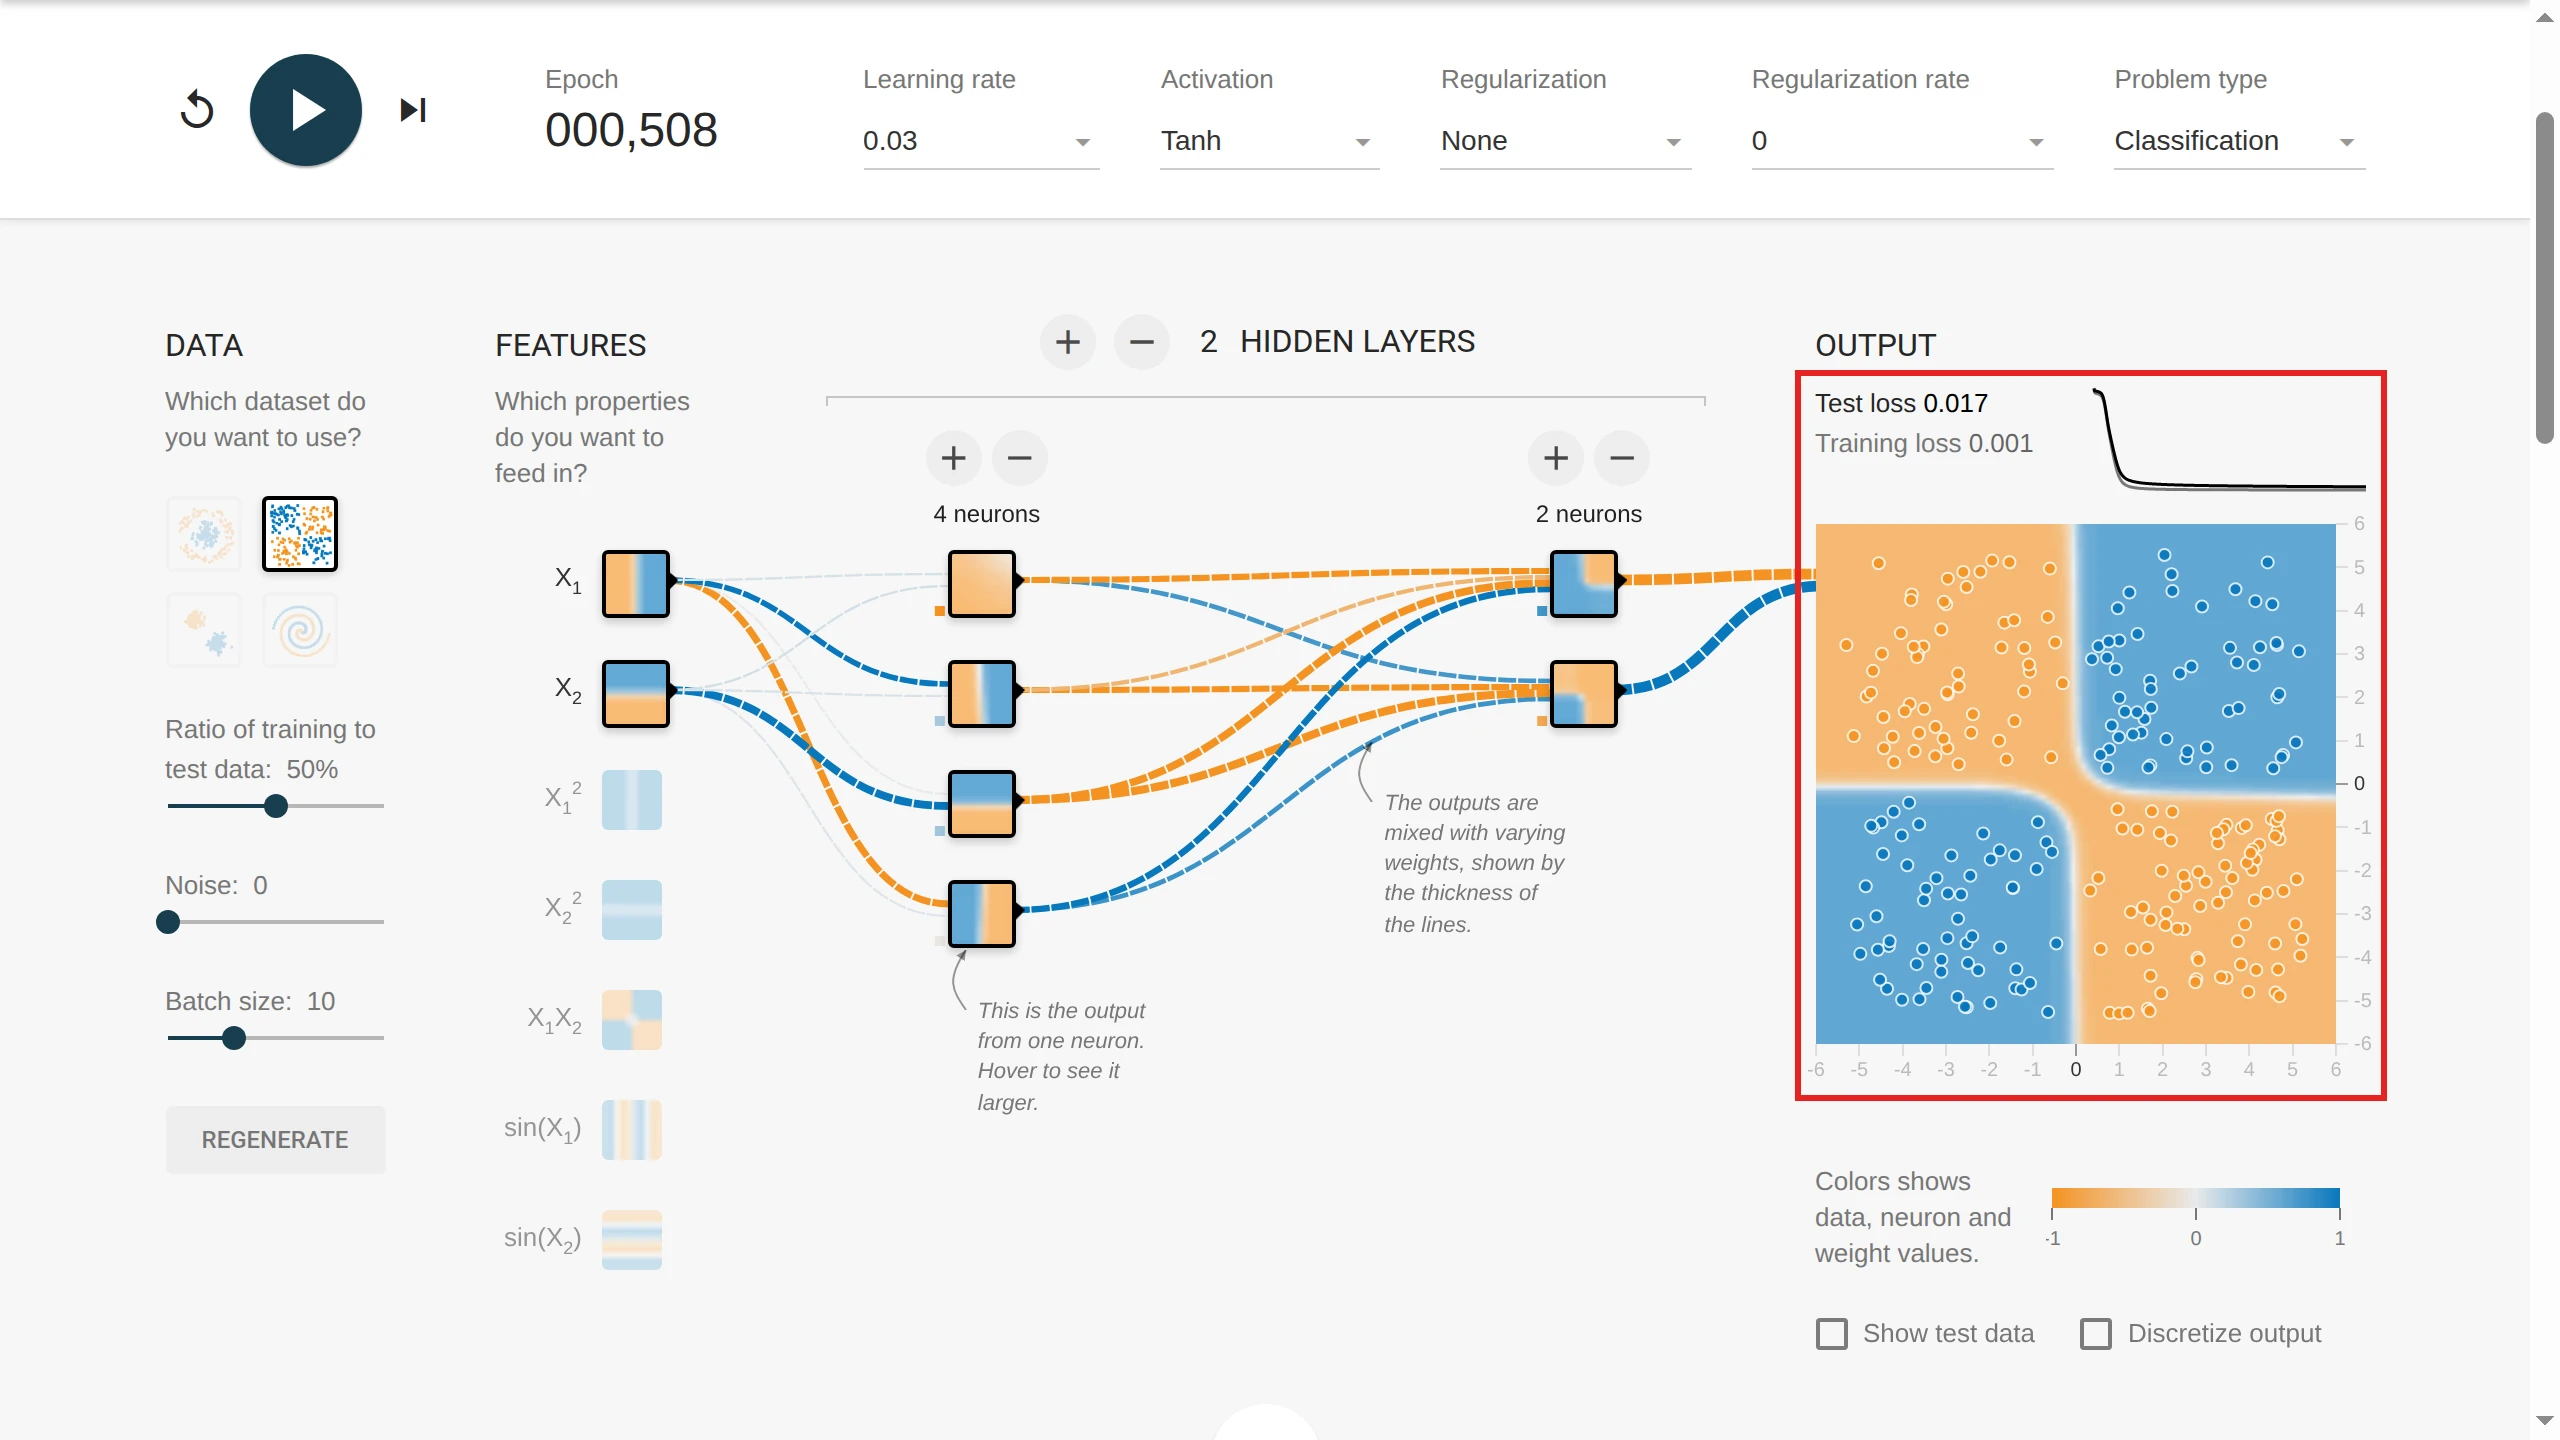
左上の再生ボタンで学習を進め、Epochが508になったところで止めた画面です。
Test lossは0.017まで下がり、赤枠の出力の背景が、オレンジの点の区画と青の点の区画にきれいに分かれました。
重みの線は太くなり、隠れ層のニューロンの模様も、データを分けるための形に変わっています。
入力は横と縦の位置の2つだけでも、隠れ層のニューロンが組み合わさって、まっすぐな線では分けられない区画を作れたことが分かります。
自分で試すときは、隠れ層を1つ減らす、ニューロンを1個にする、活性化関数をLinear(何も変換しない)にする、といった変更をして、同じように学習できるかを見比べると、層と活性化関数の役割がつかめます。
Pythonでディープラーニングを試す
ここからは、ディープラーニングでよく使われる言語のPythonと、ライブラリのPyTorchで、ニューラルネットワークを実際に学習させます。
どちらのコードも、GPUのない普通のパソコン(CPU)で数秒で終わります。
隠れ層がないと解けない問題(XOR)
XOR(排他的論理和)は、2つの入力が違うときだけ1、同じときは0になる問題です。
4つの点を、まっすぐな線1本では「0のグループ」と「1のグループ」に分けられません。
XORの入力と答え 隠れ層のないネットワーク(入力から出力へ直接つなぐもの)と、隠れ層を1つ入れたネットワークに、同じ回数だけ学習させて比べます。
import torch from torch import nn torch.manual_seed( 0 ) # XOR:2つの入力が違うときだけ1になる X = torch.tensor([[ 0 ., 0 .], [ 0 ., 1 .], [ 1 ., 0 .], [ 1 ., 1 .]]) y = torch.tensor([[ 0 .], [ 1 .], [ 1 .], [ 0 .]]) def train (model, steps = 2000 ): loss_fn = nn.BCEWithLogitsLoss() optimizer = torch.optim.Adam(model.parameters(), lr = 0.05 ) for _ in range (steps): loss = loss_fn(model(X), y) # 予測と答えのずれ(損失) optimizer.zero_grad() loss.backward() # 誤差逆伝播で、重みごとの直す向きを求める optimizer.step() # 重みを少しずつ直す pred = (model(X) > 0 ).float() return pred.flatten().tolist(), (pred == y).float().mean().item() # 隠れ層なし(入力から出力へ直接つなぐ) no_hidden = nn.Linear( 2 , 1 ) # 隠れ層1つ(ニューロン8個) one_hidden = nn.Sequential(nn.Linear( 2 , 8 ), nn.Tanh(), nn.Linear( 8 , 1 )) for name, model in [( "隠れ層なし" , no_hidden), ( "隠れ層あり" , one_hidden)]: pred, acc = train(model) print ( f " { name } : 予測 { pred } 正解率 { acc :.0% } " ) 実行した結果です。
隠れ層なし: 予測 [1.0, 0.0, 1.0, 0.0] 正解率 50%
隠れ層あり: 予測 [0.0, 1.0, 1.0, 0.0] 正解率 100%
隠れ層のないネットワークは、2,000回学習しても4つのうち2つしか当てられませんでした。
まっすぐな線1本で分けるしかないので、どう重みを直しても4つすべては当てられません。
活性化関数(ここではtanh)を挟んだ隠れ層を1つ入れると、4つすべてを当てることができました。
隠れ層が入力を別の見え方に変えることで、線1本では分けられなかった点を分けられるようになったためです。
手書きの数字を見分ける
次は、手書きの数字の画像を0〜9に見分けるネットワークを学習させます。
データには、scikit-learnに入っている手書きの数字1,797枚(8×8画素)を使い、7割の1,257枚で学習し、3割の540枚で正解率を測ります。
import torch from torch import nn from sklearn.datasets import load_digits from sklearn.model_selection import train_test_split torch.manual_seed( 0 ) # 1. データ:手書き数字の画像1797枚(8×8ピクセル)と、0〜9の答え digits = load_digits() X = torch.tensor(digits.data / 16 , dtype = torch.float32) # 明るさを0〜1にそろえる y = torch.tensor(digits.target) X_train, X_test, y_train, y_test = train_test_split( X, y, test_size = 0.3 , random_state = 0 , stratify = y) # 2. モデル:入力64 → 隠れ層64 → 隠れ層64 → 出力10 のニューラルネットワーク model = nn.Sequential( nn.Linear( 64 , 64 ), nn.ReLU(), nn.Linear( 64 , 64 ), nn.ReLU(), nn.Linear( 64 , 10 ), ) loss_fn = nn.CrossEntropyLoss() optimizer = torch.optim.SGD(model.parameters(), lr = 0.1 ) def accuracy (): with torch.no_grad(): return (model(X_test).argmax( dim = 1 ) == y_test).float().mean().item() print ( f "学習の前: 正解率 { accuracy() :.1% } " ) # 3. 学習:訓練データを32枚ずつ見て、損失が小さくなるように重みを直す for epoch in range ( 1 , 21 ): total = 0.0 for i in torch.randperm( len (X_train)).split( 32 ): loss = loss_fn(model(X_train[i]), y_train[i]) # 順伝播と損失 optimizer.zero_grad() loss.backward() # 誤差逆伝播 optimizer.step() # 勾配降下法で重みを更新 total += loss.item() * len (i) if epoch in ( 1 , 5 , 10 , 20 ): print ( f " { epoch } 周目: 損失 { total / len (X_train) :.3f } 正解率 { accuracy() :.1% } " ) # 4. 予測:テストデータの最初の5枚 with torch.no_grad(): print ( "予測:" , model(X_test[: 5 ]).argmax( dim = 1 ).tolist()) print ( "答え:" , y_test[: 5 ].tolist()) 実行した結果です。
学習の前: 正解率 10.9%
1周目: 損失 2.264 正解率 28.0%
5周目: 損失 0.558 正解率 86.3%
10周目: 損失 0.207 正解率 95.4%
20周目: 損失 0.093 正解率 94.6%
予測: [1, 4, 5, 6, 9]
答え: [1, 4, 5, 6, 9]
学習の前の正解率10.9%は、重みが乱数のままで、10個の数字から当てずっぽうに選ぶのとほぼ同じです。
周を重ねるにつれて損失が下がり、正解率は5周で86.3%、10周で95.4%まで上がりました。
20周目には、テストデータ540枚のうち511枚(94.6%)を当てています。
10周目より20周目の正解率がわずかに低いのは、損失はまだ下がっていても、テストデータでの当たり方は周によって少し上下するためです。
学習の回数を増やせば増やすほど良くなるわけではないので、テストデータ(実際の開発では検証用のデータ)の正解率を見ながら、どこで学習を止めるかを決めます。
コードの3の部分が、仕組みの節で説明した学習の流れそのものです。
model(X_train[i]) が順伝播、loss_fn が損失の計算、loss.backward() が誤差逆伝播、optimizer.step() が勾配降下法による重みの更新に当たります。
誤差逆伝播で勾配を求める計算は、PyTorchが自動で行います。
試す環境
上のコードは、Python 3.12、PyTorch 2.15.0(CPU版)、scikit-learn 1.9.1で動かしました。
PyTorchは、研究から製品への組み込みまで使われるオープンソースのディープラーニングのフレームワークです。
公式サイトの「Get Started」で、OS、インストール方法(Pip)、計算の装置(CPU)を選ぶと、インストール用のコマンドが表示されます。
2026年11月19日の時点で、WindowsとmacOSのCPU版は次のコマンドでインストールでき、Python 3.11以上が必要です。
pip3 install torch torchvision
pip3 install scikit-learn
Linuxでは、1行目が pip3 install torch torchvision --index-url https://download.pytorch.org/whl/cpu になります。
2行目は、手書きの数字のデータを読み込むためのscikit-learnをインストールするコマンドです。
ディープラーニングのフレームワークには、PyTorchのほかにTensorFlowなどもあります。
ディープラーニングの主な種類
ディープラーニングのネットワークは、扱うデータの形とやりたいことに合わせて、層のつなぎ方を変えたいくつもの種類があります。
上で動かした、層のすべてのニューロンを次の層のすべてのニューロンにつなぐ形は、全結合ネットワーク(多層パーセプトロン)と呼ばれる最も基本の形です。
ここでは、よく使われる7つの種類を紹介します。
ディープラーニングの主な7つの種類
種類 得意なデータ 仕組みの要点 使われる例 CNN(畳み込みニューラルネットワーク) 画像 小さなフィルターを画像の上でずらしながら、近くの画素どうしの模様を見つける 画像認識、物体の検出、外観の検査 RNN(再帰型ニューラルネットワーク) 順番のあるデータ 前の時点の出力を次の計算に戻し、順番の流れを覚える。長い流れを扱えるよう改良したものがLSTM 音声認識、時系列の予測 Transformer 文章などの並び Attention(注意)の仕組みで、並びの中のどの部分どうしが関係するかを一度に計算する LLM、機械翻訳、画像認識 オートエンコーダー 画像、数値のデータ 入力を小さく圧縮してから元に戻すように学び、データの要点をつかむ ノイズの除去、異常の検知 GAN(敵対的生成ネットワーク) 画像 偽物を作るネットワークと、本物か偽物かを見分けるネットワークを競わせて学ぶ 画像の生成 拡散モデル 画像、音声、動画 データにノイズを少しずつ加える過程を逆にたどり、ノイズから新しいデータを作る 画像生成AI、動画生成AI GNN(グラフニューラルネットワーク) 点と線のつながり(グラフ) 点がつながった相手の情報を集めて、自分の情報を更新する SNSのつながりの分析、分子の性質の予測、おすすめ
1つのモデルが、いくつかの種類を組み合わせていることもよくあります。
たとえば、拡散モデルの中で、ノイズを取り除く部分にCNNやTransformerが使われます。
グラフニューラルネットワーク(GNN)
グラフニューラルネットワーク(GNN)は、点(ノード)と、点どうしをつなぐ線(エッジ)でできた「グラフ」の形のデータを扱うネットワークです。
SNSの人と人のつながり、分子の原子と結合、駅と路線、商品と買った人の関係などが、グラフで表せるデータです。
画像は画素が縦横のマス目にきれいに並んでいて、文章は単語が1列に並んでいます。
グラフは、点ごとにつながる相手の数がばらばらで、決まった並び方がないので、CNNやRNNのままでは扱いにくいデータです。
GNNでは、それぞれの点が、線でつながった相手の点の情報を集めて、自分の情報を更新します。
この更新を層の数だけくり返すと、各点に、すぐ隣の点だけでなく、線を何本かたどった先の点の情報まで行き渡ります。
「グラフニューラルネットワーク」という名前のモデルは、2009年にScarselliらが学術誌IEEE Transactions on Neural Networksで発表しました。
2017年には、KipfとWellingが、畳み込みニューラルネットワークの考え方をグラフの上で直接使えるようにしたGCN(グラフ畳み込みネットワーク)を、国際会議ICLRで発表しています。
実際に使われた例として、Google DeepMindはGoogleマップのチームと組み、道路の区間を点、つながる区間どうしを線にしたグラフをGNNで扱って、到着時間の予測の精度を上げた取り組みを2020年に紹介しています。
画像認識ならCNN、言葉ならTransformer、つながりのデータならGNN、のように、データの形から種類の見当をつけられます。
ディープラーニングの歴史
ニューラルネットワークの研究は1940年代に始まり、注目されては下火になる時期をくり返しながら、2010年代に大きく広がりました。
ディープラーニングの主な出来事
年 出来事 1943年 マカロックとピッツが、神経の活動を論理の計算として表す論文を発表 1958年 ローゼンブラットが、学習する仕組みのパーセプトロンを論文で発表 1969年 ミンスキーとパパートが『Perceptrons』を出版し、パーセプトロンにできることの限界を数学で示す 1979年 福島邦彦が、位置がずれても形を見分けられる神経回路モデル「ネオコグニトロン」を発表 1986年 ラメルハート、ヒントン、ウィリアムズが、誤差逆伝播で学ぶ方法の論文をNatureに発表 1998年 ルカンらが、勾配にもとづく学習を文書の認識に使う論文を発表 2006年 ヒントンらが、層の深いネットワーク(深い信念ネットワーク)を速く学習させる方法を発表 2012年 画像認識の競技会ILSVRC2012で、深い畳み込みニューラルネットワークを使ったトロント大学のチームが1位 2016年 Google DeepMindのAlphaGoが、囲碁棋士の李世乭(イ・セドル)に4勝1敗 2017年 Transformerの論文「Attention Is All You Need」が発表される 2019年 ベンジオ、ヒントン、ルカンが、2018年度のACMチューリング賞の受賞者に決まる 2022年 OpenAIがChatGPTを公開 2024年 ホップフィールドとヒントンが、ノーベル物理学賞を受賞
2012年のILSVRC2012では、1,000種類の物体を見分ける課題で、上位5つの予測に正解が入らなかった割合(誤り率)を競いました。
Krizhevsky、Sutskever、Hintonのチーム(SuperVision)の誤り率は15.3%で、2位のチームの26.2%を大きく下回りました。
2位のチームは、SIFTなど人が設計した画像の特徴量を組み合わせる方法を使っており、特徴量もデータから学ぶディープラーニングとの差が、数字ではっきり示されました。
2019年のチューリング賞は、ディープニューラルネットワークを計算の重要な要素にした発想と技術の突破が受賞の理由です。
2024年のノーベル物理学賞の授賞理由は、人工ニューラルネットワークによる機械学習を可能にした基礎的な発見と発明でした。
ディープラーニングでできること
ディープラーニングは、人が手がかりを書き出しにくい画像、音声、言葉のデータで、特に多く使われています。
ディープラーニングの主な使われ方
分野 できること 身近な例 画像 写っているものを見分ける、位置を見つける スマホの顔認証、写真の自動分類、工場の外観の検査 音声 話した言葉を文字にする、文字を声にする 音声入力、会議の文字起こし、動画の自動字幕、読み上げ 言葉 文章を理解して、訳す、まとめる、答える 機械翻訳、チャットボット、ChatGPTのような対話のAI 生成 新しい文章、画像、音声、動画を作る 画像生成AI、動画生成AI 予測と制御 先のことを予測する、行動を選ぶ 需要の予測、自動運転の認識、ゲームのAI
音声を文字にする技術を使って、動画に字幕を付ける方法は、自動字幕の付け方 で紹介しています。
ディープラーニングの課題
ディープラーニングを仕事で使うときは、次の点を考えておく必要があります。
データの量と質 :多くの例を集める必要があり、教師あり学習では一つひとつに正しい答えを付ける手間もかかります。データに誤りが多いと、誤りもそのまま学びます。計算資源 :学習には多くの計算が必要で、大きなモデルではGPUなどの演算装置と電力の費用がかかります。答えの理由が分かりにくい :何千、何万もの重みの組み合わせで答えを出すため、なぜその答えになったのかを人が説明しにくくなります。このように判断の根拠が外から見えない状態は、ブラックボックスと呼ばれます。過学習 :学習に使ったデータには当たるのに、新しいデータで外れることがあります。テストデータで確かめ、データを増やす、モデルを小さくするといった手当てをします。データの偏り :学習に使ったデータの偏りを、そのまま答えに持ち込みます。特定の人や場面のデータが少ないと、その場面で間違えやすくなります。 ディープラーニングの学び方
学ぶ順番
ディープラーニングは、次の順に進めると、仕組みと使い方の両方を身につけやすくなります。
1. 全体の地図をつかむ :AI、機械学習、ディープラーニングの関係と、できることと課題を押さえます。この記事の前半の範囲です。2. Pythonの基本を覚える :変数、リスト、関数、ライブラリの読み込みが分かれば、この記事のコードを読めます。3. 1つのネットワークを手で追う :ニューロンの計算、活性化関数、損失、誤差逆伝播を、小さな例で計算してみます。微分、行列、確率の基礎は、ここで必要な部分から学べば十分です。4. フレームワークで動かす :PyTorchなどで、手書きの数字のような小さなデータを学習させ、層の数や学習率を変えて結果がどう変わるかを試します。5. 使いたい分野に進む :画像ならCNN、言葉ならTransformerのように、使いたい分野の種類と、学習済みのモデルを使う方法を学びます。 目的別の本
ディープラーニングの本は、数式やコードをどこまで扱うかで性格が大きく違います。
いまの自分に合う1冊から始め、物足りなくなったら次の段階に進むと、途中で挫折しにくくなります。
ディープラーニングを学ぶ本(目的別)
目的 本(出版社、発行年) 内容 背景と考え方を知る 松尾豊『人工知能は人間を超えるか ディープラーニングの先にあるもの』(KADOKAWA、2015年) ディープラーニングと、それまでのAIの研究の歩みを解きほぐし、知能とは何かを問い直す 図で仕組みをつかむ 山下隆義『イラストで学ぶ ディープラーニング 改訂第2版』(講談社、2018年) 図を使った解説。RNN、GAN、深層強化学習の章もある 作りながら理解する 斎藤康毅『ゼロから作るDeep Learning』(オライリー・ジャパン、2016年) 外部のライブラリに頼らず、Pythonでゼロから作って、誤差逆伝播法やCNNを実装の段階で理解する 理論を体系的に学ぶ 岡谷貴之『深層学習 改訂第2版』(講談社、2022年) 勾配降下法、誤差逆伝播法から、CNN、グラフのネットワーク、生成モデルまで 理論を深く学ぶ Goodfellow、Bengio、Courville『深層学習』(KADOKAWA、2018年) 英語の教科書『Deep Learning』(MIT Press、2016年)の日本語版 G検定の対策 日本ディープラーニング協会『深層学習教科書 ディープラーニングG検定(ジェネラリスト)公式テキスト 第3版』(翔泳社、2024年) G検定の範囲の知識を広く扱う入門の解説書
数式に不安があるなら、松尾豊さんの本で全体の流れをつかみ、山下隆義さんの本で図を見ながら仕組みを追うと入りやすくなります。
松尾豊さんの本は2015年の発行で、2017年のTransformerより前の、ディープラーニングが注目され始めたころの流れを扱っています。
Pythonを少し書けるなら、『ゼロから作るDeep Learning』で、この記事のニューロンの計算や誤差逆伝播を、自分のコードで確かめられます。
同じシリーズには、自然言語処理編、フレームワーク編、強化学習編、生成モデル編、LLM編も出ています。
理論をきちんと学びたい人には、岡谷貴之さんの『深層学習 改訂第2版』が合います。
改訂版ではTransformer、グラフニューラルネットワーク、生成モデルが大きく書き足されています。
Goodfellowらの『Deep Learning』は、英語版を著者のWebサイトで無料で読めるので、日本語版と行き来しながら読むこともできます。
資格で確かめる
学んだ知識を確かめる資格には、日本ディープラーニング協会(JDLA)のG検定とE資格があります。
JDLAのG検定とE資格
資格 認定する力 受験の条件 G検定 AI・ディープラーニングを活用するための知識 制限なし E資格 ディープラーニングの理論を理解し、手法を選んで実装する力 JDLA認定プログラムを試験日の過去2年以内に修了
G検定は、ディープラーニングを仕事に生かす立場の人向けで、オンラインで自宅から受けることもできます。
試験の内容と勉強の進め方は、G検定とは で説明しています。
E資格は、ディープラーニングを実装するエンジニア向けで、PyTorchかTensorFlowのどちらかを選んで解く問題があります。
ほかのAIの資格との違いは、AI資格の種類と選び方 で比べています。
人に説明する
社内の勉強会や研修で、ディープラーニングを人に説明する場面もあります。
文章や図だけで伝わりにくいときは、短い解説動画にすると、同じ内容を何度でも見返してもらえます。
NoLangで作ったAIの解説動画の作例は、2つの記事で見られます。
AIとは には、猫の写真を見分ける例でAI、機械学習、ディープラーニングの関係を説明する動画を、機械学習とは には、社内のAI研修の資料から作った動画を載せています。
手元に勉強会の資料(PDFかPowerPoint)があれば、NoLangのホームの「資料から作成」から、その資料をもとに動画を作れます。
勉強会の資料を、 解説の動画にしよう
NoLangで動画を作る 会社でディープラーニングを学ぶ動画を使うには
社内のAI研修やDX研修の資料(PDF、PowerPoint)から研修動画を作れば、社員が自分の時間に同じ内容を見て学べます。
法人向けの使い方は研修動画のページ で紹介しています。
自社の教材から動画を作れるかどうかはお問い合わせ から相談でき、サービスの詳しい資料は下のボタンから請求できます。
資料をダウンロード