クラスタリングとは
クラスタリングとは、答え(ラベル)のついていないデータを、似ているものどうしのグループ(クラスター)に分ける手法です。
教師なし学習の代表的な手法で、クラスター分析とも呼ばれます。
たとえば顧客ごとの購入回数と購入金額を渡すと、「何度も少しずつ買う顧客」「たまにまとめて買う顧客」のようなグループに分けます。
手法が手がかりにするのは、データどうしが似ているかどうかだけです。
似ているかどうかは、データどうしの距離で測ります。
分けたグループが何を表すかを読み取り、名前を付けるのは人の仕事です。
クラスタリングと分類の違い
分類は、答えのついたデータから学び、新しいデータがどのグループに入るかを当てる教師あり学習です。
クラスタリングは、グループの答えを渡さずに、データどうしの近さからグループそのものを作ります。
クラスタリングと分類の違い
| 項目 | クラスタリング | 分類 |
|---|
| 学習の種類 | 教師なし学習 | 教師あり学習 |
|---|
| 使うデータ | 答えのないデータ | 答えのついたデータ |
|---|
| グループ | データから見つける | 前もって決まっている |
|---|
| 主な手法 | k-means、階層的クラスタリング、DBSCAN | 決定木、ランダムフォレスト、SVM |
|---|
| 例 | 買い方の似た顧客をまとめる | 迷惑メールかどうかを当てる |
|---|
階層的クラスタリング
階層的クラスタリングは、近いデータどうしを順にまとめて、グループの階層を作る手法です。
よく使う凝集型(ボトムアップ)の手順は次のとおりです。
- データ1件ずつを、それぞれ1つのグループとみなす
- いちばん近い2つのグループを、1つにまとめる
- 全部が1つのグループになるまで、2をくり返す
まとめた順は、デンドログラム(樹形図)と呼ぶ木の形の図で表します。
下の端に1件ずつのデータが並び、まとめた2つのグループが、まとめたときの距離を表す高さでつながります。
図をある高さで横に切ると、その高さより下でつながったものが1つのグループになるので、グループの数を後から選べます。
グループどうしの距離の測り方を連結法と呼び、どれを選ぶかでまとまり方が変わります。
階層的クラスタリングの主な連結法
| 連結法 | 2つのグループの距離 |
|---|
| ウォード法 | まとめたときに、グループの中のばらつきの増え方が最も小さい組を選ぶ |
|---|
| 群平均法 | 2つのグループのデータの、すべての組の距離の平均 |
|---|
| 最短距離法 | 2つのグループで、最も近いデータどうしの距離 |
|---|
| 最長距離法 | 2つのグループで、最も遠いデータどうしの距離 |
|---|
scikit-learnの公式のドキュメントによると、凝集型の階層的クラスタリングは大きさの偏ったグループを作りやすく、最短距離法で最も偏り、ウォード法で最も大きさがそろいやすくなります。
最短距離法は、近いデータが鎖のようにつながっていくので、1つの大きなグループと、ごく小さなグループに分かれる結果になりがちです。
後のPythonの例と同じワインのデータで試すと、群平均法と最短距離法は、178件のうち174件を1つのグループに入れました(Pythonの例ではウォード法を使います)。
階層的クラスタリングは、すべてのデータの組の距離を使うので、データの件数が多いと計算量が増えます。
k-means
k-means(k平均法)は、グループの数kを先に決め、データをk個のグループに分ける手法です。
階層を作らないので、非階層的クラスタリングと呼ばれます。
- k個の中心の位置を決める
- 各データを、いちばん近い中心のグループに入れる
- グループごとにデータの平均の位置を求め、新しい中心にする
- 中心がほとんど動かなくなるまで、2と3をくり返す
最初の中心の置き方で結果が変わるので、中心どうしが離れやすいように選ぶk-means++という方法がよく使われ、scikit-learnの既定にもなっています。
計算が軽く、データの件数が多くても使いやすい手法です。
k-meansを使うときは、次の点に気をつけます。
- グループの数kを、前もって自分で決める必要がある
- 丸くまとまったグループを前提にしているので、細長い形や入り組んだ形のグループは分けにくい
- 外れ値があると、中心がその方向へ引っ張られる
- 単位の大きい項目が距離をほとんど決めてしまうので、項目の単位をそろえる必要がある
DBSCANと混合ガウスモデル
DBSCANは、データが密に集まった所を1つのグループとみなす手法です。
決めた半径(eps)の中に、決めた数(min_samples)以上のデータがある点を核にして、つながった範囲を1つのグループにします。
グループの数を先に決めなくてよく、データが密集したどの領域にも入らないデータは、外れ値(ノイズ)として残ります。
k-meansと違い、どんな形のグループでも見つけられます。
混合ガウスモデルは、データがいくつかの正規分布(ガウス分布)の重なりから生まれたとみなす手法です。
各データがどのグループに入るかを確率で表すので、境目にあるデータを「グループAに入る確率が7割」のように扱えます。
クラスター数の決め方
k-meansのようにグループの数を先に決める手法では、kを変えて結果を比べ、よい数を探します。
よく使う方法は、エルボー法とシルエット係数です。
エルボー法は、kを1つずつ増やしながら、各データとそのグループの中心との距離の2乗の合計を記録する方法です。
この合計はクラスター内誤差平方和と呼ばれ、scikit-learnではinertiaという名前で取り出せます。
kを増やすほど合計は小さくなりますが、ある数を境に減り方が急に緩やかになります。
グラフにしたときに腕のひじ(エルボー)のように曲がる所のkを、グループの数の目安にします。
はっきり曲がらないデータも多いので、シルエット係数と合わせて見ます。
シルエット係数は、各データが自分のグループの中でどれだけ近く、隣のグループからどれだけ離れているかを、-1から1の値で表す指標です。
1に近い値はグループがはっきり分かれていることを、0に近い値はグループが重なっていることを、負の値はそのデータに別のグループのほうが近いことを表します。
全データの平均が最も大きくなるkを選ぶのが、1つの目安です。
数字だけで決めず、分けたグループに仕事で使える意味を読み取れるかも合わせて確かめます。
3つに分けても4つに分けても値がほとんど変わらないなら、施策を分けて打てる数を選ぶといった決め方もできます。
クラスタリングの活用例
クラスタリングは、次のような場面で使われています。
クラスタリングの主な活用例
| 使い道 | 入力する特徴量の例 | 分けた後の使い方 |
|---|
| 顧客のグループ分け | 購入回数、購入金額、最後の購入からの日数 | グループごとに案内やクーポンを変える |
|---|
| 問い合わせや文書の整理 | 文章を数の並びに変えたもの | 似た問い合わせをまとめ、よくある質問を作る |
|---|
| 異常の検知 | 機械のセンサーの値 | どのグループからも遠いデータを点検の候補にする |
|---|
| 画像の領域分け | 画素の色と位置 | 写真の中の物と背景を分ける |
|---|
顧客のグループ分けは、セグメンテーションとも呼ばれます。
クラスタリングで分けたグループの番号を、別の予測のモデルの特徴量に加える使い方もあります。
決定木とは
決定木とは、「はい」か「いいえ」で答えられる条件でデータを枝分かれさせ、最後にたどり着いた所で答えを出す教師あり学習の手法です。
木を逆さにした形で表し、いちばん上の分かれ目を根(ルートノード)、途中の分かれ目を節(ノード)、最後の答えを葉(リーフ)と呼びます。
答えがグループのときは分類木、数値のときは回帰木と呼びます。
たとえば、契約を続けるかやめるかを当てる分類木なら、「月の利用日数が10日以下か」「問い合わせが3回以上か」のような条件を根から順にたどり、葉で「続ける」か「やめる」かを決めます。
分類木は葉にあるデータで最も多い答えを、回帰木は葉にあるデータの数値の平均を予測にします。
分かれ目の選び方
決定木は、データを最もきれいに分けられる条件を、根から順に1つずつ選びます。
きれいさは、分けた後のグループに違う答えがどれだけ混ざっているか(不純度)で測ります。
分類木では、ジニ不純度かエントロピーを使います。
ジニ不純度は、グループからデータを2つ取り出したときに答えが違う確率で、答えが1種類だけのグループなら0になります。
エントロピーは、答えの混ざり具合を情報量で表したもので、分ける前より分けた後にどれだけ下がったか(情報利得)で条件を選びます。
scikit-learnの分類木の既定はジニ不純度です。
回帰木では、分けた後のグループの中で数値のばらつきが小さくなる条件を選び、scikit-learnの既定は二乗誤差です。
決定木分析
決定木分析は、決定木を、予測だけでなくデータを理解するために使う方法です。
マーケティングでは、年齢、地域、購入の履歴などの顧客の属性から、狙う顧客の条件を見つけるのに使われます。
「商品を買った人」と「買わなかった人」のデータから木を作ると、根に近い分かれ目ほど、買うかどうかを大きく分けた条件が並びます。
葉ごとに、当てはまる人の数と買った人の割合が分かるので、「週に3回以上使い、30代の人は買った割合が高い」のように、狙う顧客の条件を言葉で説明できます。
決定木の長所と短所
決定木の長所は次のとおりです。
- 分かれ方をそのまま読めるので、予測の理由を説明しやすい
- 項目の単位をそろえるなどの前処理が、ほとんど要らない
短所は次のとおりです。
- 深く分けすぎると、学習に使ったデータの細かな違いまで覚えてしまい、新しいデータで当たりにくくなる(過学習)
- データが少し変わるだけで、木の形が大きく変わることがある
- 予測が葉の数に応じた階段状になるので、学習データの範囲の外の数値は、うまく予測できない
過学習は、木の深さの上限(max_depth)や、葉に残すデータの最小の数(min_samples_leaf)を決めて抑えます。
いったん作った木から、効き目の小さい枝を切り落とす剪定(せんてい)も使います。
1本の木の弱さを、たくさんの木を組み合わせて補うのが、次のランダムフォレストと勾配ブースティング決定木です。
複数のモデルを組み合わせて予測する方法を、アンサンブル学習と呼びます。
ランダムフォレストとは
ランダムフォレストとは、少しずつ違う決定木をたくさん作り、それぞれの答えをまとめて予測するアンサンブル学習の手法です。
2001年にレオ・ブレイマン(Leo Breiman)が論文で発表しました。
ランダムフォレストの仕組み
ランダムフォレストは、木ごとの違いを、2つのランダムな選び方で作ります。
- 学習データから、同じデータを重ねて選ぶことを許して、元と同じ件数をランダムに取り出し(ブートストラップ)、木ごとに違うデータで学習させる
- 分かれ目を選ぶたびに、全部の特徴量ではなく、ランダムに選んだ一部の特徴量の中から条件を選ぶ
ブートストラップで取り出したデータで学習した複数のモデルをまとめる方法を、バギングと呼びます。
ランダムフォレストは、バギングで作る決定木に、2つめのランダムな選び方を足したものです。
答えのまとめ方は、分類では木の多数決、回帰では木の答えの平均です。
ただしscikit-learnの分類では、多数決の代わりに、各木が出したグループごとの確率を平均し、最も高いグループを答えにします。
1本ずつの木は過学習していても、木ごとに間違え方が違うので、まとめると誤りが打ち消し合います。
その結果、1本の決定木より新しいデータで当たりやすく、結果も安定します。
決定木とランダムフォレストの違い
決定木とランダムフォレストの違い
| 項目 | 決定木 | ランダムフォレスト |
|---|
| 木の数 | 1本 | たくさん(scikit-learnの既定は100本) |
|---|
| 学習データ | すべて | 木ごとにブートストラップで取り出す |
|---|
| 分かれ目の候補 | すべての特徴量 | ランダムに選んだ一部の特徴量 |
|---|
| 予測の理由 | 木を読めば分かる | 木が多いので、特徴量の重要度で傾向を見る |
|---|
| 過学習 | 起きやすい | 起きにくい |
|---|
| 計算の量 | 少ない | 木の数に応じて増える |
|---|
ランダムフォレストの回帰
ランダムフォレストは、売上や価格のような数値を予測する回帰にも使えます。
回帰木をたくさん作り、各木の予測の平均を答えにします。
scikit-learnでは、分類にRandomForestClassifier、回帰にRandomForestRegressorを使います。
分かれ目を選ぶときの特徴量の候補の数の既定は、分類では特徴量の数の平方根、回帰ではすべての特徴量です。
特徴量の重要度
ランダムフォレストでは、各特徴量が分かれ目で不純度をどれだけ下げたかを全部の木で平均し、特徴量の重要度として出せます。
どの項目が予測に効いているかを知る目安になり、scikit-learnでは値の合計が1になるように出します。
この重要度には、scikit-learnの公式のドキュメントが挙げる2つの注意があります。
1つは、学習に使ったデータから計算するので、新しいデータの予測に役立つ特徴量とずれることがある点です。
もう1つは、IDのように値の種類が多い特徴量を高く見積もりやすい点です。
気になるときは、特徴量の値を並べ替えたときに精度がどれだけ下がるかで測る、並べ替えの重要度(permutation importance)と比べます。
勾配ブースティング決定木とは
勾配ブースティング決定木(GBDT)とは、決定木を1本ずつ順に足し、前までの木の予測の誤りを、次の木で小さくするように学習させる手法です。
誤りが小さくなる向き(損失関数の勾配)に合わせて次の木を作るので、この名前が付いています。
ランダムフォレストとの違いは、木の作り方です。
ランダムフォレストは木を互いに関係なく作って平均し、勾配ブースティングは木を順番に作って前の木の間違いを直していきます。
scikit-learnの公式のドキュメントは、勾配ブースティング決定木を、表の形のデータの分類と回帰に優れたモデルと説明しています。
代表的なライブラリに、XGBoost、LightGBM、CatBoostがあります。
どれも決定木の勾配ブースティングのライブラリで、CatBoostはカテゴリの項目をそのまま扱えることを特徴に挙げています。
scikit-learnにも、GradientBoostingClassifierと、計算を速くしたHistGradientBoostingClassifierがあり、データが1万件以上ならHistGradientBoostingClassifierのほうがずっと速いと公式のドキュメントにあります。
SVM(サポートベクターマシン)とは
SVM(サポートベクターマシン)とは、グループの境目を、境目に最も近いデータからの距離(マージン)が最も大きくなるように引く教師あり学習の手法です。
境目に最も近いデータをサポートベクターと呼び、境目はこのデータだけで決まります。
まっすぐな線で分けられないデータには、カーネルという計算を使って曲がった境目を引きます。
scikit-learnの分類のSVM(SVC)は、既定でRBFカーネルを使います。
scikit-learnの公式のドキュメントは、SVMの長所に、特徴量の数が多いデータで有効なことや、データの件数より特徴量の数が多くても使えることを挙げています。
データどうしの距離で境目を決めるので、特徴量の単位をそろえてから使います。
特徴量とは
特徴量とは、機械学習のモデルが予測の手がかりにする、データの項目です。
数値でない項目も、数に変えてから渡します。
予測したい答えのほうは、目的変数やラベルと呼び、特徴量は統計学の言葉で説明変数とも呼ばれます。
たとえば住宅の価格を予測するなら、広さ、駅からの距離、築年数が特徴量で、価格が目的変数です。
後のPythonの例では、ワインのアルコール度数や色の濃さなど13の成分の測定値が特徴量で、ワインの種類が目的変数です。
特徴量エンジニアリング
特徴量エンジニアリングとは、元のデータから、モデルが学びやすい特徴量を作ったり整えたりする作業です。
特徴量設計とも呼ばれます。
主な作業は次のとおりです。
特徴量エンジニアリングの主な作業
| 作業 | すること | 例 |
|---|
| 欠損値の処理 | 空いている値を埋めるか、その行を除く | 年齢の空欄を平均で埋める |
|---|
| 単位をそろえる | 項目ごとに、平均や散らばりをそろえる | 金額と回数を同じ目盛りにする |
|---|
| カテゴリを数に変える | 文字の値を、0と1の列に分ける | 都道府県を47の列にする |
|---|
| 集計する | 1回ごとの記録を、人や月ごとにまとめる | 顧客ごとの購入回数を出す |
|---|
| 日時から作る | 日付から曜日や経過日数を取り出す | 最後の購入からの日数を出す |
|---|
| 組み合わせる | 2つの項目から新しい値を作る | 合計金額を回数で割る |
|---|
単位をそろえる作業には、各項目から平均を引いて標準偏差で割り、平均0、標準偏差1にそろえる標準化がよく使われます(scikit-learnのStandardScaler)。
カテゴリを0と1の列に分ける方法は、ワンホットエンコーディングと呼びます。
単位をそろえる作業は、k-meansやSVMのように、データどうしの距離を使う手法で特に効きます。
決定木やランダムフォレストは、1つの特徴量の大小だけで分かれ目を決めるので、単位をそろえる前処理がほとんど要りません。
特徴量選択と特徴量抽出
特徴量が多すぎると、学習に時間がかかり、予測に関係のない項目に引っ張られて過学習しやすくなります。
特徴量を減らす方法には、特徴量選択と特徴量抽出があります。
特徴量選択は、元の特徴量の中から、予測に役立つものだけを残す方法です。
答えとの関係の強さで上位の特徴量を選ぶ(scikit-learnのSelectKBest)、モデルが計算した重要度の高い特徴量を残す、といったやり方があります。
元の項目がそのまま残るので、何を使ったモデルかを説明しやすい方法です。
特徴量抽出は、元の特徴量を組み合わせて、少ない数の新しい特徴量を作る方法です。
代表的な主成分分析(PCA)は、たくさんの項目を、データのばらつきをよく表す少ない軸にまとめます。
少ない数に情報をまとめられる一方で、できた軸が何を表すかは読み取りにくくなります。
画像や文章のような元のデータから、数の特徴量を取り出す作業も、特徴量抽出と呼ばれます。
手法の選び方
手元のデータとやりたいことから、手法は次のように選べます。
データとやりたいことから選ぶ
| やりたいこと | データ | 合う手法 |
|---|
| 似たものをまとめて傾向をつかむ | 答えがない | k-means、階層的クラスタリング |
|---|
| 外れ値や入り組んだ形のまとまりを見つける | 答えがない | DBSCAN |
|---|
| 予測の理由を言葉で説明する | 答えがある | 決定木 |
|---|
| 表のデータで安定して当てる | 答えがある | ランダムフォレスト |
|---|
| 表のデータで精度を詰める | 答えがある | 勾配ブースティング決定木 |
|---|
| 特徴量が多く、件数はそれほど多くない | 答えがある | SVM |
|---|
グループの数を先に決められるならk-means、データを見てから決めたいなら、デンドログラムで後から選べる階層的クラスタリングが使いやすい手法です。
答えのあるデータでは、理由を説明する場面なら浅い決定木、当てることを優先するならランダムフォレストや勾配ブースティング決定木を、同じデータで比べて選びます。
Pythonで手法を比べる
scikit-learnに付いているワインのデータで、ここまでの手法を動かして比べます。
イタリアの同じ地域で造られたワイン178本の、アルコール度数や色の濃さなど13の成分の測定値と、3つの種類(0、1、2)の答えが入ったデータです。
項目によって値の大きさがまったく違い、たとえばプロリン(アミノ酸の一種)は278から1680、色合い(hue)は0.48から1.71の範囲にあります。
下の結果は、Python 3.11.9、scikit-learn 1.9.1、pandas 3.1.1で動かしたものです。
scikit-learnとpandasを入れた環境(pip install scikit-learn pandas)で、上から順に動かせます。
バージョンが違うと、数値が少し変わることがあります。
決定木のルールを見る
答えつきのデータを、学習用の7割とテスト用の3割に分け、深さ2までの決定木を学習させて、分かれ方のルールを文字で表示します。
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, export_text

# ワイン178本の成分(13項目)と、3つの種類(0、1、2)の答え
X, y = load_wine(return_X_y=True, as_frame=True)

# 7割を学習用、3割をテスト用に分ける
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

# 深さ2までの決定木を学習し、分かれ方のルールを文字で表示する
tree = DecisionTreeClassifier(max_depth=2, random_state=0)
tree.fit(X_train, y_train)
print(export_text(tree, feature_names=list(X.columns)))
|--- proline <= 765.00
|   |--- flavanoids <= 1.40
|   |   |--- class: 2
|   |--- flavanoids >  1.40
|   |   |--- class: 1
|--- proline >  765.00
|   |--- flavanoids <= 2.17
|   |   |--- class: 2
|   |--- flavanoids >  2.17
|   |   |--- class: 0
根の条件はプロリン(proline)が765以下かどうかで、次にフラボノイド(flavanoids)の量で分かれます。
プロリンが765より多く、フラボノイドが2.17より多ければ種類0、プロリンが765以下で、フラボノイドが1.40より多ければ種類1、という読み方です。
13の項目のうち2つだけで、どの種類かを決めるルールを、人が読める形で取り出せました。
深さの上限と過学習
同じデータで、木の深さの上限(max_depth)を変え、学習用とテスト用の正解率を比べます。
Noneは上限なしで、葉のデータが1つの答えだけになるまで分けます。
# 深さの上限を変えて、学習用とテスト用の正解率を比べる(Noneは上限なし)
for depth in [1, 2, 3, None]:
    model = DecisionTreeClassifier(max_depth=depth, random_state=0)
    model.fit(X_train, y_train)
    print(f"max_depth={depth}: 学習用 {model.score(X_train, y_train):.3f} / テスト用 {model.score(X_test, y_test):.3f}")
max_depth=1: 学習用 0.702 / テスト用 0.667
max_depth=2: 学習用 0.927 / テスト用 0.852
max_depth=3: 学習用 0.984 / テスト用 0.963
max_depth=None: 学習用 1.000 / テスト用 0.944
上限なしの木は、学習用のデータを1件も間違えませんでした(1.000)。
それでもテスト用の正解率は0.944で、深さ3の木の0.963より低くなりました。
学習用のデータの細かな違いまで覚えた分が、新しいデータでは役に立たなかったということで、これが過学習です。
4つの手法を比べる
決定木、ランダムフォレスト、勾配ブースティング決定木、SVMを、同じデータで比べます。
SVMは、項目の単位をそのまま渡したものと、StandardScalerで単位をそろえてから渡したものの2通りを試します。
1回の分け方による偶然の差を減らすため、データを5つに分け、4つで学習して残り1つで測ることを5回くり返し、正解率を平均します(交差検証)。
from sklearn.datasets import load_wine
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, HistGradientBoostingClassifier
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

X, y = load_wine(return_X_y=True, as_frame=True)

models = {
    "決定木": DecisionTreeClassifier(random_state=0),
    "ランダムフォレスト": RandomForestClassifier(random_state=0),
    "勾配ブースティング決定木": HistGradientBoostingClassifier(random_state=0),
    "SVM(単位をそろえない)": SVC(),
    "SVM(単位をそろえる)": make_pipeline(StandardScaler(), SVC()),
}

# データを5つに分け、4つで学習して残り1つで測ることを5回くり返した正解率の平均
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
for name, model in models.items():
    scores = cross_val_score(model, X, y, cv=cv)
    print(f"{name}: {scores.mean():.3f}")
決定木: 0.927
ランダムフォレスト: 0.972
勾配ブースティング決定木: 0.972
SVM(単位をそろえない): 0.657
SVM(単位をそろえる): 0.983
木を束ねたランダムフォレストと勾配ブースティング決定木は、どちらも1本の決定木(0.927)より高い0.972でした。
SVMは、単位をそろえないと0.657でしたが、そろえると0.983になり、この比較で最も高くなりました。
SVMはデータどうしの距離で境目を決めるので、値の範囲が大きい項目(プロリンは278から1680)ほど、結果への影響が大きくなります。
決定木と、決定木を束ねる2つの手法は、単位をそろえなくても0.927から0.972の正解率でした。
この数値は、このデータとこの設定での結果です。
手法の優劣はデータによって変わるので、自分のデータで同じように比べて選びます。
特徴量の重要度を見る
ランダムフォレストが、どの特徴量を分かれ目に多く使ったかを、重要度で見ます。
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier

X, y = load_wine(return_X_y=True, as_frame=True)

# ランダムフォレストが、どの特徴量を分かれ目に多く使ったか(重要度)
forest = RandomForestClassifier(random_state=0).fit(X, y)
importances = pd.Series(forest.feature_importances_, index=X.columns)
print(importances.sort_values(ascending=False).head(5).round(3))
proline                         0.194
flavanoids                      0.161
color_intensity                 0.145
alcohol                         0.111
od280/od315_of_diluted_wines    0.110
dtype: float64
上位は、プロリン、フラボノイド、色の濃さ(color_intensity)、アルコール度数(alcohol)でした。
上の決定木が根と次の分かれ目に使った2つが、ここでも上位の2つに入っています。
答えを使わずにクラスタリングする
同じデータから種類の答えを外し、13の成分の値だけでk-meansとウォード法のクラスタリングをします。
先にkを2から6まで変えてシルエット係数を比べ、次にk=3で分けたグループを、実際の種類と突き合わせます。
k-meansは最初の中心の置き方で結果が変わるので、n_init=10で10回やり直して最もよい結果を使い、random_stateで結果を固定しています。
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans, AgglomerativeClustering
from sklearn.metrics import silhouette_score

# 種類の答え(y)は学習に使わず、成分(X)だけを渡す
X, y = load_wine(return_X_y=True, as_frame=True)
X_scaled = StandardScaler().fit_transform(X)  # 13項目の単位をそろえる

# グループの数kを2〜6に変えて、シルエット係数を比べる
for k in range(2, 7):
    labels = KMeans(n_clusters=k, n_init=10, random_state=0).fit_predict(X_scaled)
    print(f"k={k}: {silhouette_score(X_scaled, labels):.3f}")

# k=3で分けたグループと、実際の種類を突き合わせる
raw = KMeans(n_clusters=3, n_init=10, random_state=0).fit_predict(X)
scaled = KMeans(n_clusters=3, n_init=10, random_state=0).fit_predict(X_scaled)
ward = AgglomerativeClustering(n_clusters=3, linkage="ward").fit_predict(X_scaled)
print(pd.crosstab(y, raw, rownames=["種類"], colnames=["k-means(単位そのまま)"]))
print(pd.crosstab(y, scaled, rownames=["種類"], colnames=["k-means(単位をそろえる)"]))
print(pd.crosstab(y, ward, rownames=["種類"], colnames=["階層的(ウォード法)"]))
k=2: 0.268
k=3: 0.285
k=4: 0.246
k=5: 0.203
k=6: 0.196
k-means(単位そのまま)   0   1   2
種類
0                 0  46  13
1                50   1  20
2                19   0  29
k-means(単位をそろえる)   0   1   2
種類
0                  0   0  59
1                 65   3   3
2                  0  48   0
階層的(ウォード法)   0   1   2
種類
0            0   0  59
1           58   8   5
2            0  48   0
シルエット係数はk=3が0.285で最も高く、答えを使わなくても、実際の種類の数と同じ3つが目安になりました。
突き合わせの表は、行が実際の種類、列がクラスタリングで分けたグループの番号で、数はワインの本数です。
グループの番号は手法が付けた順番で、種類の番号とは対応しません。
単位をそのまま使ったk-meansでは、どの種類も2つ以上のグループに散らばりました。
この分け方は、プロリンの1項目だけでk-meansをしたときとまったく同じで、値の範囲の大きいプロリンが距離をほとんど決めていたことになります。
単位をそろえると、種類0の59本と種類2の48本はそれぞれ1つのグループにまとまり、種類1も71本のうち65本が1つのグループに入りました。
ウォード法でも、種類0と種類2はそれぞれ1つのグループにまとまりました。
答えを一度も見せていないのに、成分の近さだけで、実際の種類に近いグループに分かれたことになります。
購入の記録から特徴量を作る
最後に、特徴量エンジニアリングの例として、1回ごとの購入の記録から、顧客ごとの特徴量を作ります。
最後の購入からの日数(recency)、購入回数(frequency)、合計金額(monetary)の3つは、顧客のグループ分けによく使う特徴量です。
import pandas as pd

# 架空の購入の記録(1行が1回の購入)
orders = pd.DataFrame({
    "customer": ["A", "A", "B", "C", "C", "C"],
    "date": pd.to_datetime(["2026-09-03", "2026-10-28", "2026-06-15",
                            "2026-10-02", "2026-10-20", "2026-10-30"]),
    "amount": [3200, 4800, 12000, 1500, 2200, 1800],
})

# 顧客ごとに、最後の購入からの日数、購入回数、合計金額の3つの特徴量を作る
today = pd.Timestamp("2026-11-01")
features = orders.groupby("customer").agg(
    recency=("date", lambda d: (today - d.max()).days),
    frequency=("date", "count"),
    monetary=("amount", "sum"),
)
print(features)
          recency  frequency  monetary
customer
A               4          2      8000
B             139          1     12000
C               2          3      5500
6行の記録が、顧客1人につき1行の、3つの特徴量の表になりました。
Bは合計金額が最も大きい一方で、最後の購入から139日たっています。
実際のデータでこの表を作り、単位をそろえてからk-meansに渡せば、買い方の似た顧客のグループに分けられます。
NoLangで機械学習の手法を説明する動画を作る
社内の勉強会や研修、授業で手法を説明するときは、NoLangで解説の動画を作れます。
入力欄に指示を書いて作る
NoLangのホームの「今日はどんな動画を作る?」の入力欄に、説明したい手法と、誰に向けた動画かを書きます。
動画の向きと長さを入力欄の下のボタンで選び、右端の矢印のボタン(動画を生成)を押すと、動画の生成が始まります。
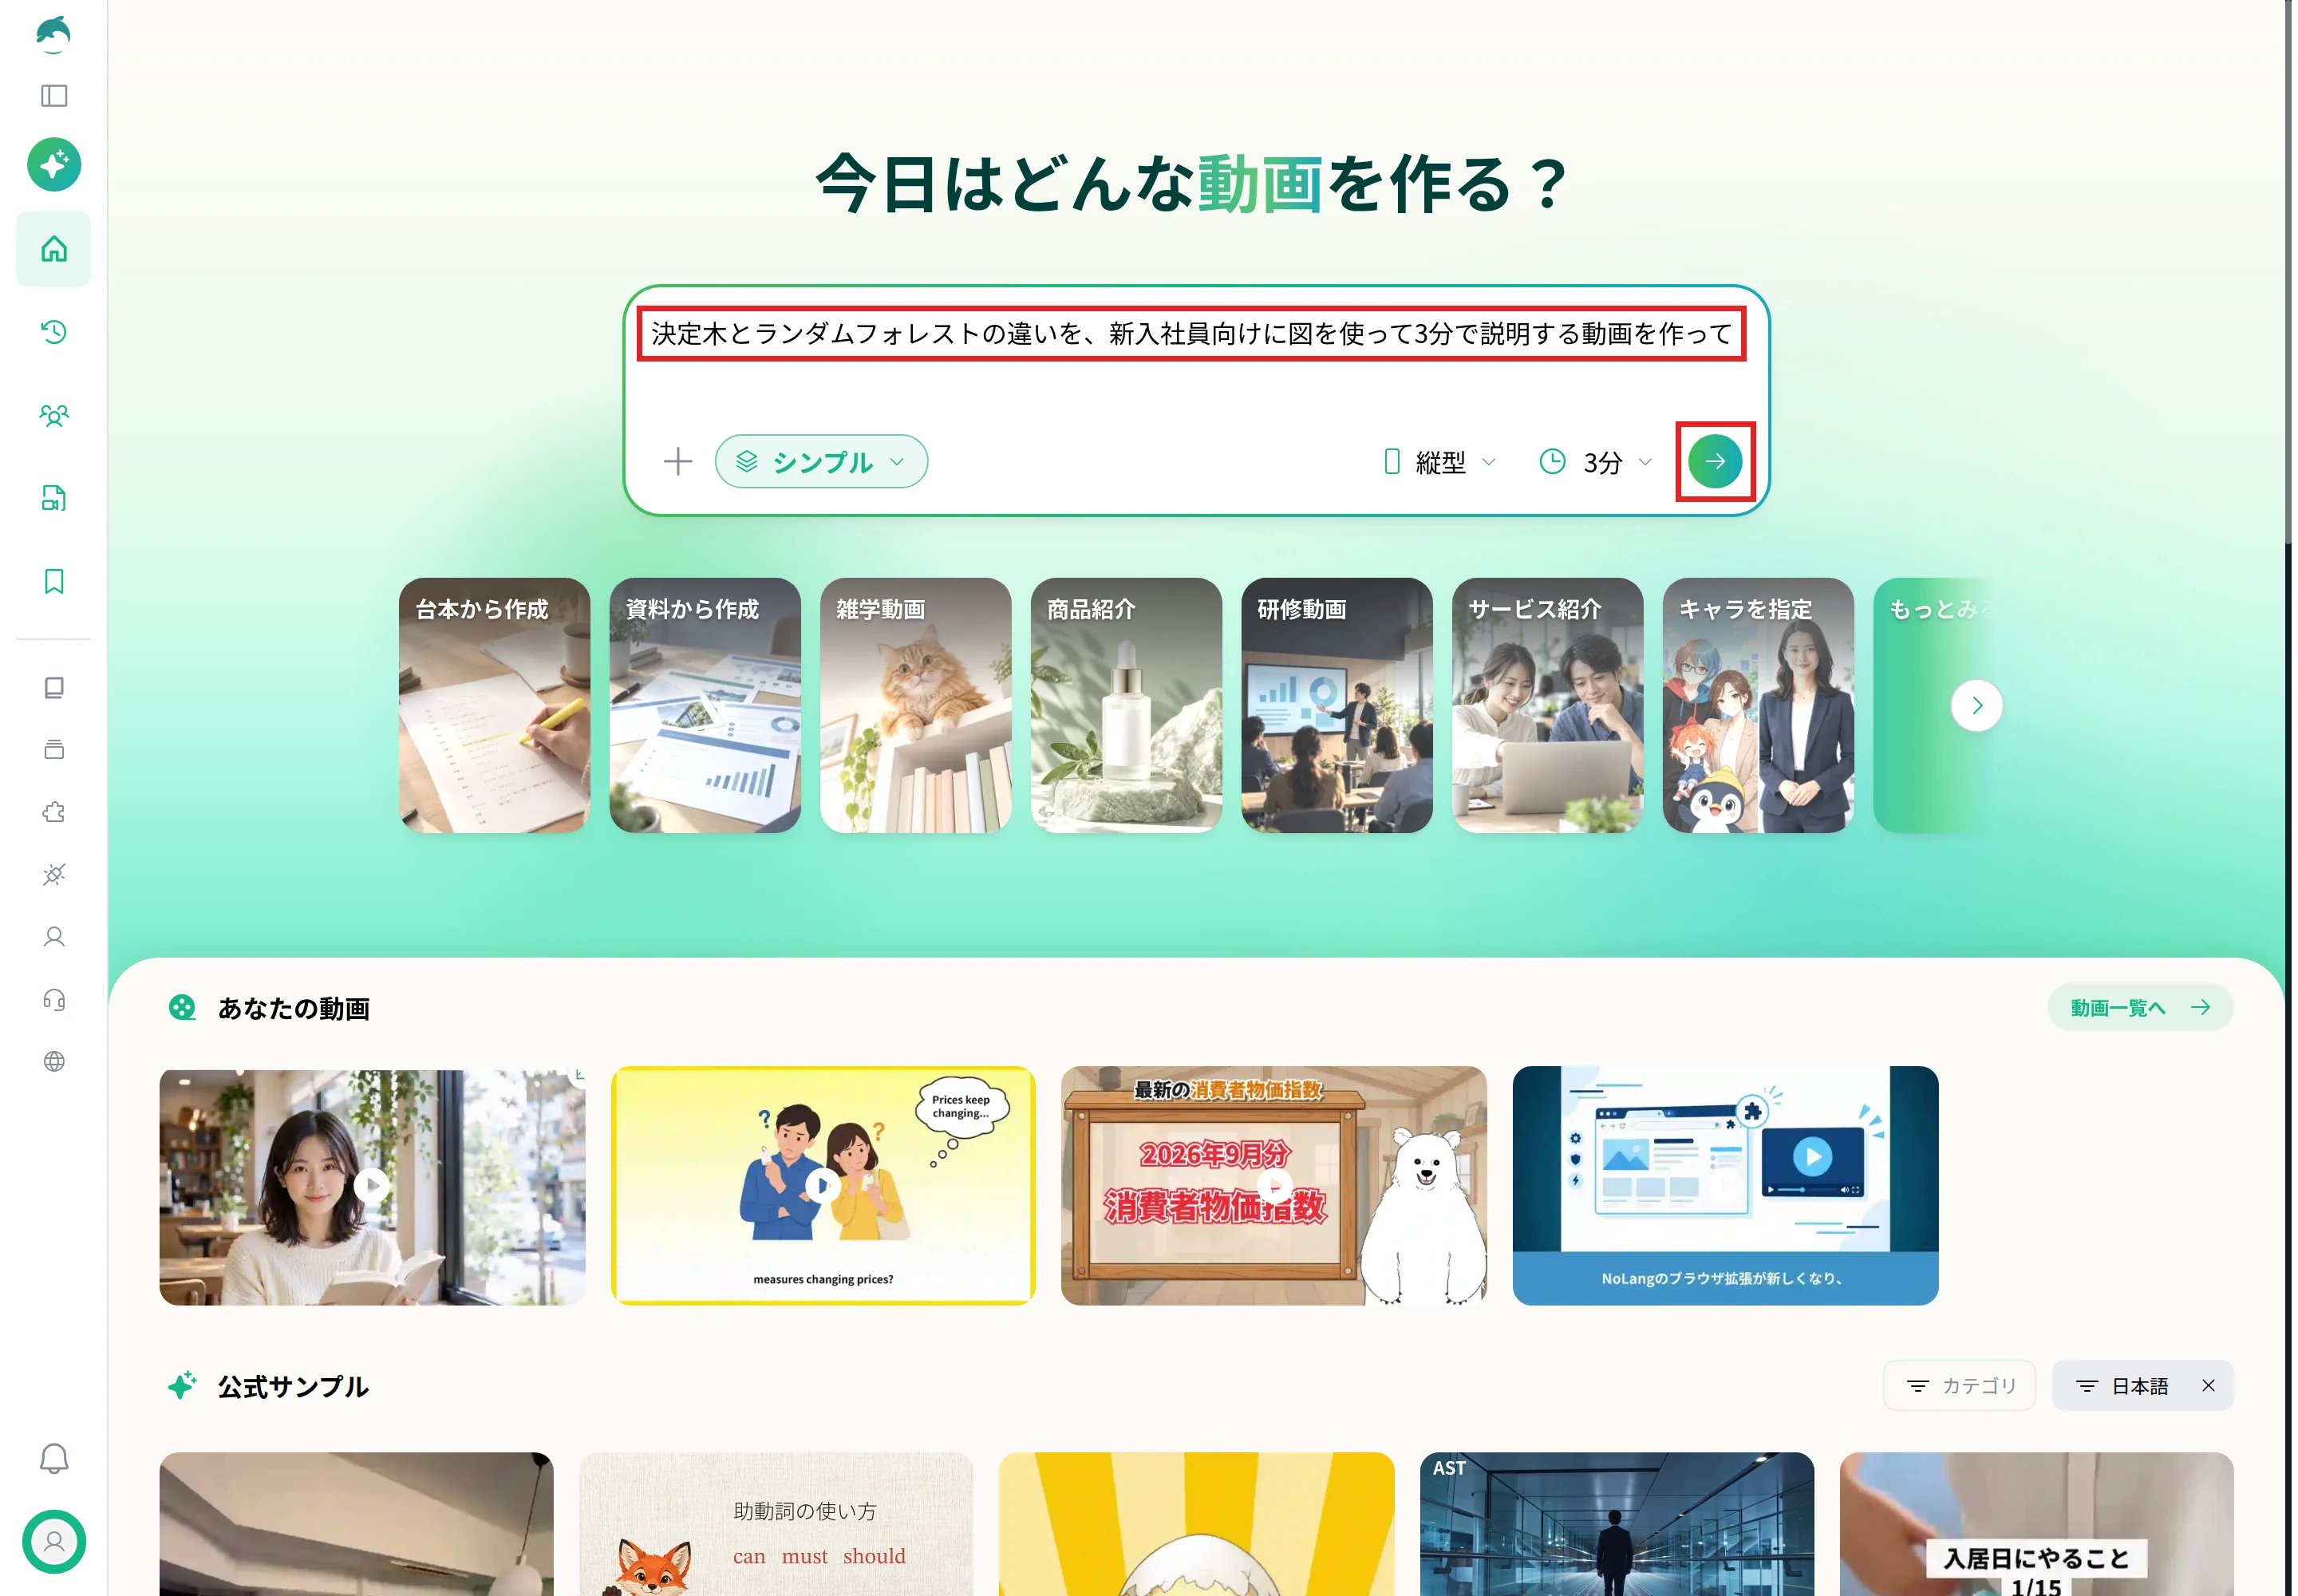
入力例:
決定木とランダムフォレストの違いを、新入社員向けに図を使って3分で説明する動画を作って
勉強会の資料から作る
手法を説明したスライド(PDF、PowerPoint)が手元にあれば、その資料から動画を作れます。
「資料から作成」のボタンはホームの「作り方を選んで始める」の中にあり、押すと「3ステップで資料から動画を作成」の画面が開きます。
「資料をアップロード」でファイルを選び、「テンプレートを選択」で動画の見た目を選び、「指示を入力して動画生成」で、資料をどんな動画にしたいかを書いて生成します。
「指示を入力して動画生成」のステップでは、作り方を次の4つから選べます。
資料から動画を作るときの作り方
| 作り方 | 動画の中身 |
|---|
| 全ページ解説 | 資料のページを飛ばさずに、すべて解説する |
|---|
| 要点のみ解説 | 重要なページを選んで解説する |
|---|
| スピーカーノート | PowerPointのノートを、そのまま読み上げる |
|---|
| 台本を指定 | ページごとに指定した台本を読み上げる |
|---|
会社でデータ活用の研修動画を使うには
社内のデータ活用やAIの研修の資料(PDF、PowerPoint)から解説の動画を作れば、社員が同じ内容を好きなときに見て学べます。
法人向けの使い方は、研修動画のページで紹介しています。
自社の教材から動画を作れるかどうかはお問い合わせから相談でき、サービスの詳しい資料は下のボタンから請求できます。
資料をダウンロード