マルチモーダル(multimodal)は、文字、画像、音声、動画のように種類の違う情報を、まとめて扱うことを指す言葉です。
AIの分野では、写真を見せて質問に答えさせたり、録音と資料を合わせて要約させたりできるAIを、マルチモーダルAIと呼びます。
この記事では、マルチモーダルの意味と、シングルモーダルとの違い、関係する言葉を説明します。
マルチモーダルAIが種類の違う情報をまとめて扱う仕組みを3つの段階に分け、マルチモーダルLLMと基盤モデルとの関係も整理します。
2026年11月19日時点の主なモデルが何を入力でき、何を出力できるかも、各社の公式の情報をもとに表で比べます。
医療などの事例、身近なAIアプリでの使い方、課題もあわせて紹介します。
マルチモーダルとは
マルチモーダルは、「複数の」を表すmultiと、「様式」「形式」を表すmodalを合わせた言葉です。
情報の種類のことをモダリティと呼び、文字、画像、音声などが、それぞれ1つのモダリティに当たります。
マルチモーダルAIは、2つ以上のモダリティを受け取ったり、作ったりできるAIです。
東京大学と理化学研究所は、大規模なマルチモーダルモデルを「テキストだけでなく画像・音声・動画など複数のデータ形式(モーダル)を統合的に理解・生成できるAIモデル」と説明しています(東京大学 先端科学技術研究センターの発表、2026年3月)。
AIが扱う主なモダリティ
| モダリティ | 例 |
|---|
| 文字(テキスト) | 質問の文、メール、報告書、プログラムのコード |
|---|
| 画像 | 写真、図表、スクリーンショット、手書きのメモ、X線の画像 |
|---|
| 音声 | 話し声、会議の録音、機械の動作音 |
|---|
| 動画 | 防犯カメラの映像、会議の録画、製品の紹介の動画 |
|---|
| 文書 | 文字と図表が入ったPDFやスライド |
|---|
| センサーの数値 | 温度、振動、位置、レーダーやLiDARで測った距離 |
|---|
人も、目で見て、耳で聞いて、文字を読んで、まわりの状況を判断しています。
マルチモーダルAIは、このように複数の種類の情報を合わせて、AIに判断させるものです。
シングルモーダルAIとの違い
1種類の情報だけを扱うAIを、シングルモーダルAI(ユニモーダルAI)と呼びます。
文字だけを読む翻訳のAIや、画像だけを見る画像認識のAIがその例です。
シングルモーダルAIとマルチモーダルAIの違い
| 比べること | シングルモーダルAI | マルチモーダルAI |
|---|
| 扱う情報 | 1種類 | 2種類以上 |
|---|
| 入力の例 | 文字だけ、画像だけ | 写真と質問の文、映像と音 |
|---|
| 得意なこと | 1つの種類の情報の処理 | 情報を合わせた判断、種類をまたぐ変換 |
|---|
種類の違う情報を合わせると、1種類だけでは分からないことが分かるようになります。
産業技術総合研究所(産総研)は、次の2つの例を挙げています(産総研マガジン「マルチモーダルAIとは?」)。
- 防犯カメラ:音のない映像だけでは、細かい表情が見えないと、向かい合う2人が楽しく話しているのか言い争っているのかを判断できません。音の情報を加えると、話し声の内容や調子から、危険な場面かどうかをより正確に見分けられます。
- 自動運転:カメラは物が何かを見分けるのが得意ですが、暗い場所や逆光には弱いという面があります。レーダーは物が何かを見分ける力は劣りますが、そこに物があるかどうかは周りの環境に左右されずに捉えられます。2つの情報を組み合わせると、物を見つけて見分ける精度が上がります。
「マルチモーダル」の言い換えと、ほかの分野での使われ方
日本語では、「多様な形式」「複数の種類の情報を扱う」と言い換えられます。
総務省の情報通信白書は、生成AIを「テキスト、画像、映像等の多様な形式(マルチモーダル)のアウトプットが取得できるもの」と説明しています(令和6年版 情報通信白書)。
AIに限らず、ほかの分野でも、マルチモーダルは「複数の様式をまとめる」という意味で使われます。
- 交通と物流:鉄道、バス、船など、複数の交通手段や輸送手段を組み合わせることを指します。国土交通省の資料には、「マルチモーダルな予約・決済、経路検索」(地域交通におけるデジタル技術活用に関する調査研究レポート)や、鉄道や船舶を組み合わせた「マルチモーダル物流」という言い方が出てきます。
- 人とコンピュータのやりとり:キーボードやマウスだけでなく、声、映像、手ざわりなど複数の手段を使って、より自然にやりとりする仕組みを、マルチモーダルインタフェースと呼びます(人工知能学会誌の用語解説)。
マルチモーダルAIに関係する言葉
マルチモーダルAIの説明によく出てくる言葉を、一言ずつまとめます。
詳しい意味は、後の節で説明します。
マルチモーダルAIに関係する言葉
| 言葉 | 意味 |
|---|
| マルチモーダルLLM | 文字に加えて画像や音声なども入力できる大規模言語モデル |
|---|
| 視覚言語モデル(VLM) | 画像と文字を組み合わせて扱うマルチモーダルモデル |
|---|
| マルチモーダル基盤モデル | 複数の種類のデータで学習し、いろいろな用途の土台になるモデル |
|---|
| マルチモーダル学習 | 複数の種類のデータを同時に使ってAIを学習させること |
|---|
| マルチモーダル理解 | 画像や音声の中身を読み取り、文字の情報と合わせて理解すること |
|---|
| マルチモーダル化 | 文字だけを扱うモデルやサービスを、画像や音声も扱えるようにすること |
|---|
| マルチモーダル対応 | アプリやモデルが、画像、音声、ファイルなどを受け付けること |
|---|
| マルチモーダル解析 | 複数の種類のデータを合わせて分析すること。マルチモーダル分析、マルチモーダル処理とも呼ぶ |
|---|
マルチモーダルAIの仕組み
マルチモーダルAIの中では、大きく分けて次の3つのことが起きています。
- 種類ごとに、情報を数値の並び(ベクトル)にする
- 違う種類の情報を、同じ空間で対応づける
- 情報を合わせて(融合して)、答えを作る
1. 種類ごとに、情報を数値の並び(ベクトル)にする
AIは、文字も画像も音声も、そのままでは計算に使えません。
そこで、種類ごとに用意したエンコーダー(情報を数値に変える部分)で、情報の特徴を表す数値の並び(ベクトル)にします。
文字は、言葉の単位(トークン)に分けてから、ベクトルにします。
画像は、16×16ピクセルなどの小さな区画(パッチ)に分け、区画を言葉のように並べてからベクトルにする方法があります。
Googleの研究者が2020年に発表したVision Transformer(ViT)の論文で、文章に使われていたTransformerを、画像の区画の並びにそのまま当てはめても、画像を高い精度で分類できることが示されました(論文「An Image is Worth 16x16 Words」)。
2. 違う種類の情報を、同じ空間で対応づける
文字のベクトルと画像のベクトルは、そのままでは別々の尺度で作られています。
「犬」という言葉と犬の写真が近くに並ぶように、2つを同じ空間に対応づける学習をします。
代表的な例が、OpenAIが2021年に発表したCLIPです。
CLIPは、インターネットから集めた4億組の画像と説明文を使い、どの説明文がどの画像に合うかを当てる学習をしました(CLIPの論文)。
画像のエンコーダーと文字のエンコーダーを一緒に学習させ、正しい組のベクトルが近くなるようにしています。
こうして対応づけると、「海辺を走る犬」という文で、それに合う写真を探せるようになります。
3. 情報を合わせて(融合して)、答えを作る
最後に、ベクトルにした情報を合わせて、答えや判断を作ります。
IBMは、情報を合わせる時点によって、融合の方式を次の3つに分けて説明しています(IBM「マルチモーダルAIとは」)。
融合の3つの方式
| 方式 | 合わせる時点 |
|---|
| 早期融合 | 最初にそれぞれをベクトルにして、共通の表現にまとめてから処理する |
|---|
| 中間融合 | 処理の途中の段階で、それぞれの情報を結合する |
|---|
| 後期融合 | 種類ごとに別のモデルで処理し、最後にそれぞれの出力を組み合わせる |
|---|
画像や音声をベクトルにしたものを、文字と一緒に大規模言語モデル(LLM)に渡して、まとめて読み取らせる作りもあります。
この作りは、次の「マルチモーダルLLM」の節で説明します。
マルチモーダル学習
複数の種類のデータを同時に使ってAIを学習させることを、マルチモーダル学習と呼びます。
産総研は、異なる種類の情報の間で同時に現れる特徴(共起関係)から学ぶ方法を紹介しています。
楽器を演奏している人と演奏していない人を撮影した映像と、同時に録音した音を一緒に学習させると、AIは「楽器を持っている人から音が聞こえる」という関係を自分でつかめるようになります。
写っている物や聞こえる音が何かを人が1つずつ教える(ラベルを付ける)必要が減るので、ラベル付けの手間とコストを減らせると考えられています。
産総研はこの方法で、カメラとマイクを積んで展示の間を動き回るロボットに、人が教えなくても、人の声や展示物の音がどこから出ているかを推定させています。
ロボットや機械を動かすAIについては、フィジカルAIの意味と仕組みで説明しています。
マルチモーダルLLMと基盤モデル
マルチモーダルLLM
マルチモーダルLLMは、文字を扱う大規模言語モデル(LLM)に、画像や音声なども入力できるようにしたモデルです。
英語のMultimodal Large Language Modelから、MLLMとも呼ばれます。
LLMの仕組みそのものは、LLM(大規模言語モデル)とはで詳しく説明しています。
国立情報学研究所が主宰するLLM-jpが2026年9月に公開した視覚言語モデル「LLM-jp-4-VL 9B」は、国産のLLMをマルチモーダル化したモデルです(LLM-jpの発表)。
公式のモデルの説明では、次の3つの部品でできていると書かれています(モデルカード)。
- 視覚エンコーダー:画像をベクトルにする部分。LLM-jp-4-VLでは、Googleが公開したSigLIP 2を使っています。
- プロジェクター:画像のベクトルを、LLMが扱える形に変える軽量な部分。
- LLM:変換した画像の情報と、質問の文をまとめて読み、答えの文章を作る部分。
画像と文字を組み合わせて扱うマルチモーダルモデルは、視覚言語モデル(VLM)とも呼ばれます。
画像に説明文を付ける、画像についての質問に答える(視覚質問応答)といった用途に使われます。
入力だけか、出力もマルチモーダルか
「マルチモーダルに対応」と書かれていても、入力と出力のどちらが複数の種類なのかは、モデルによって違います。
- 入力がマルチモーダル:画像、音声、PDFなどを読み取り、答えは文章で返します。いまの主なLLMの多くはこの形で、画像や音声の中身を読み取ることをマルチモーダル理解とも言います。
- 出力もマルチモーダル:文章のほかに、声や画像で答えます。声で会話するためのモデルや、文章と画像から画像を作るモデルがこの形です。
文章を作るLLMとは別に、画像や音声を作るモデルを用意し、サービスの中で組み合わせることもあります。
生成AI全体の種類は、生成AIとはでまとめています。
マルチモーダル基盤モデル
基盤モデルは、大量のデータで学習し、調整するといろいろな用途に使える、土台になるモデルです。
文字に加えて画像や音声などでも学習した基盤モデルを、マルチモーダル基盤モデルと呼びます。
日本でも、マルチモーダル基盤モデルの開発が進んでいます。
2026年6月には、新エネルギー・産業技術総合開発機構(NEDO)の「AIロボット・フィジカルAIを見据えたマルチモーダル基盤モデル開発事業」に、Noetraと産総研の提案が採択されました(産総研のお知らせ)。
東京大学と理化学研究所は2026年3月に、日本語の医療に特化した、142億パラメータの視覚言語モデルを発表しています(後の「医療の事例」で紹介します)。
主なマルチモーダルのモデル
2026年11月19日時点で、各社の公式のモデルの一覧と説明に載っている主なモデルの、入力と出力の種類をまとめます。
モデルは数か月ごとに新しい版が出るので、使う前に各社の一覧で確かめてください。
海外の主なモデル
海外の主なマルチモーダルのモデル(2026年11月19日時点)
| 開発元 | モデル | 入力 | 出力 |
|---|
| OpenAI | GPT-6.2 Astra | 文字、画像 | 文字 |
|---|
| OpenAI | GPT-Realtime-2.1 | 文字、音声、画像 | 文字、音声 |
|---|
| OpenAI | GPT-Image-2.6 Sunburst | 文字、画像 | 画像 |
|---|
| Google | Gemini 4(Carbon、Neon、Hydrogen、Argon) | 文字、画像、動画、音声、PDF | 文字 |
|---|
| Google | Gemini 3.8 Live | 文字、画像、音声 | 文字、音声 |
|---|
| Anthropic | Claude(Fable 5.2、Opus 5.5、Sonnet 5.5、Haiku 5.5) | 文字、画像、PDF | 文字 |
|---|
OpenAIとAnthropicは、モデルの一覧で、主力のモデル(OpenAIのGPT-6.2 Astraなど、AnthropicのClaude)はどれも文字と画像を入力にでき、文字を出力すると説明しています(OpenAIのモデルの一覧、Anthropicのモデルの一覧)。
Claudeは、PDFの文章と図表も読み取れます(ClaudeのPDFの読み取りの説明)。
GoogleのGemini 4は、表の中で入力の種類が最も多く、動画と音声もそのまま読み取れます(Geminiのモデルの一覧)。
声で会話するためのモデル(GPT-Realtime-2.1、Gemini 3.8 Live)は、声で答えを返せます。
画像を作るのは、GPT-Image-2.6のような画像の生成に特化したモデルです。
国産のマルチモーダルのモデル
国産の主なマルチモーダルのモデル(2026年11月19日時点)
| 開発元 | モデル | 入力 | 公式に説明されている特徴 |
|---|
| 国立情報学研究所(LLM-jp) | LLM-jp-4-VL 9B | 画像、文字 | 2026年9月公開。日本語と英語。重みを公開 |
|---|
| ソフトバンク(SB Intuitions) | Sarashina2-Vision | 画像、文字 | 視覚言語モデル。重みを公開 |
|---|
| 東京大学、理化学研究所 | 日本語医療の視覚言語モデル | 画像、文字 | 142億パラメータ。CT画像とX線画像で評価 |
|---|
マルチモーダルAIでできることと事例
マルチモーダルAIでできることを、入力と出力の組み合わせで整理します。
マルチモーダルAIでできること
| できること | 入力 | 出力 |
|---|
| 写真について質問に答える | 画像、文字 | 文字 |
|---|
| 書類や図表を読み取る | PDF、画像 | 文字 |
|---|
| 会議の録音を要約する | 音声 | 文字 |
|---|
| 動画の内容をまとめる | 動画 | 文字 |
|---|
| 声で会話する | 音声 | 音声 |
|---|
| 説明から画像を作る | 文字、画像 | 画像 |
|---|
| 文章や資料から動画を作る | 文字、資料、画像 | 動画 |
|---|
書類の読み取りは、AI-OCRとは、会議の録音の要約は、AI議事録の作り方で詳しく説明しています。
画像を作るAIの選び方は、画像生成AIのおすすめ8選で比べています。
医療の事例
医療は、画像、検査の数値、カルテの文章など、種類の違うデータが多く集まる分野で、マルチモーダルAIの研究が進んでいます。
- 画像と診療情報で肝臓の腫瘍を見分ける:東京大学医学部附属病院とグルーヴノーツは2022年1月に、腹部の超音波検査の画像と診療情報を合わせて学習し、肝臓の腫瘍(肝腫瘤)の種類を見分けるモデルを発表しました。画像だけで学習したモデルより、診療情報を合わせたモデルのほうが、見分ける精度が大きく上がったと報告しています(東京大学医学部附属病院の発表)。
- 電子カルテと検査データを合わせて分析する:NEC、理化学研究所、日本医科大学は2023年6月に、複数の大学病院と共同で、前立腺がんを対象に電子カルテなどの医療データを多角的に分析するマルチモーダルAIを作ったと発表しました(理化学研究所 革新知能統合研究センターの発表)。
- 医療の画像と日本語の文章を扱うモデル:東京大学と理化学研究所は2026年3月に、142億パラメータの日本語の医療用の視覚言語モデルを発表しました。英語の医療データを加工、翻訳して約1,200万件の日本語の学習データを作り、CT画像とX線画像で評価しています。診断の支援や所見の作成などの土台としての活用が期待されています(理化学研究所の発表)。
身近なAIアプリのマルチモーダル機能
ChatGPT、Geminiアプリ、Claudeは、どれも文字のほかに画像やファイルを受け取れる、マルチモーダルに対応したアプリです。
たとえばChatGPTでは、写真を送って質問する、PDFを読み込ませて要約させる、声で会話する、説明から画像を作る、といったことができます。
これが、ChatGPTのマルチモーダル機能と呼ばれるものです。
各社の公式のヘルプで確かめた、文字のほかに入力できるものと作れるものをまとめます(2026年11月19日時点)。
AIアプリのマルチモーダル機能(2026年11月19日時点)
| アプリ | 文字のほかに入力できるもの | 文字のほかに作れるもの |
|---|
| ChatGPT | 画像、PDFなどのファイル、音声ファイル、動画ファイル、声 | 画像、声での返事 |
|---|
| Geminiアプリ | 画像、文書、動画、音声ファイル、声とカメラの映像 | 画像、動画、声での返事 |
|---|
| Claude | 画像、PDFなどの文書、声 | 図やグラフ、声での返事 |
|---|
アプリごとに、次の違いがあります。
- ChatGPT:PDF、Word、Excel、PowerPointなどのファイルを読み込ませて、要約や分析を頼めます(ChatGPTのファイルのアップロードのヘルプ)。声での会話(ChatGPT Voice)は、PCのブラウザでもスマホのアプリでも使えます。
- Geminiアプリ:動画は合計5分まで、音声は合計10分までのファイルを読み込めます(Geminiアプリのヘルプ)。カメラに映したものについて声で話せるGemini Liveは、スマホのアプリで使う機能です。
- Claude:画像はJPEG、PNG、GIF、WebPを添付できます。写真やイラストは作らず、図やグラフを会話の中で作ると公式に説明しています(Claudeのヘルプ)。
使い方は、ChatGPTとは、Geminiとは、Claudeとはで、それぞれ画面で説明しています。
マルチモーダルAIの課題と注意点
マルチモーダルAIを仕事で使うときは、次の点に気をつけます。
- 多くのデータと計算が要る:種類の違うデータを扱うぶんデータの量が増え、学習や処理に時間がかかり、大規模な計算の設備が必要になります(産総研)。自社でモデルを作るときは、種類の違うデータを組にして集める手間も見込んでおきます。
- 画像の読み取りを誤ることがある:Anthropicは、画質の低い画像、回転した画像、とても小さい画像では、誤った答えを返すことがあると説明しています。写っている物の数や位置も、おおよその答えになります(Claudeの画像の読み取りの説明)。数字や表を読み取らせたときは、元の資料と照らし合わせます。
- 判断の根拠が分かりにくい:いくつもの種類の情報から判断するので、AIが何を根拠に答えたのかが利用者に分かりにくくなります(産総研)。大事な判断は、AIの答えを人が確かめてから使います。
- 写っている情報に気をつける:写真、スクリーンショット、動画には人の顔や名前、社外に出せない情報が写り込み、録音には話した内容がそのまま残ります。AIに渡す前に中身を確かめ、社内のルールで渡してよい情報を決めておきます。人や作品が写った画像を使うときは、肖像権や著作権にも気をつけます。
NoLangで、文章や資料から動画を作る
動画を作るAIサービスのNoLangも、文章のほかに資料、画像、音声、動画を入力に使えます。
作りたい動画の内容を文章で書くと、AIが構成と台本を考え、ナレーション、字幕、画像を付けた動画にします。
NoLangのホームで、入力欄の左の[+]を押し、「ファイルをアップロード」の横の印にマウスを合わせると、添付できる形式が表示されます。
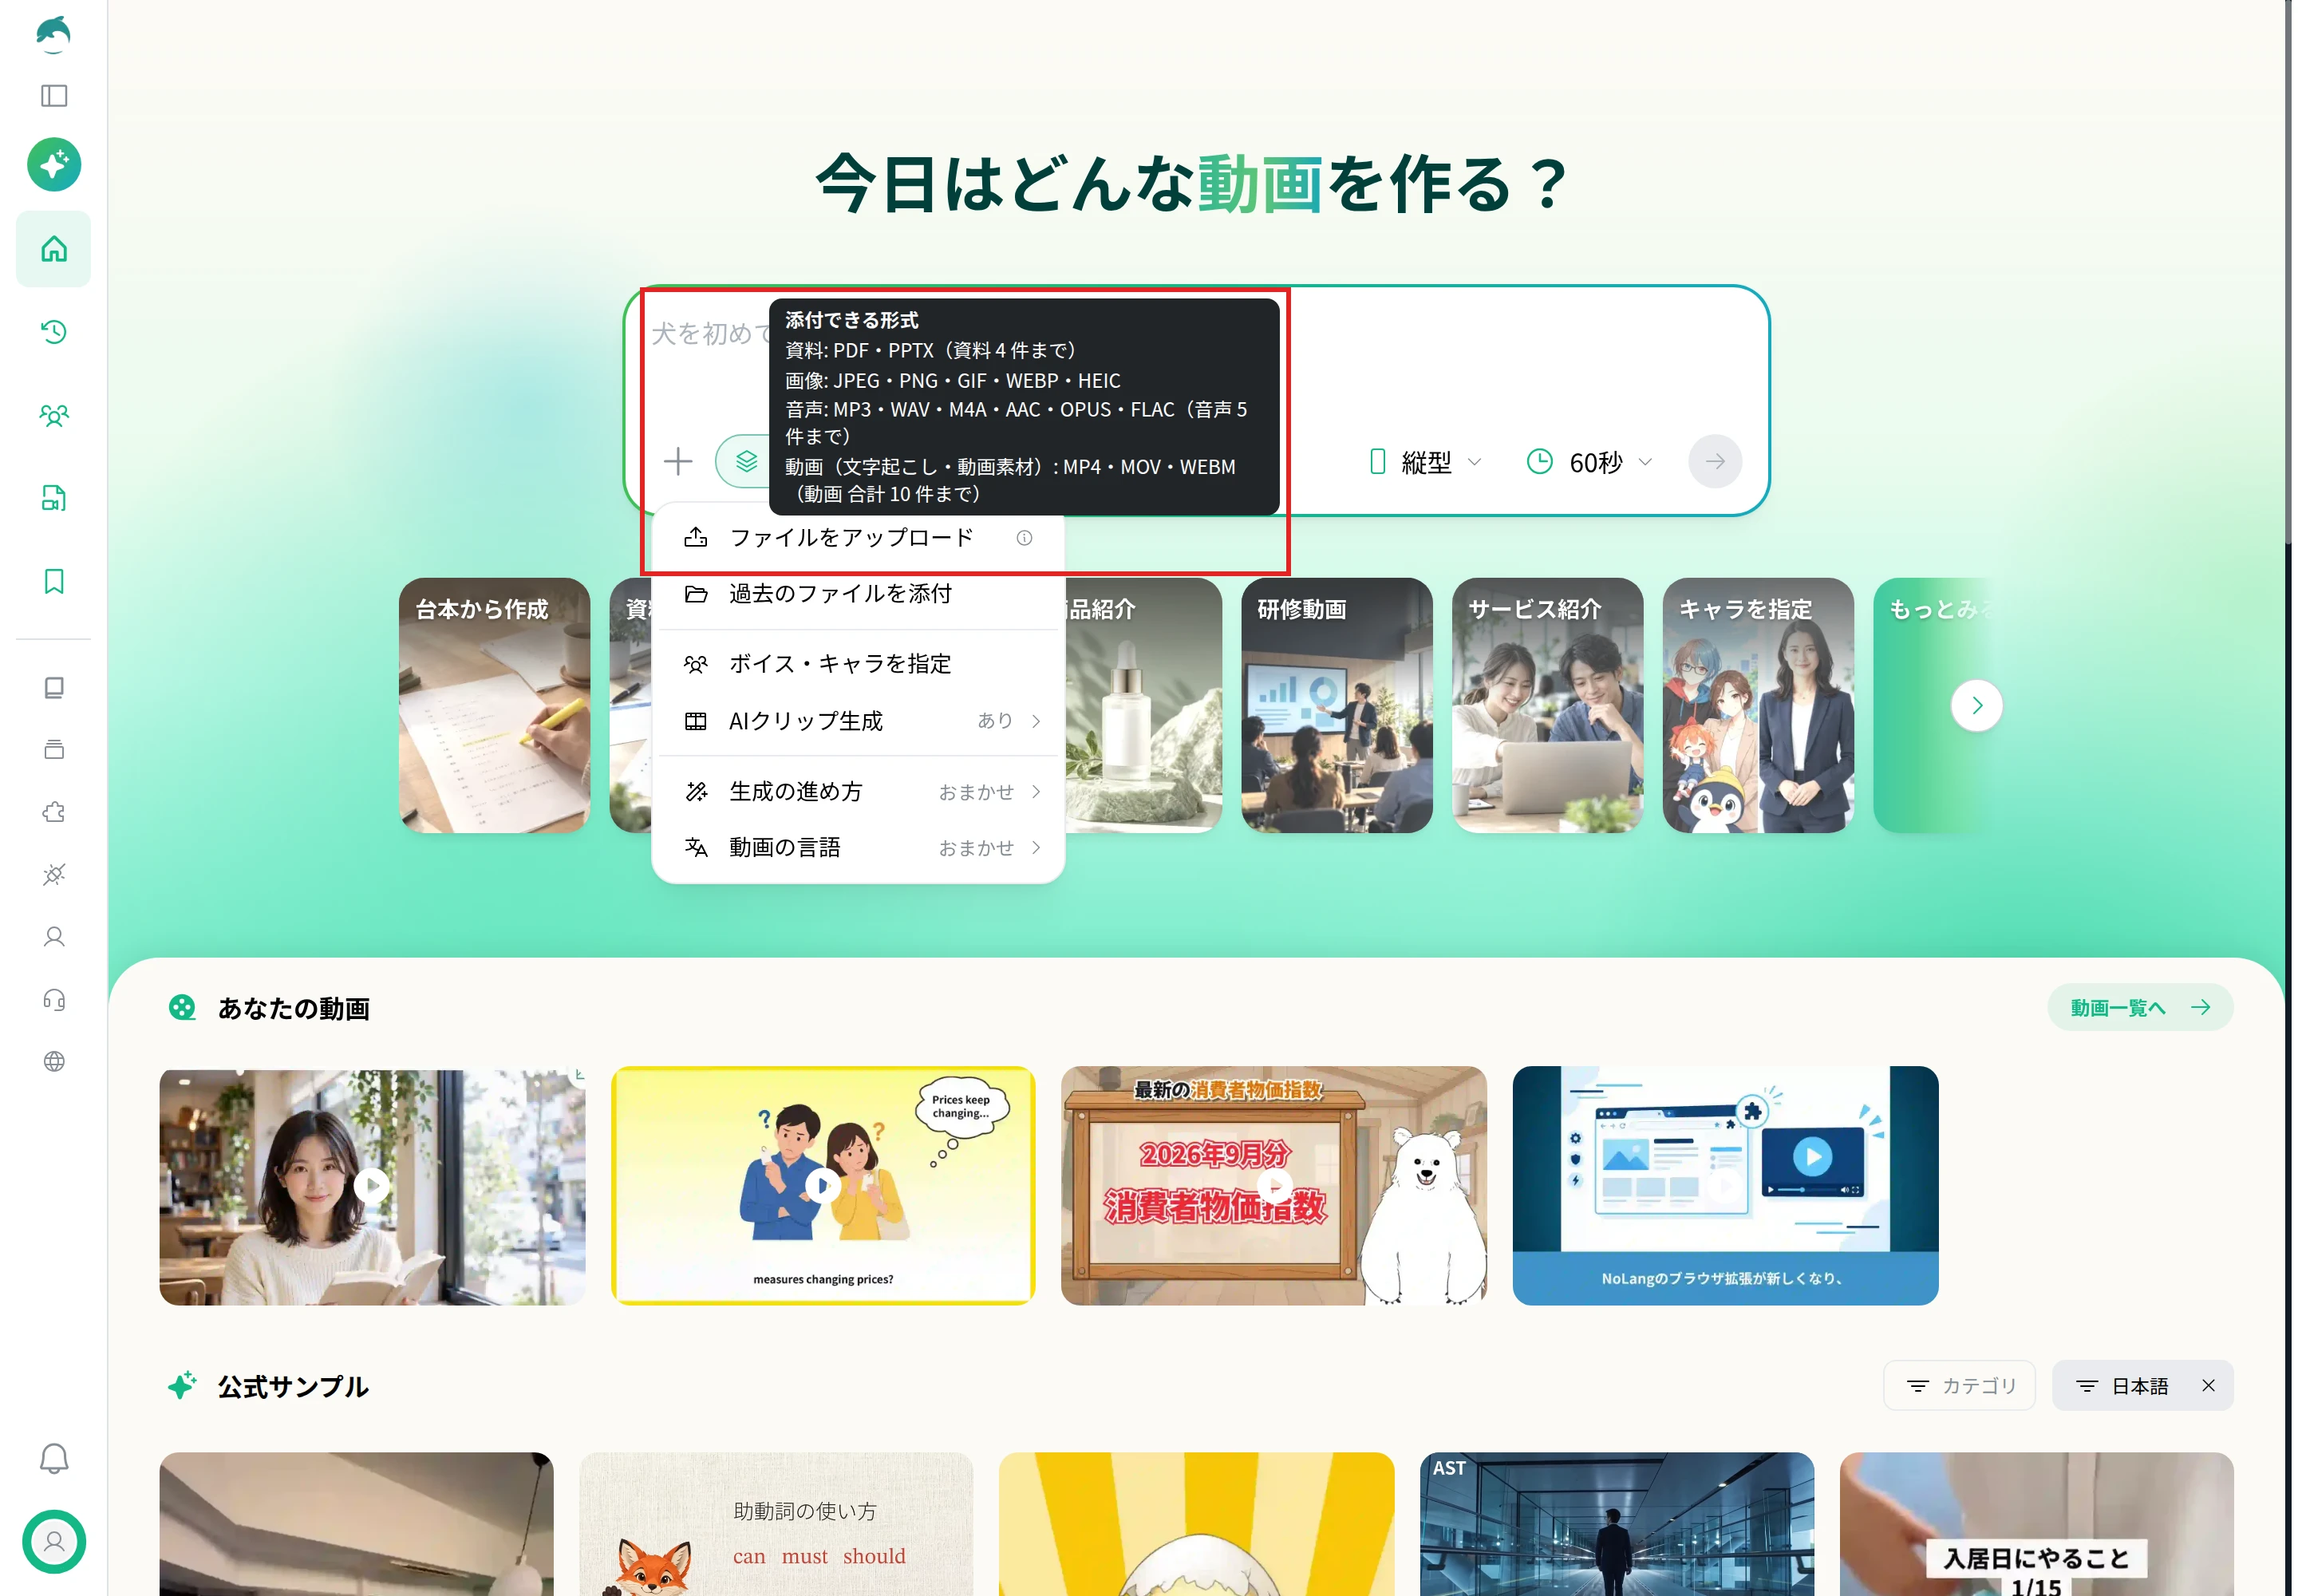
資料はPDFとPowerPoint(PPTX)、画像はJPEGやPNGなどを添付できます。
音声は、話している内容を文字に起こして動画の材料にします。
動画は、同じように文字起こしの材料にするか、映像の素材として使うかを選べます。
ホームの「公式サンプル」では、NoLangで作った動画の例を再生できます。
次の画面は、キャラクター、図、字幕を組み合わせて新NISAを説明する公式サンプルを開き、同じ形で別のテーマの動画を頼む文を入力欄に入れたところです。
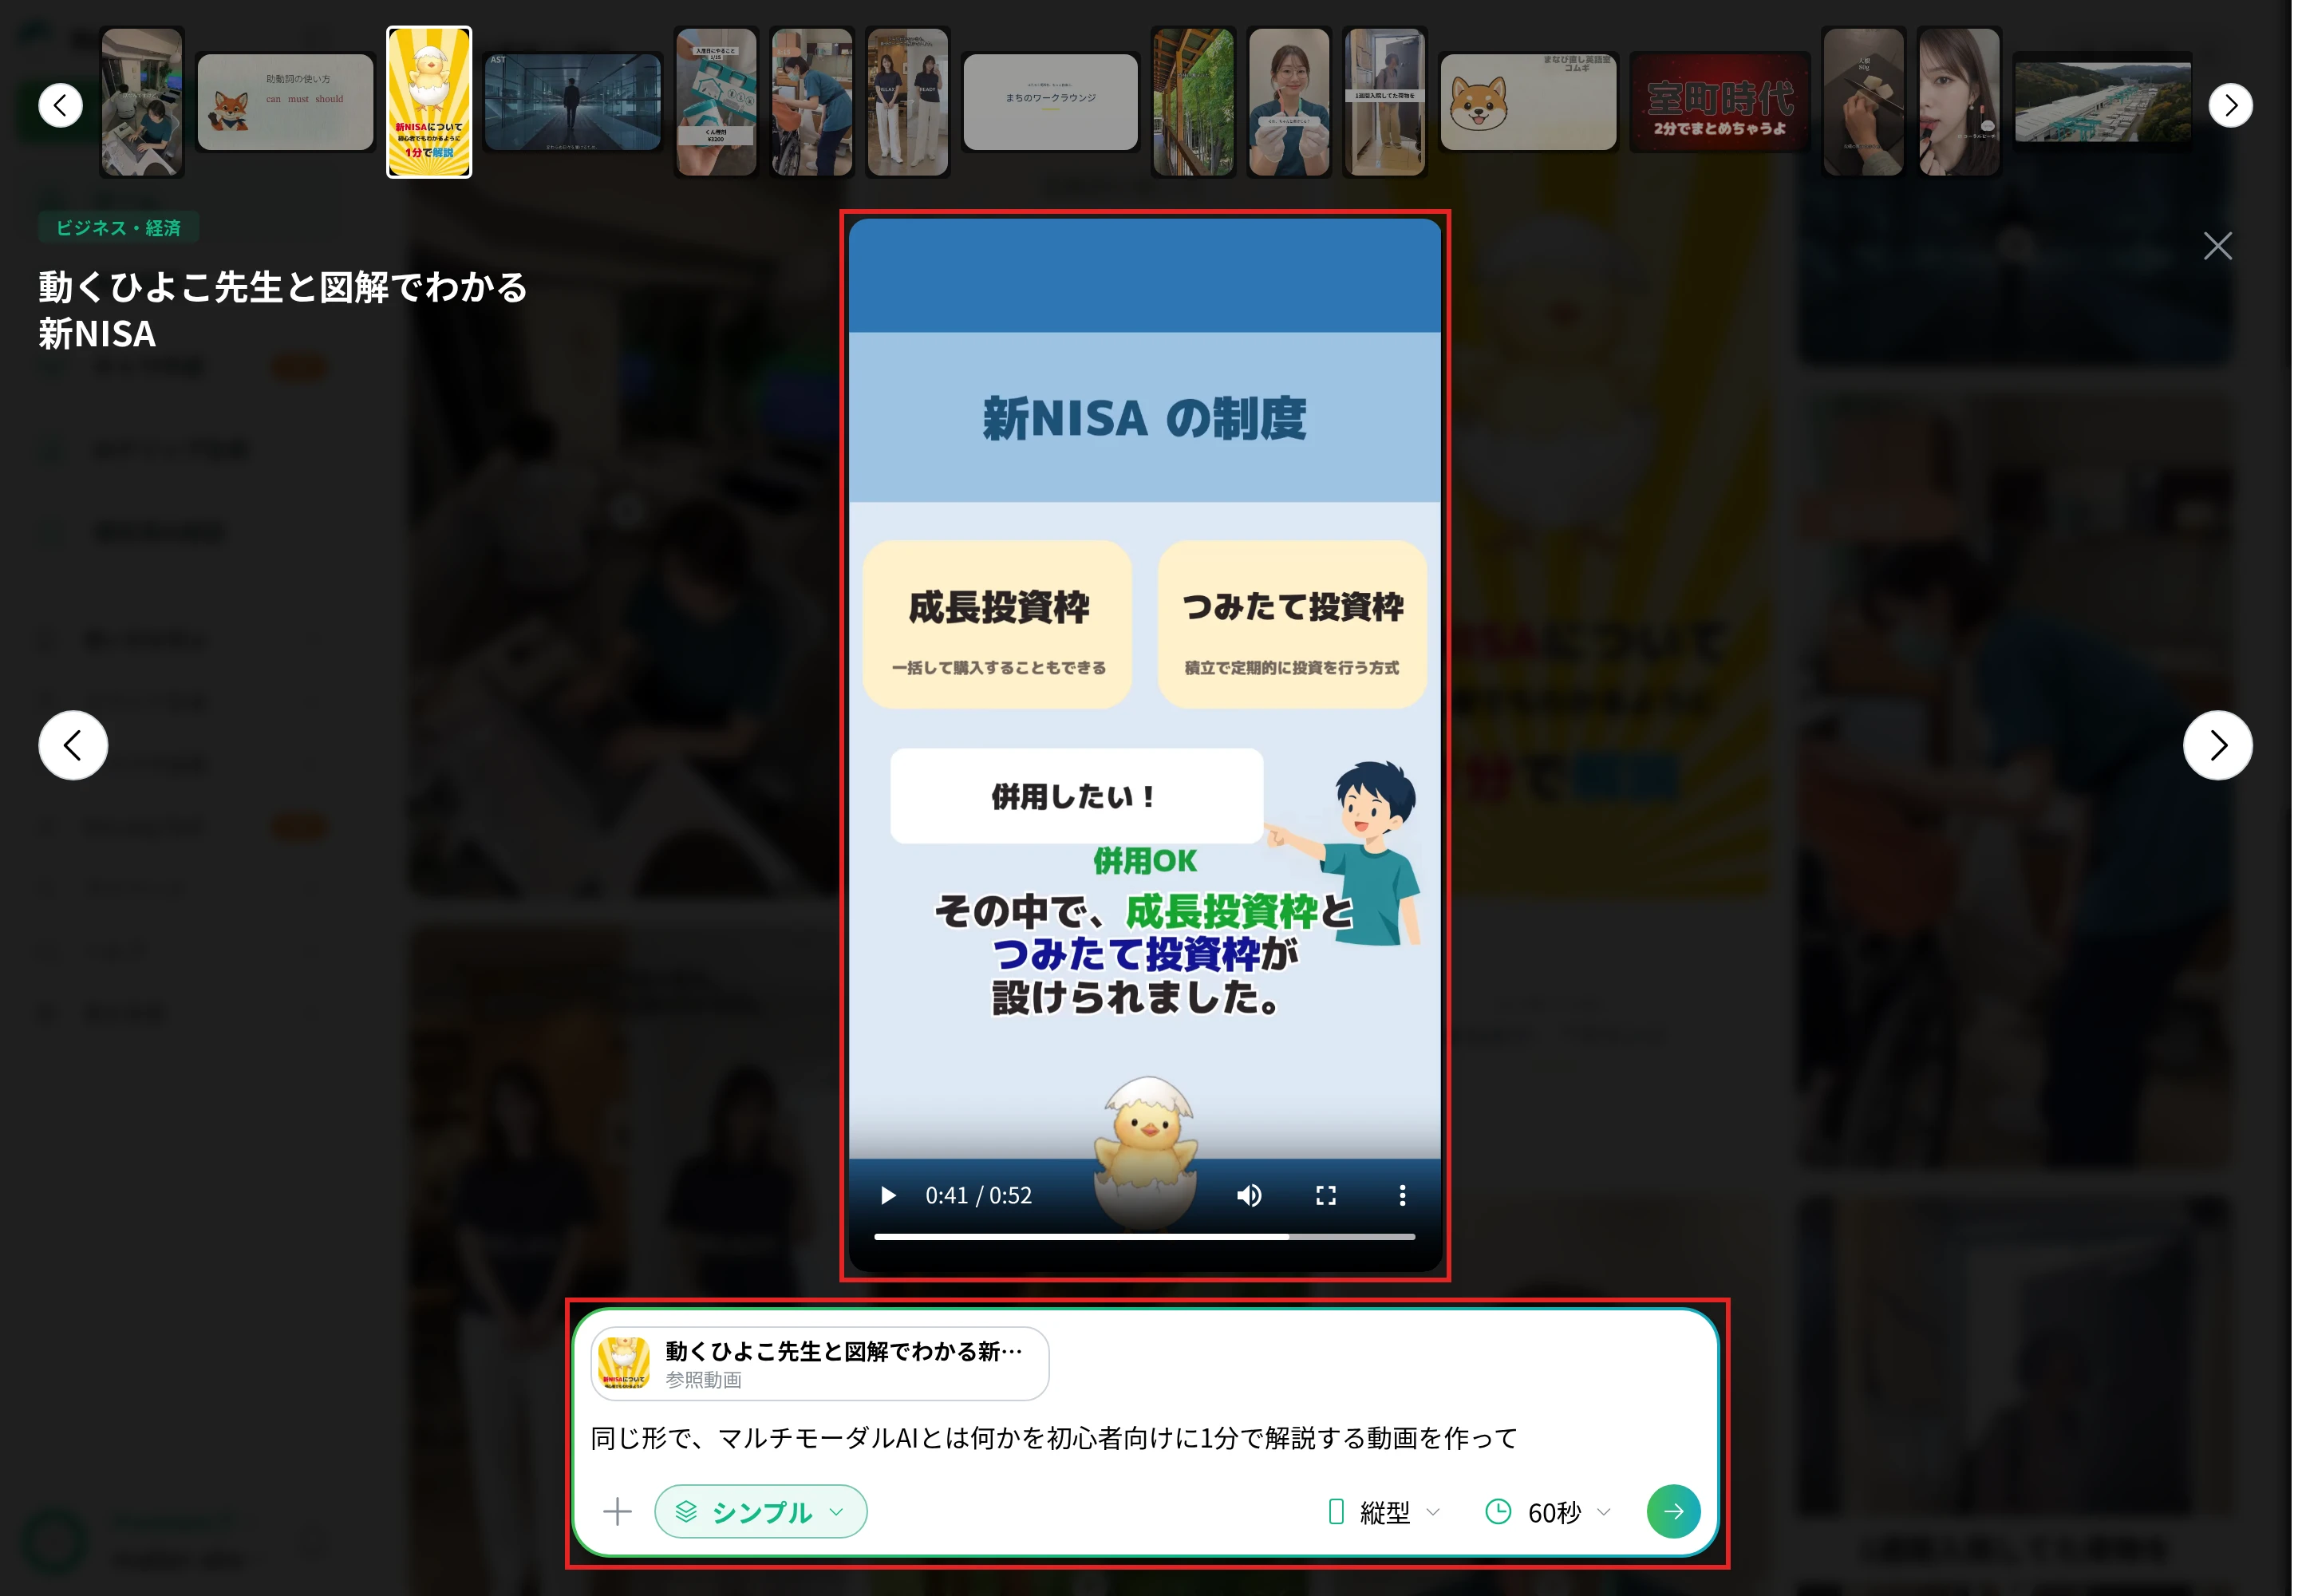
サンプルを開くと入力欄に「参照動画」として付くので、テーマを変える文を書いて送れば、同じ形の動画を作れます。
会社でマルチモーダルAIを使うとき
会社でマルチモーダルAIを使い始めるときは、どの情報をAIに渡してよいか、AIの答えをどう確かめるかを、社内のルールとして決めておきます。
NoLangでは、PDFやPowerPointの資料、会議や説明会の録音から、ナレーションと字幕の付いた説明の動画を作れます。
社員への研修や、お客様への製品の説明に使う動画を、資料を作り直さずに用意できます。
会社での使い方の相談は、お問い合わせから送れます。
詳しい資料は、下のボタンからダウンロードしてください。
資料をダウンロード