AIデータセンターは、AIの学習や、学習したAIを動かす推論に必要な、大量の計算をこなすためのデータセンターです。
中にはGPUなどのAI半導体を載せたサーバーがラック単位で並びます。
ふつうのデータセンターよりはるかに多くの電力を使い、チップを液体で直接冷やします。
この記事では、AIデータセンターと従来のデータセンターの違い、AI半導体の4つの種類と主な製品、日本の企業とAIデータセンターの場所、電力の見通しを説明します。
自分でAIを学習させたい人に向けて、ディープラーニング用のGPUサーバーの借り方と料金の例も紹介します。
数値と製品の情報は、2026年11月19日に各社と公的機関の公式の資料で確かめました。
AIデータセンターとは
AIデータセンターとは、AIの計算に向けて設計したデータセンターです。
データセンターは、サーバーやネットワークの機器を置き、電力と冷却を用意して24時間動かす施設で、Webサービスや会社のシステムを支えています。
AIデータセンターは、その中でも、AIのモデルを学習させる計算と、ChatGPTのようなサービスで答えを作る推論の計算を、大量にこなすことに特化しています。
従来のデータセンターとの違い
AIデータセンターは、計算に使う装置、1つのラック(サーバーを縦に積む棚)が使う電力、冷やし方が、従来のデータセンターと違います。
従来のデータセンターとAIデータセンターの違い
| 項目 | 従来のデータセンター | AIデータセンター |
|---|
| 主な用途 | Webサービス、会社のシステム | AIの学習と推論 |
|---|
| 計算の装置 | CPUを載せたサーバー | GPUなどのAI半導体を載せたサーバー |
|---|
| 1ラックの電力 | 20kWほど | 約120kWの例もある |
|---|
| 冷やし方 | 空気で冷やす | 液体でチップを直接冷やし、空気と組み合わせる |
|---|
表の1ラックの電力は、NVIDIAの説明によるものです。
同社は、以前のデータセンターは1ラック20kWほどで動いていたが、いまの大規模な施設は135kWを超えるラックにも対応していると説明しています。
AIサーバー「GB200 NVL72」のラックは、1台で約120kWを使います。
国際エネルギー機関(IEA)も、AIサーバーの電力の密度は2020年から2025年に11倍になり、2027年には冷蔵庫ほどの大きさの1ラックが、ピーク時に65世帯分に当たる電力を使うこともありうると見込んでいます。
これだけの電力を使うと、チップから多くの熱が出て、空気だけでは冷やしきれません。
そこでAIデータセンターでは、冷たい液体を流した金属の板(コールドプレート)をCPUやGPUに当てて、チップから直接熱を運ぶ「直接液冷」を使います。
なぜAIデータセンターが必要なのか
AIのモデルを学習させるには、膨大な文章や画像を使い、多くのGPUで長い時間をかけて計算します。
学習したモデルを多くの人が使うようになると、答えを作る推論の計算も、利用が増えるほど多くなります。
IEAによると、2025年に世界のデータセンターの電力は17%増え、AI向けのデータセンターの電力は50%増えました。
この計算をこなすには、数千から数万のGPUを1か所に集めて高速につなぎ、そのための電力と冷却をまとめて用意する必要があります。
従来のデータセンターの電源と空調では足りないため、AI向けに設計したデータセンターが各地で作られています。
LLMの学習の仕組みは、LLMとはで説明しています。
AIデータセンターの中にあるもの
NVIDIAのAIサーバーのラック「GB200 NVL72」を例に、AIデータセンターの中にあるものを見ていきます。
- GPUサーバーのラック:GB200 NVL72は、1台のラックに計算用のトレイを18台積み、1台のトレイにGrace CPUを2基とBlackwell GPUを4基載せています。ラック1台で、GPUは72基、CPUは36基になります。
- GPUどうしをつなぐ接続:ラックの中の72基のGPUは、NVLinkという専用の接続で、毎秒130TBの速さでつながります。ラックどうしも高速なネットワークでつなぎ、多くのGPUを1つの大きな計算機のように使います。xAIは、H100というGPUを20万基つないだ計算機を作ったと公表しています。
- 電源:AIデータセンターの規模は、電力会社から受け取れる電力(受電容量)で表すことが多く、ソフトバンクが大阪府堺市に作るAIデータセンターは140MW規模の計画です。
- 冷却の設備:GB200 NVL72では、計算用のトレイを液体で冷やし、ネットワークやストレージの機器は空気で冷やします。KDDIの大阪堺データセンターも、空冷に加えて直接液冷を入れています。
AI半導体とは
AI半導体とは、AIの計算をこなすために作られた半導体の総称で、AIチップとも呼ばれます。
半導体には、CPU、メモリ、センサー、電力を制御するパワー半導体など多くの種類があり、AI半導体はそのうちAIの計算に向けたものを指します。
経済産業省の「半導体・デジタル産業戦略」(2026年6月改訂)も、AIデータセンターなどに使う先端の半導体と、センサーやマイコン、パワー半導体などを分けて示しています。
AIのモデルは、膨大な数の掛け算と足し算を繰り返して学習し、答えを出します。
モデルを大きくしたり、多くの人が使えるようにしたりするほど計算が増えるので、高性能な半導体をたくさん用意する必要があります。
AIデータセンターは、そのAI半導体を大量に動かすための施設です。
AIにGPUが使われる理由
GPUは、もとは画面に映像を描くための半導体ですが、いまはAIの計算の中心になっています。
NVIDIAは、CPUは少ないコアと大きなキャッシュで少数の処理を順番に素早くこなし、GPUは数百のコアで数千の処理を同時にこなすと説明しています。
CPUとGPUの違い
| 項目 | CPU | GPU |
|---|
| コア | 少ない(大きなキャッシュを持つ) | 数百以上 |
|---|
| 同時にこなす処理 | 少ない | 数千 |
|---|
| 得意な処理 | 順番に素早く進める処理 | 同じ計算を大量に同時に行う処理 |
|---|
ディープラーニングの計算は、同じ形の計算を大量に並べて同時にこなせるので、GPUが向いています。
NVIDIAは、GPUで計算するための開発の基盤「CUDA」を2007年に公開していて、PyTorchなどのAIの開発ツールから、CUDAを通じてNVIDIAのGPUを使えます。
ディープラーニングと機械学習の関係は、機械学習とはで説明しています。
AI半導体の4つの種類
AI半導体は、GPU、ASIC、FPGA、NPUの4つに分けると違いが分かりやすくなります。
AI半導体の4つの種類
| 種類 | 特徴 | 主な使い道 | 例 |
|---|
| GPU | 多くの計算を同時にこなす | 学習と推論 | NVIDIA Blackwell、AMD Instinct |
|---|
| ASIC | 特定の用途のための専用設計 | 自社のAIの学習と推論 | Google TPU、AWS Trainium |
|---|
| FPGA | 作った後に回路を書き換えられる | データの前処理、通信 | AMD Versal、Altera |
|---|
| NPU | 少ない電力でAIを動かす | PCやスマホのAI | Copilot+ PCのNPU |
|---|
GPUやASICのように、AIの計算を速くするための半導体を、まとめてAIアクセラレータと呼ぶこともあります。
GPUはいろいろなAIの計算に使えるのに対して、ASICは特定の計算に絞って設計します。
GoogleのTPU、AWSのTrainium、MicrosoftのMaiaは、各社が自社のクラウドやサービスでAIの学習や推論を安く速くこなすために作ったASICです。
FPGAは、製造した後に利用者が回路の構成を書き換えられる半導体です。
大きなモデルの計算はGPUに任せ、カメラやセンサーのデータの取り込みと前処理を、遅れなくFPGAでこなすといった分担の例を、FPGAを作るAlteraが挙げています。
NPUは、PCやスマホの中でAIの処理をこなす半導体です。
Microsoftは、Copilot+ PCのNPUについて、リアルタイムの翻訳や画像の生成のようなAIの処理のための専用のチップで、1秒に40兆回を超える計算ができると説明しています。
メモリ(HBM)も性能を左右する
AI半導体の性能は、計算の速さだけでなく、計算に使うデータをどれだけ速く運べるかでも決まります。
そこでデータセンター向けのGPUやASICは、HBM(広帯域メモリ)という特別なメモリを、同じパッケージの中にチップと並べて載せています。
Micronによると、HBMはメモリのチップを縦に積み重ねたもので、データの通り道の幅は、一般的なDDR5のメモリのモジュールの16倍あります。
AMDのGPU「Instinct MI350」シリーズは288GBのHBMを、Microsoftの「Maia 200」は216GBのHBMを載せています。
経済産業省の半導体・デジタル産業戦略も、HBMがデータセンター向けの中心として重要になるとしています。
主なAI半導体
データセンター向けの主なAI半導体は、次のとおりです。
データセンター向けの主なAI半導体(2026年11月19日に各社の公式の情報で確認)
| 会社 | 種類 | 製品 | 状況 |
|---|
| NVIDIA | GPU | GB300 NVL72 | 提供中 |
|---|
| NVIDIA | GPU | Vera Rubin NVL72 | 量産・出荷を開始 |
|---|
| AMD | GPU | Instinct MI350シリーズ | 提供中 |
|---|
| AMD | GPU | Helios(MI455X) | 2026年下期の見込み |
|---|
| Google | ASIC | TPU Ironwood | 提供中 |
|---|
| AWS | ASIC | Trainium3 | 2025年12月に発表 |
|---|
| Microsoft | ASIC | Maia 200 | 自社で稼働 |
|---|
| Meta | ASIC | MTIA 300 | 自社で稼働 |
|---|
NVIDIAのGB300 NVL72とVera Rubin NVL72は、GPU 72基とCPU 36基を1つのラックにまとめたシステムで、GB300はBlackwell Ultra、Vera RubinはRubinという世代のGPUを使います。
GoogleのTPUは、第7世代のIronwoodが一般に提供されていて、第8世代のTPU 8tとTPU 8iも近く提供すると発表しています。
GoogleのTPU、MicrosoftのMaia、MetaのMTIAは、各社が自社のデータセンターで使うために作ったチップで、TPUはGoogle Cloudで借りて使えます。
AI半導体の日本企業
日本の企業は、AIチップの設計、最先端の半導体の製造、エッジ(端末の側)のAI、製造装置や検査装置で、AI半導体に関わっています。
AI半導体に関わる日本の主な企業(2026年11月19日に各社の公式の情報で確認)
| 分野 | 企業 | 主な取り組み |
|---|
| AIチップの設計 | Preferred Networks | 学習向けのMN-Core 2を提供。推論向けのMN-Core L1000を2027年に販売予定 |
|---|
| CPU | 富士通 | 2nmのCPU「FUJITSU-MONAKA」。AIの推論にも向ける |
|---|
| 最先端の製造 | Rapidus | 北海道千歳市で2nmの半導体を試作。2027年に量産開始の予定 |
|---|
| エッジのAI | ソニー | AIの処理を組み込んだイメージセンサー「IMX500」 |
|---|
| エッジのAI | ルネサス エレクトロニクス | AIの処理回路「DRP-AI3」を載せたプロセッサ「RZ/V2H」 |
|---|
| 記憶装置 | キオクシア | AI向けのSSD「KIOXIA CM10」 |
|---|
| 製造装置・検査 | 東京エレクトロン、SCREEN、レーザーテック、ディスコ、アドバンテスト | 製造装置、洗浄装置、検査装置、切断装置、テストシステム |
|---|
Preferred Networksは、AIの学習と高性能計算に向けたMN-Core 2を搭載したサーバーを提供し、生成AIの推論に特化したMN-Core L1000を開発しています。
Rapidusは、北海道千歳市の拠点で2025年4月から2nmの半導体の試作ラインを動かしています。
富士通は、FUJITSU-MONAKAを、クラウドやデータセンターの事業者に向けて2026年11月に販売を始めると発表しました。
製造装置と検査の分野では、SCREENが半導体の洗浄装置、レーザーテックがEUV(極端紫外線)のマスクの検査装置、ディスコがチップを切り分ける装置、アドバンテストが半導体のテストシステムを作っています。
東京エレクトロンは、統合報告書で、2030年ごろに約1兆ドルになると見込む半導体市場の成長の原動力をAIとしています。
経済産業省は、「AI・半導体産業基盤強化フレーム」で、半導体とAIの分野に2030年度までの7年間で10兆円以上の公的な支援を行い、10年間で50兆円を超える官民の投資を促すとしています。
半導体の会社を含むAI企業の全体像は、AI企業で説明しています。
日本のAIデータセンター
日本でも、通信会社やクラウドの会社が、GPUを大量に載せたAIデータセンターを動かし始めています。
主なAIデータセンターと場所
日本の主なAIデータセンター(2026年11月19日に各社の発表で確認)
| 事業者・名前 | 場所 | 状況 | 主な設備と規模 |
|---|
| KDDI 大阪堺データセンター | 大阪府堺市 | 2026年1月に稼働 | GB200 NVL72、直接液冷 |
|---|
| さくらインターネット 石狩データセンター | 北海道石狩市 | 稼働中 | H100 2,016基、Blackwell GPU 約1,100基 |
|---|
| ソフトバンク 北海道苫小牧AIデータセンター | 北海道苫小牧市 | 2026年度の開業を目指す | 開業時50MW、最大300MW |
|---|
| ソフトバンク 大阪堺AIデータセンター | 大阪府堺市 | 2027年度の完成を目指す | 140MW規模、将来250MW超 |
|---|
KDDIの大阪堺データセンターは、シャープの堺工場の跡地にあり、工場の大規模な電力と冷却の設備を再利用しています。
KDDIは、2027年度にNVIDIAの新しい世代の「HGX Rubin NVL8」も導入すると発表しています。
さくらインターネットは、石狩データセンターに2024年8月にH100を2,016基そろえ、2026年2月には敷地内のコンテナ型のデータセンターで、Blackwell GPU約1,100基のAIの設備を動かし始めました。
ソフトバンクは、北海道苫小牧市のAIデータセンターで2026年度に第1期の工事を終えて開業することを目指し、受電容量を開業時の50MWから最大300MWまで増やす計画です。
同社の大阪堺AIデータセンターは、計算能力110エクサFLOPSを目指しています。
AIデータセンターはどこに作られるのか
総務省の情報通信白書によると、日本のデータセンターのおよそ9割は東京圏と大阪圏に集まっています。
大きな災害で東京圏や大阪圏が被災したときに通信への影響が全国に広がらないよう、国はデータセンターの地方への分散を後押ししています。
AIデータセンターは大量の電力を使うため、電力を確保しやすい場所かどうかが立地を大きく左右します。
総務省と経済産業省は、電力の設備から見て望ましい場所にデータセンターを置き、通信の設備もそれに合わせて整える「ワット・ビット連携」を進めています。
経済産業省は2026年9月、今後10年ほどでGW級のデータセンターの集積地を作る「GX戦略地域」として、次の9地域10地点を認定しました。
- 北海道(石狩市、苫小牧市)
- 秋田県(秋田市)
- 宮城県(富谷市)
- 栃木県(矢板市)
- 茨城県(常総市、つくば市)
- 富山県(南砺市)
- 香川県(綾川町、坂出市、丸亀市)
- 福岡県(北九州市、直方市、鞍手町)
- 鹿児島県(薩摩川内市)
認定は計画を後押しするためのもので、これらの地域でGW級のデータセンターがすでに動いているという意味ではありません。
AIデータセンターの消費電力と課題
AIデータセンターは大量の電力を使うため、電力の確保が大きな課題になります。
冷却の設備と水、地域との共生、計画の遅れへの対応も求められています。
電力の見通し
データセンターの電力の見通し
| 対象 | 見通し | 出典 |
|---|
| 世界の電力量 | 2025年の485TWhから、2030年に950TWh(世界の約3%) | IEA(2026年4月) |
|---|
| 世界のAI向け | 2025年から2030年に約3倍 | IEA(2026年4月) |
|---|
| 日本の電力量 | 2024年から2030年に約15TWh増える(約80%増) | IEA(2025年4月) |
|---|
| 日本の最大需要 | データセンターの新設や増設で、2030年度に328万kW、2035年度に661万kW増える | OCCTO(2026年1月) |
|---|
IEAは、世界のデータセンターが使う電力は、2025年の485TWhから2030年に950TWhへとほぼ倍になり、そのうちAI向けのデータセンターの電力は3倍になると見込んでいます。
日本の電力の需要の見通しをまとめる電力広域的運営推進機関(OCCTO)は、データセンターと半導体の工場の新設や増設で増える電力量を、2035年度に568億kWhと見込んでいます。
これは日本全体の電力量の6.71%に当たり、そのうちデータセンターが494億kWhを占めます。
冷却と水
冷却の設備や水も、データセンターの場所を決めるときの条件になります。
総務省と経済産業省がまとめた「ワット・ビット連携」の取りまとめは、データセンターの立地の要件の例に、工業用水が豊富かどうかを挙げています。
同じ取りまとめは、省エネ法に基づいて、データセンターの電力の効率を表すPUEを、2030年度に事業者の平均で1.4以下にする目標も示しています。
地域との共生
データセンターの建設には、周りに住む人から心配の声が上がることもあります。
千葉県白井市には2023年、住宅地の中に計画されたデータセンターについて、排熱や騒音を心配する市民の声が寄せられ、市は地元の協議会から周りの住民に詳しい資料が配られる予定だと答えています。
ワット・ビット連携の取りまとめも、データセンターの立地を安定して進めるには地域社会との共生が欠かせず、建設の計画と周りの環境への影響を、地域に詳しく説明することが必要だとしています。
計画の遅れ
AIデータセンターの計画は、予定どおりに進まないこともあります。
OCCTOは、2026年度の見通しで、データセンターの事業者の工事の延期や設計の変更により、電力の需要が増える時期が前回の見通しより後ろにずれたとしています。
ソフトバンクの大阪堺のデータセンターも、2024年の発表では2025年中の本格稼働の予定でしたが、いまは2027年度の完成を目指しています。
ディープラーニング用のGPUサーバーを用意する方法
自分でAIのモデルを学習させたり、ディープラーニングを試したりするときは、GPUを載せたサーバーを用意します。
買わなくても、AIデータセンターのGPUを時間や月単位で借りられます。
ディープラーニング用のGPUサーバーを用意する方法
| 方法 | 向いている場面 | 料金の単位 | 例 |
|---|
| 無料のノートブック | 小さなモデルで試す | 無料(GPUに制限) | Google Colab、Kaggle |
|---|
| GPUクラウド | 必要なときだけ使う | 秒、分、時間 | さくらの高火力、AWS、Azure |
|---|
| ベアメタル | 大きなモデルを長く学習する | 月など | さくらの高火力 PHY、KDDI GPU Cloud |
|---|
| 自社で買う | 長く使う、データを社外に出さない | 購入 | NVIDIA DGX B200 |
|---|
まずは無料のノートブックで試す
Google Colabは、ブラウザでPythonを動かせるサービスで、無料でもGPUを使えます。
ただし無料版ではGPUの利用が制限されていて、使えるGPUの種類と上限は時期によって変わり、公開されていません。
Kaggleのノートブックでも、GPUを週に30時間ほどの枠で無料で使えます。
GPUクラウドとベアメタルを借りる
GPUクラウドは、GPUを載せた仮想マシンやコンテナを、使った時間だけ借りる方法です。
ベアメタルは、物理的なサーバーを1台まるごと専有して借りる方法で、ほかの利用者と共有しないので、大きなモデルを長く学習させるときに向いています。
GPUサーバーの料金の例(2026年11月19日に各社の公式の情報で確認)
| サービス | 形 | GPU | 料金 |
|---|
| さくらの高火力 DOK | コンテナ | H100 1基 | 1時間1,008円(税込) |
|---|
| さくらの高火力 VRT | 仮想マシン | H100 1基 | 1時間990円(税込) |
|---|
| ソフトバンク GPUサーバー | 時間貸し | A100 1枚 | 1分7.2円(税抜)と月額3万円 |
|---|
| ソフトバンク GPUサーバー | 専有 | H100 8基 | 月額250万円(税抜) |
|---|
| AWS EC2 p5.48xlarge | 仮想マシン | H100 8基 | 東京で1時間68.80ドル |
|---|
| Azure ND96isr_H100_v5 | 仮想マシン | H100 8基 | 東日本で1時間142.564ドル |
|---|
さくらインターネットの「高火力」は、日本のデータセンターで動くGPUのクラウドで、秒単位の課金で使うコンテナ型のDOK、仮想マシン型のVRT、月額で専有するベアメタル型のPHYがあります。
PHYではH100、H200、B200を8基載せたサーバーを借りられ、料金は個別の見積もりです。
ソフトバンクの料金は、DGX H100を1台借りるプランと、A100を1枚から1分単位で使えるプランの一例です。
AWSとAzureの料金は、オンデマンドで借りる場合の値です。
法人向けには、GMOインターネットグループが、HGX B300とH200を国内のデータセンターから「GMO GPUクラウド」として提供しています。
KDDIは、大阪堺データセンターのGB200 NVL72を1台単位からベアメタルで使える「KDDI GPU Cloud」の申し込みを、2026年4月1日に受け付け始めると発表しました。
必要なGPUのメモリの目安
GPUを選ぶときは、搭載されたメモリの量で、扱えるモデルの大きさが決まります。
Google Cloudの説明では、70億パラメータのモデルを16ビットで読み込むだけで、約14GBのメモリを使います。
学習にはさらに多くのメモリが要り、Hugging Faceの説明では、16ビットと32ビットを組み合わせた学習でAdamという手法を使うと、1パラメータあたり重みで6バイト、勾配で4バイト、Adamで8バイトが必要になります。
70億パラメータなら、学習の途中の計算に使うメモリを除いても、約126GBになる計算です。
データセンター向けのGPUのメモリは、H100が80GB、H200が141GB、B200が180GBです。
手元のPCのGPUでAIのモデルを動かす方法は、ローカルLLMで説明しています。
NoLangで、AIデータセンターの勉強会の資料を動画にする
社内の勉強会や研修でAIデータセンターやAI半導体の基本を共有するときは、スライドと読み上げる原稿を用意すれば、NoLangの「資料から作成」でナレーション付きの解説動画にできます。
1. スライドの各ページのノートに原稿を書く
説明したい内容を1ページに1つずつスライドにし、PowerPointの「ノート」に、そのスライドで話す原稿を書きます。
数値や製品の名前は、出典の資料と照らしてから書きます。
2. 「資料から作成」でスライドをアップロードする
NoLangのホームで「資料から作成」を押すと、「3ステップで資料から動画を作成」の画面が開きます。
1つ目の段の「資料をアップロード」に、原稿をノートに書いたPPTXのファイルを入れます。
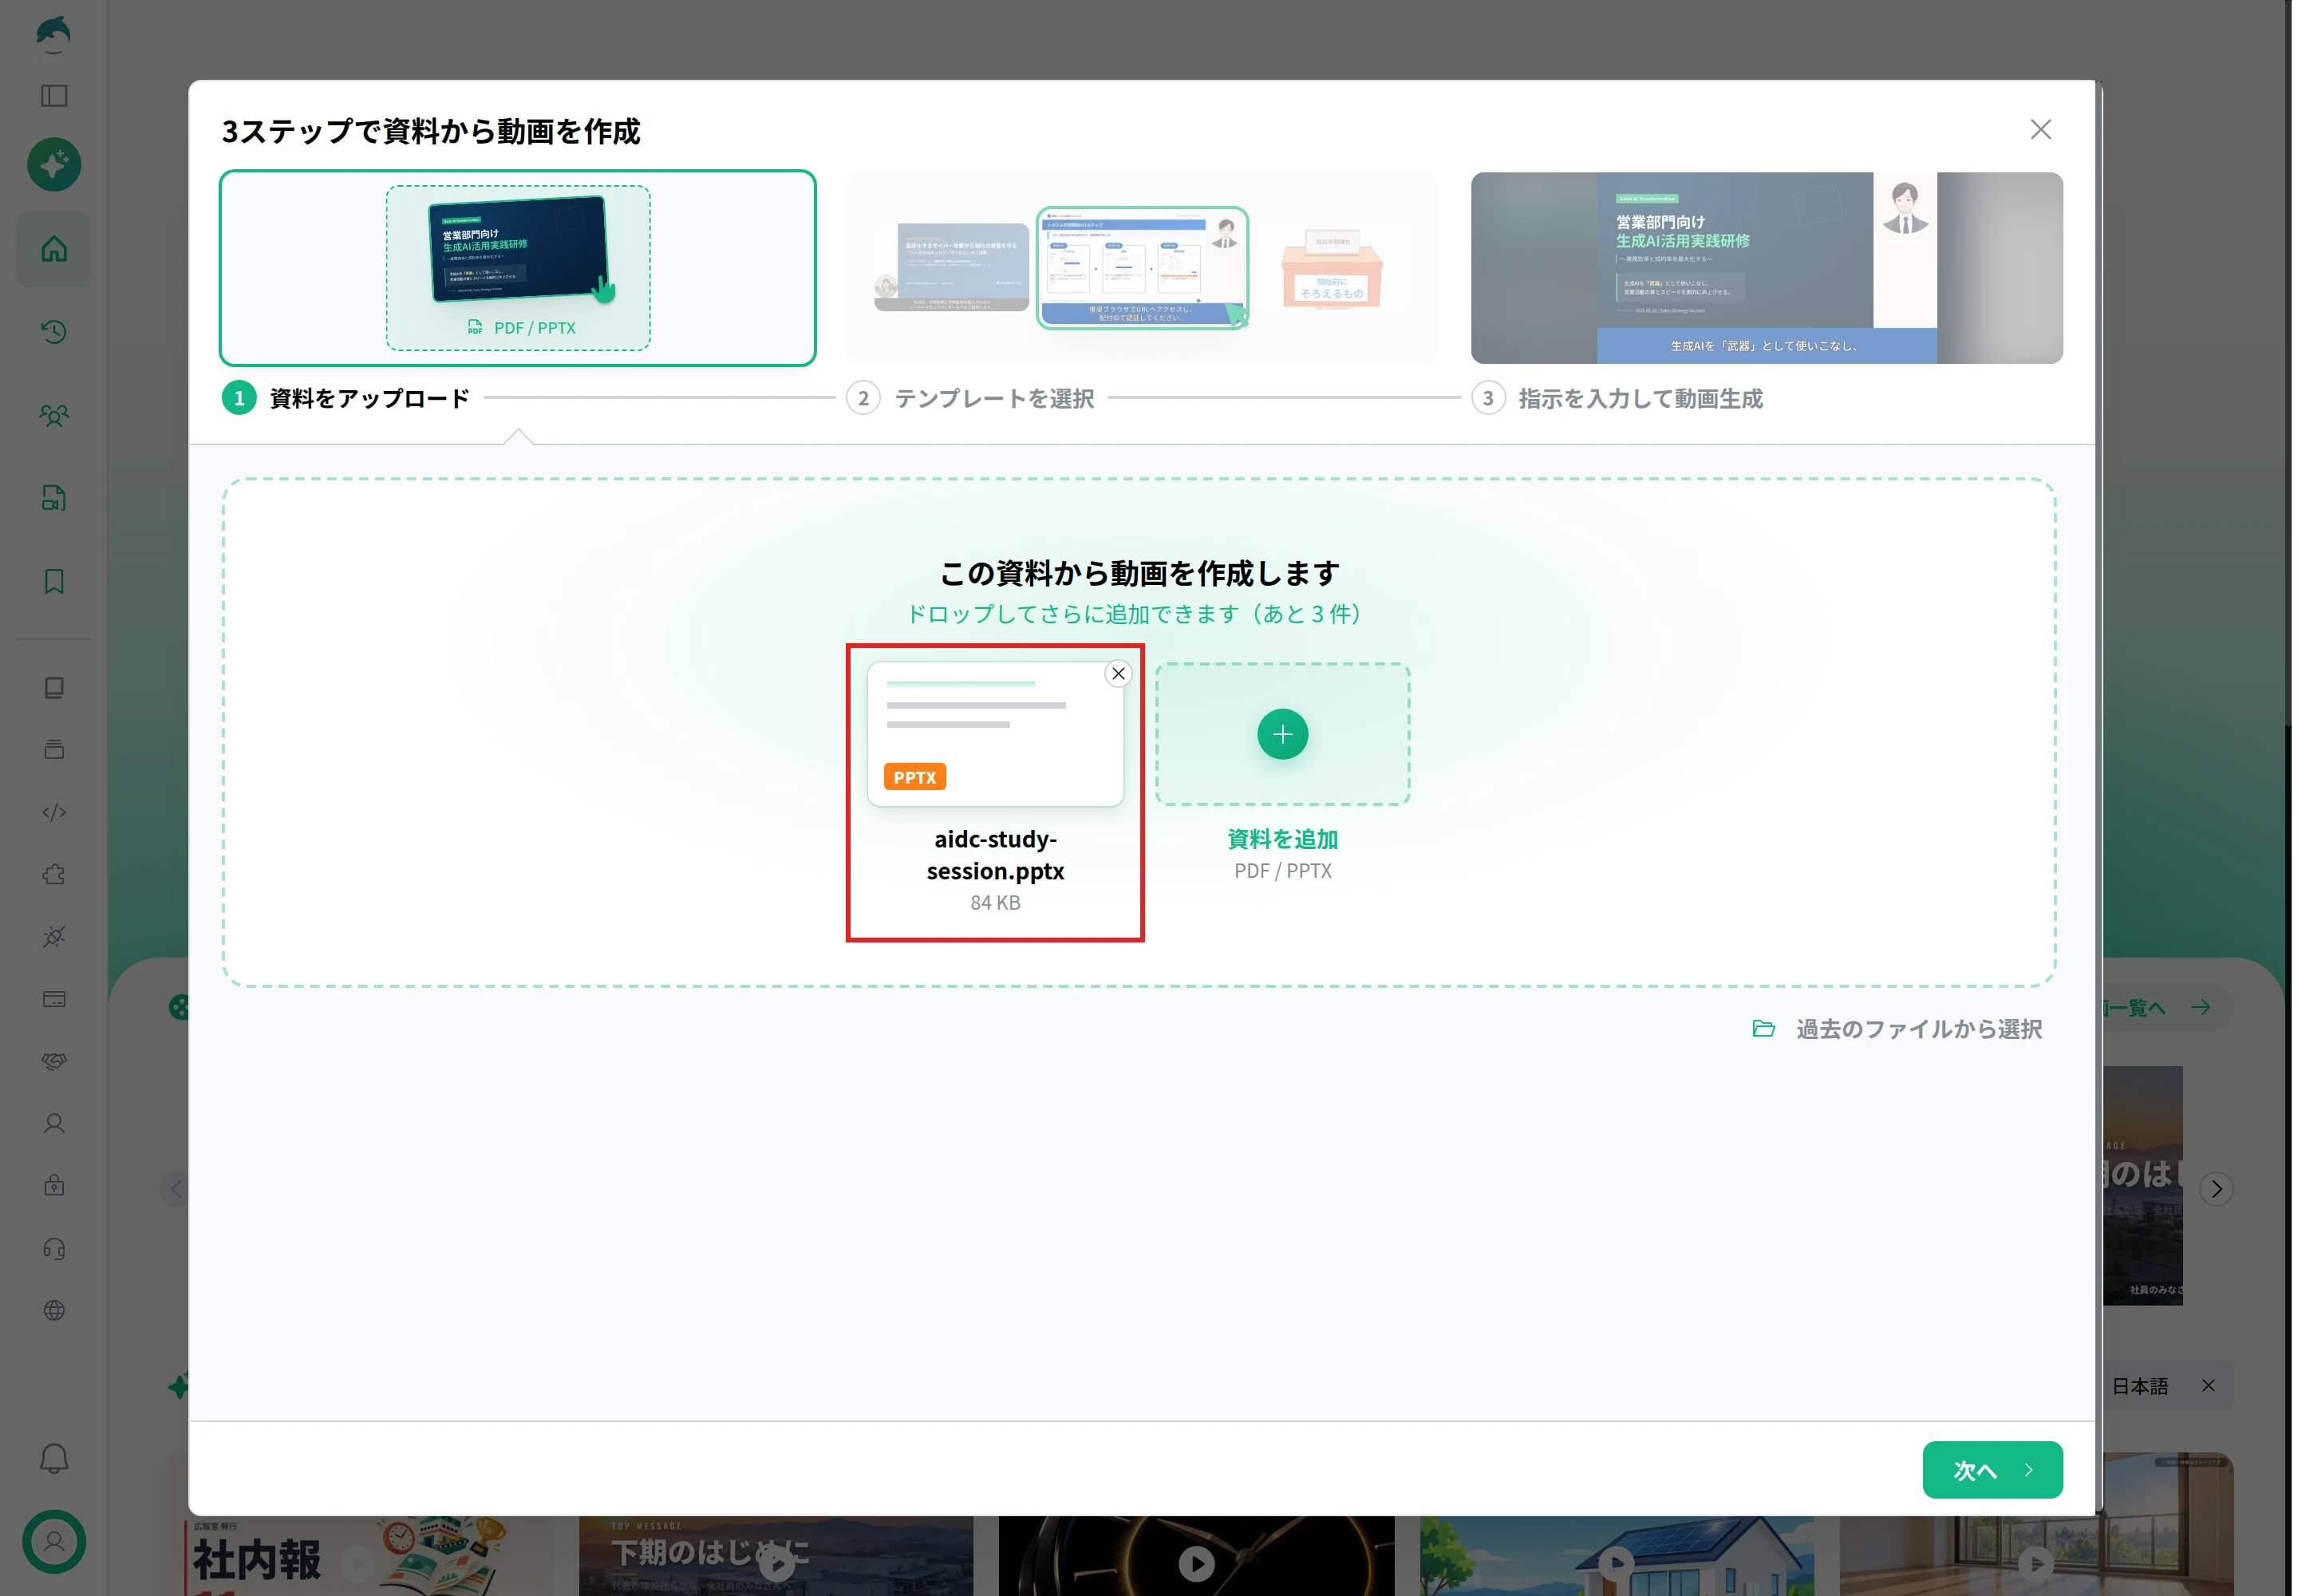
ファイルを入れると「テンプレートを選択」に進みます。
動画の見た目を決めていなければ、先頭の「おまかせ」を選ぶと、AIが内容に合わせて選びます。
3. 作り方で「スピーカーノート」を選んで作る
「指示を入力して動画生成」では、「作り方」を「全ページ解説」「要点のみ解説」「スピーカーノート」「台本を指定」の4つから選びます。
「スピーカーノート」を選ぶと、ノートの原稿をそのまま台本にして読み上げる指示が入力欄に入ります。
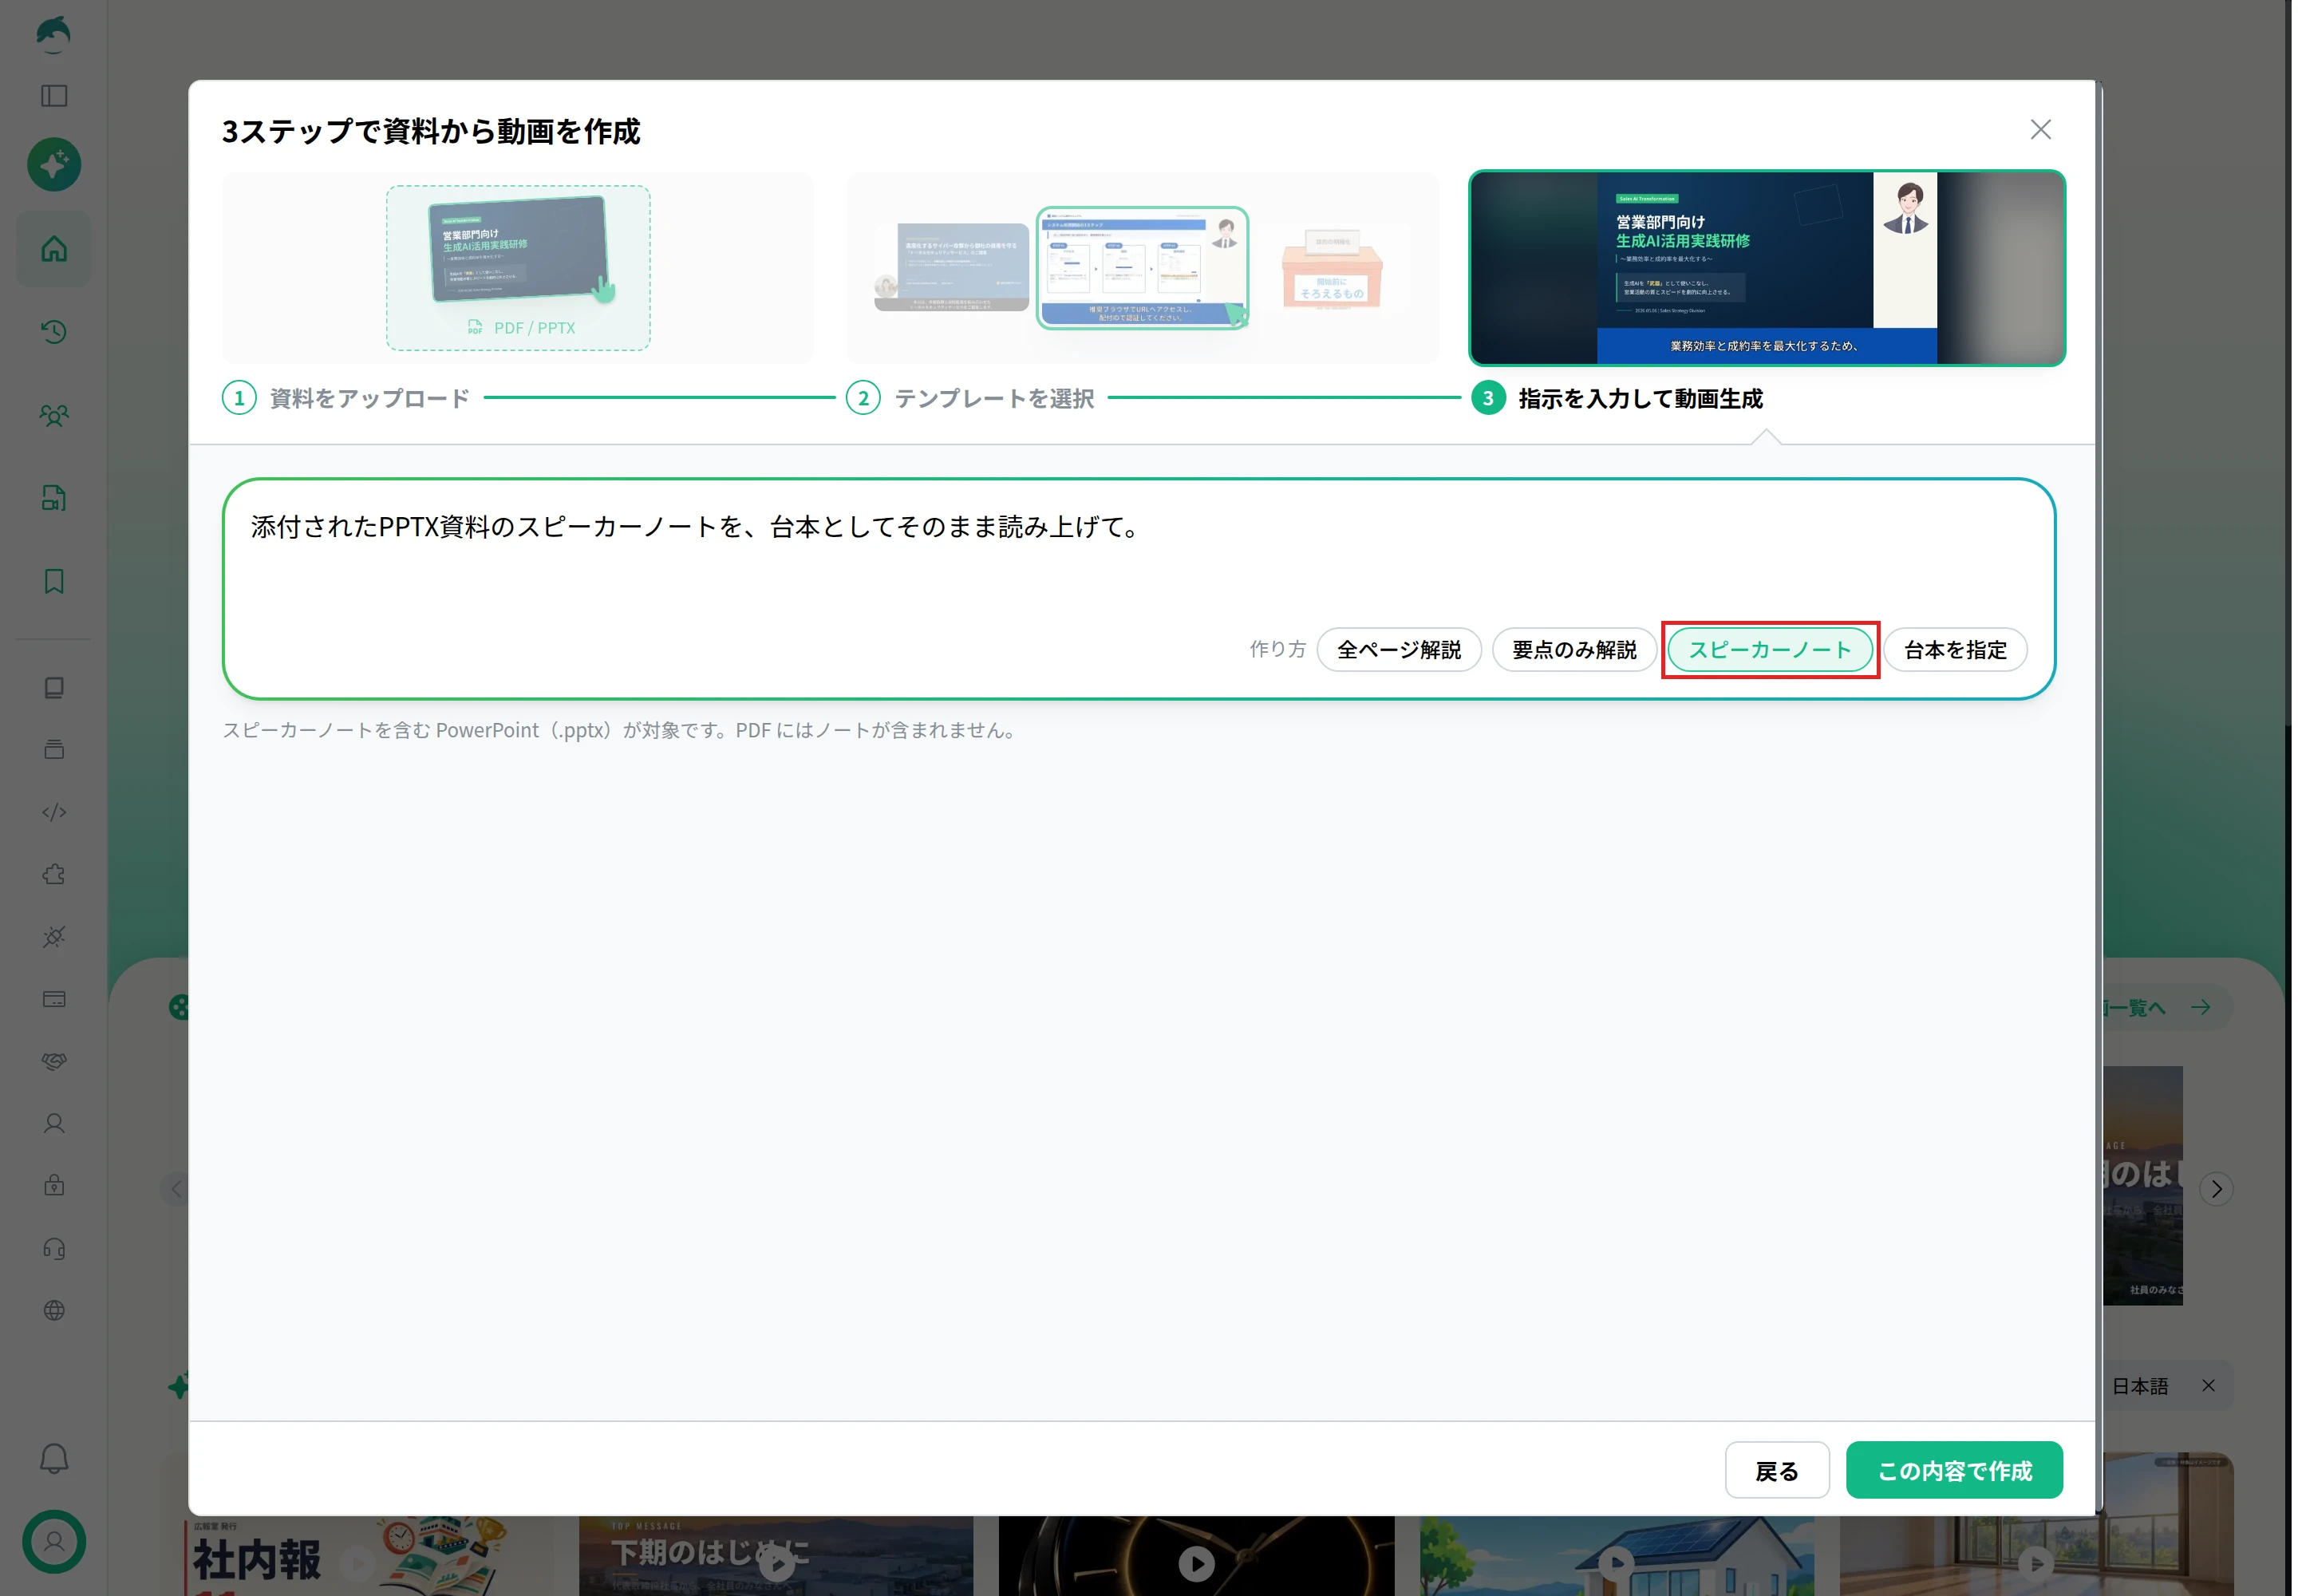
「この内容で作成」を押すと、ホームの入力欄に資料と指示が入ります。
ノートの原稿をすべて読み上げるため、動画の長さは「おまかせ」にして、右の矢印のボタンを押します。
長さが「30秒」などのまま送ったときは、確認の画面で「動画の長さをおまかせにして生成」を選びます。
作例:AIデータセンターの勉強会のスライドから作った動画
この記事の内容をもとに、AIデータセンターとAI半導体の基本を説明する社内勉強会のスライド(7枚、ノート付きのPPTX)を作り、上の手順で動画にしました。
スライドは、表紙のあとに、従来のデータセンターとの違い、AIサーバーのラックの中身、AI半導体の4つの種類、電力の見通し、日本のAIデータセンター、まとめが続き、動画の長さは3分9秒になりました。
入力した3枚目のスライド(AIサーバーのラックの中身)です。
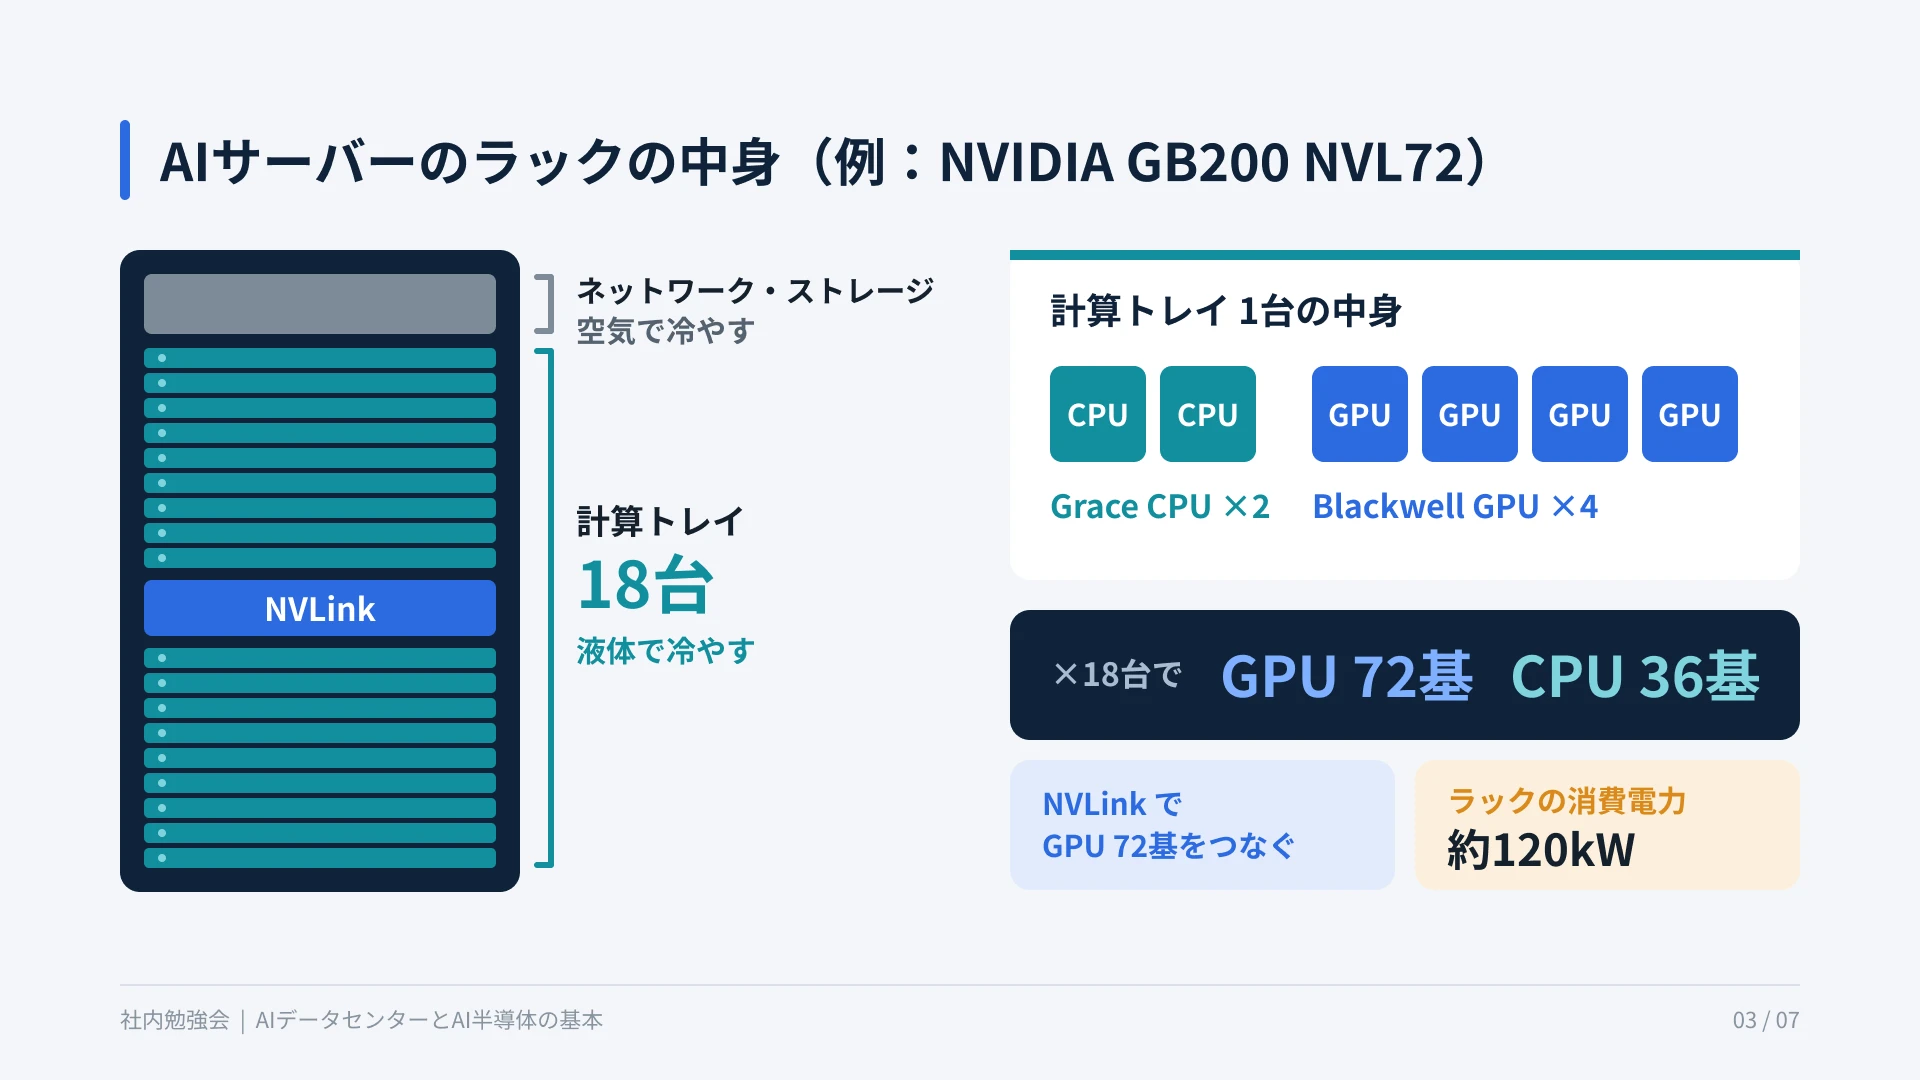
このスライドのノートには、次の原稿を書きました(一部)。
ラック1台には計算トレイが18台入っていて、1台のトレイに、Grace CPUが2基と、Blackwell GPUが4基載っています。
合わせると、GPUが72基、CPUが36基で、この72基のGPUをNVLinkでつなぎます。
計算トレイは液体で、ネットワークとストレージは空気で冷やし、ラックの消費電力は約120キロワットです。
NoLangで作った動画の、同じスライドの場面です。
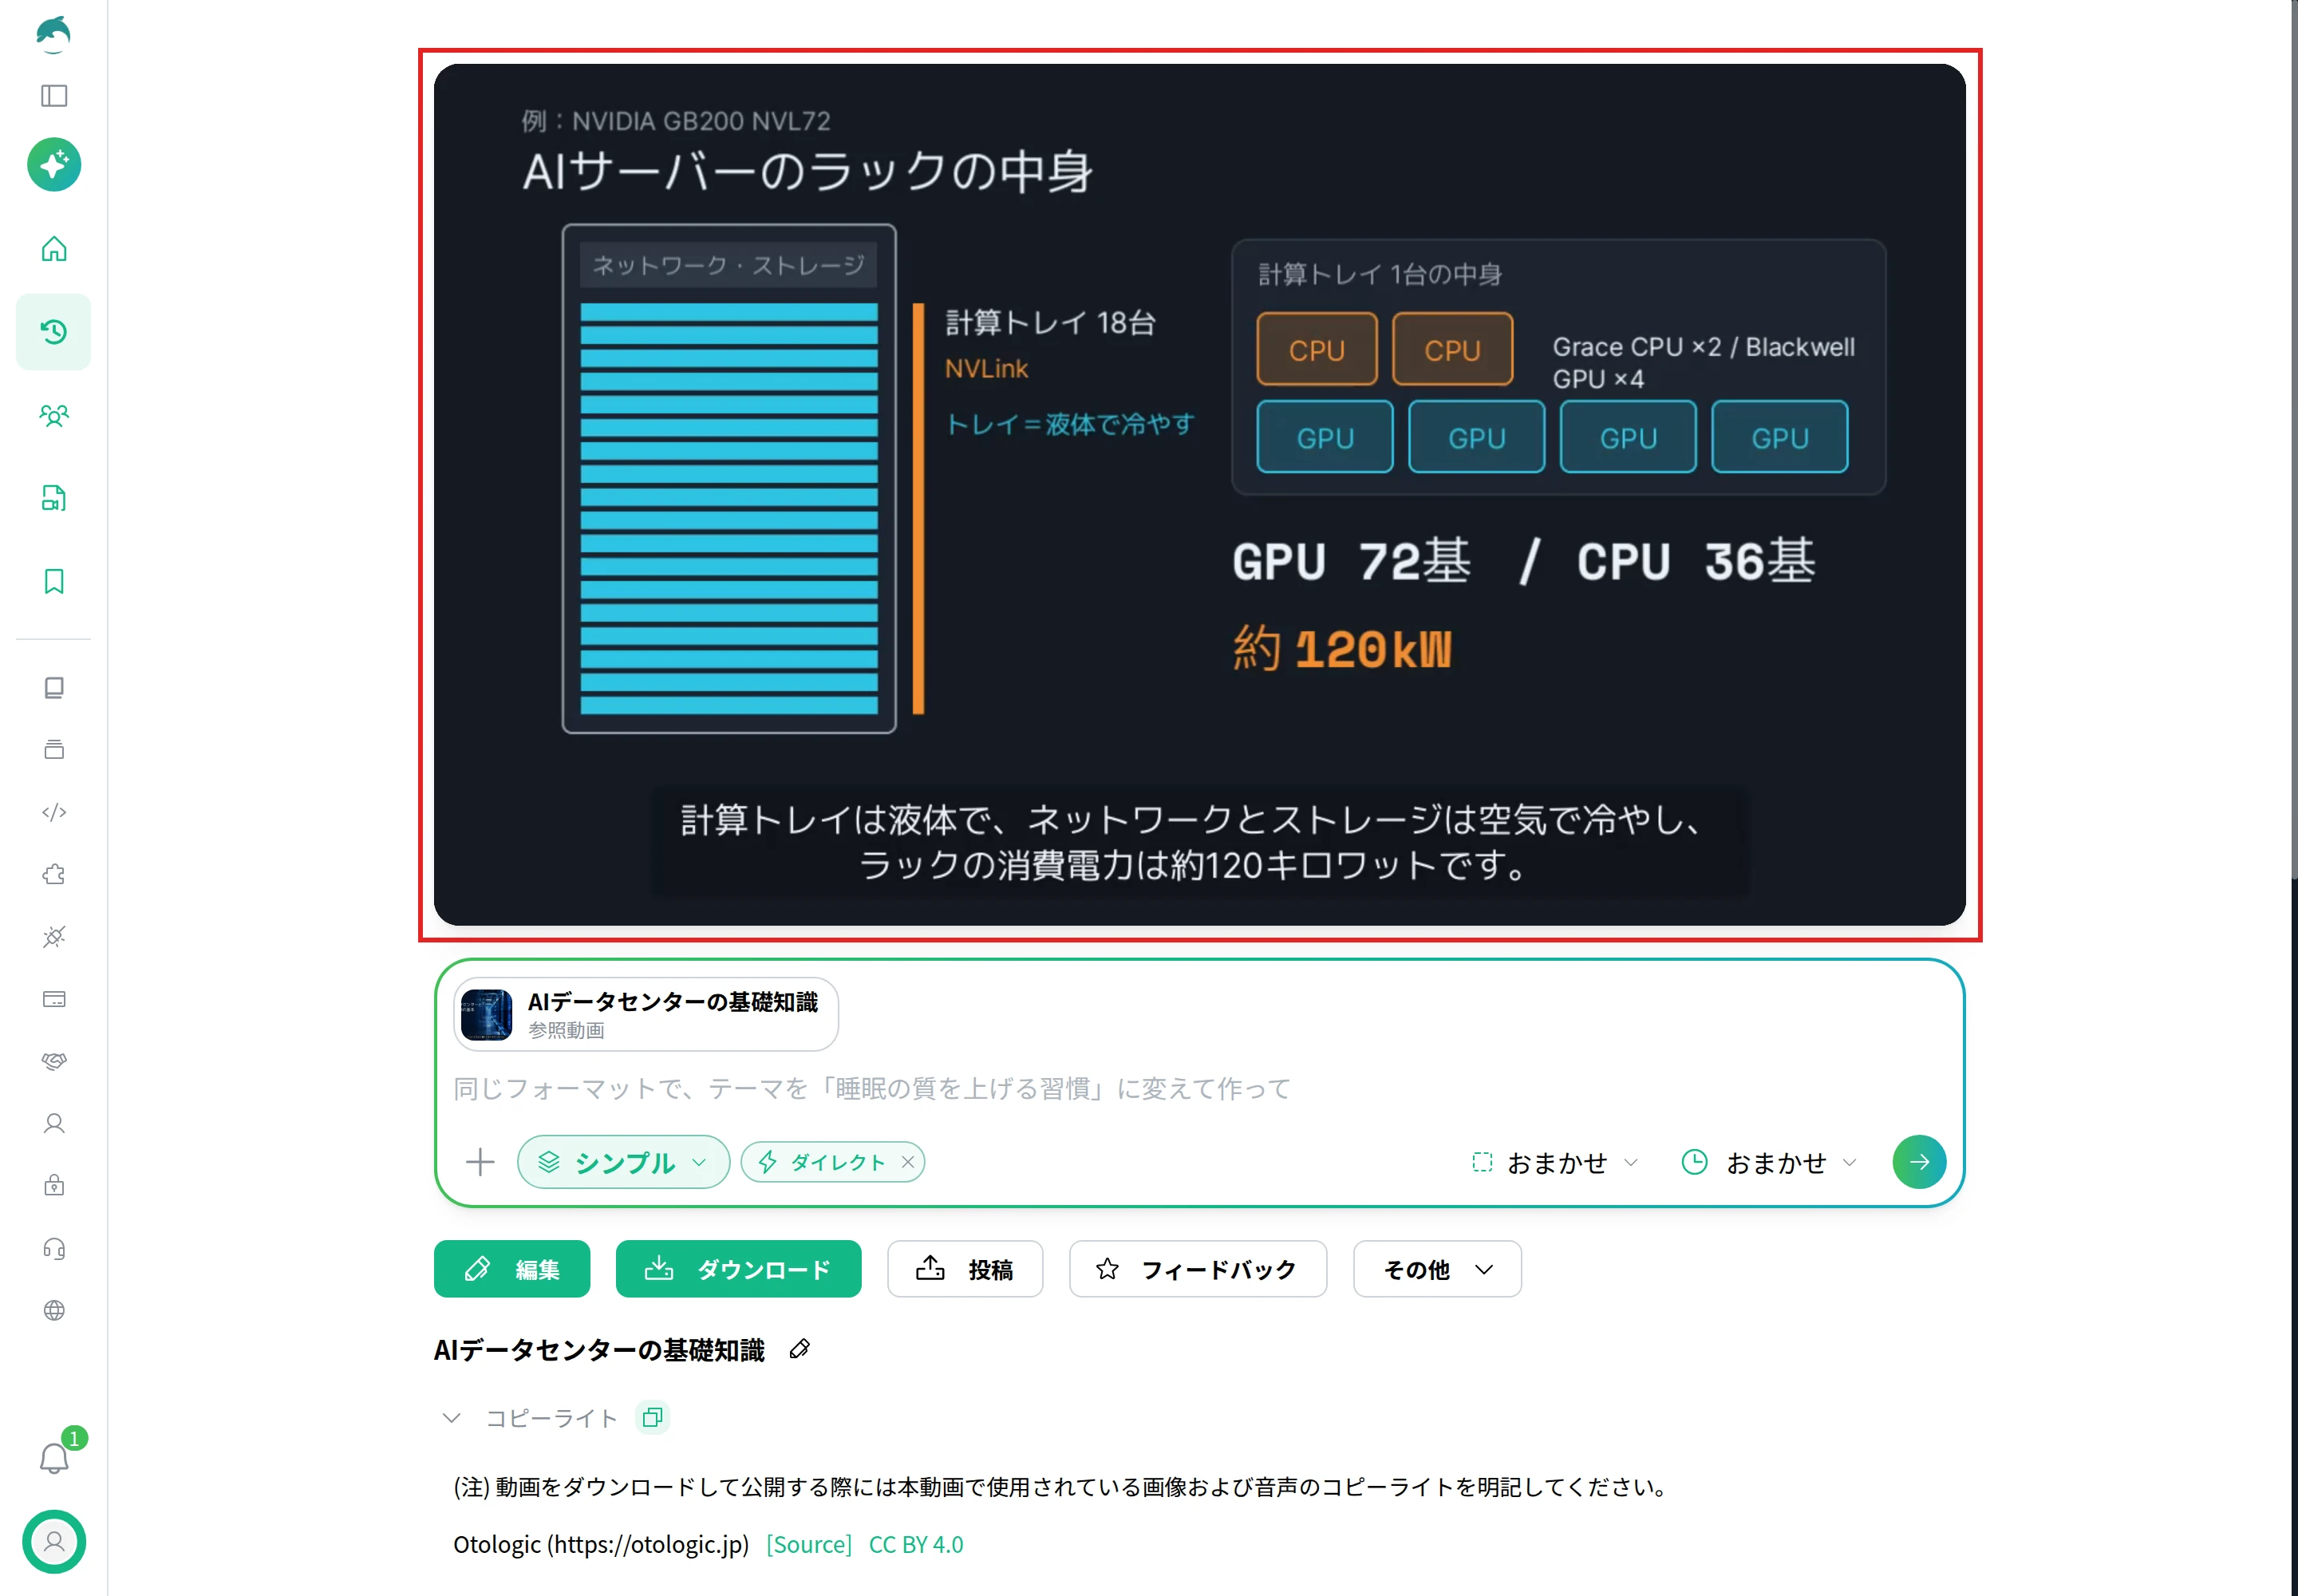
スライドの図は暗い背景の場面に組み直され、トレイ18台、GPU 72基とCPU 36基、約120kWの数字はそのまま入っています。
7枚のスライドは1枚ずつ7つの場面になり、ノートの原稿が読み上げの台本と字幕になりました。
スライドを動画にする方法は、パワーポイントを動画にする機能のページでも紹介しています。
会社でAIの勉強会や研修の動画を作るとき
会社でNoLangを使えば、AIや新しい技術の勉強会のスライドとノートの原稿から、社員が好きなときに見られる解説動画を作れます。
研修の動画を会社で作る方法は法人向けの研修動画のページで紹介しており、詳しい使い方はお問い合わせから相談できます。
法人向けの資料は、下のボタンから請求できます。
資料をダウンロード